Как устроен суперкомпьютер Илона Маска Colossus: 100 000 GPU и серверы Supermicro
Сто тысяч графических процессоров — цифра, которую трудно представить. Но самое интересное в суперкомпьютере Илона Маска не их количество. Как заставить тысячи серверов работать над обучением одной нейросети, передавать данные без постоянных задержек и отводить выделяемое тепло?
Colossus — вычислительный кластер компании xAI в Мемфисе, созданный для обучения моделей Grok. В его первой конфигурации использовались 100 000 ускорителей NVIDIA H100. Покажем, какую роль в этой инфраструктуре играют жидкостное охлаждение и серверы Supermicro. Разберём устройство системы и то, какие её принципы полезны даже компании, которой нужен всего один сервер для ИИ.
(О какой версии Colossus идёт речь? Число 100 000 относится к 2024 году. На странице проекта xAI расширение до 200 000 GPU датируется февралем 2025 года. Ниже — разбор первой архитектуры, а далее в следующих статьях мы разберём все новейшие модификации)
Зачем Grok понадобился суперкомпьютер
Обучение большой языковой модели отличается от обычного запроса к чат-боту. Во время обучения система обрабатывает примеры и изменяет параметры нейросети. При инференсе — использовании готовой модели — она рассчитывает ответ на новый запрос. Это разные режимы работы с разными требованиями к вычислениям и памяти.
Крупную обучающую задачу распределяют между ускорителями: они обрабатывают части данных или модели и обмениваются промежуточными результатами. Поэтому кластер нельзя оценивать только по количеству GPU. Если вычислители регулярно ждут друг друга, дисковую подсистему или сеть, часть дорогого оборудования простаивает.
Назначение Colossus для обучения семейства Grok подтверждает NVIDIA в сообщении от 28 октября 2024 года. Там же указаны сроки: 122 дня на создание комплекса и 19 дней от установки первой стойки до начала обучения. Это результат конкретного проекта, а не универсальный срок строительства ИИ-ЦОД.
Из чего складываются 100 000 GPU: сервер, стойка, группа стоек
В показанной части Colossus используются жидкостно охлаждаемые системы Supermicro 4U Universal GPU. В одном таком сервере установлено восемь NVIDIA H100. Восемь серверов образуют вычислительную стойку с 64 ускорителями, а восемь стоек — группу с 512 GPU. Эту компоновку описывает Патрик Кеннеди.
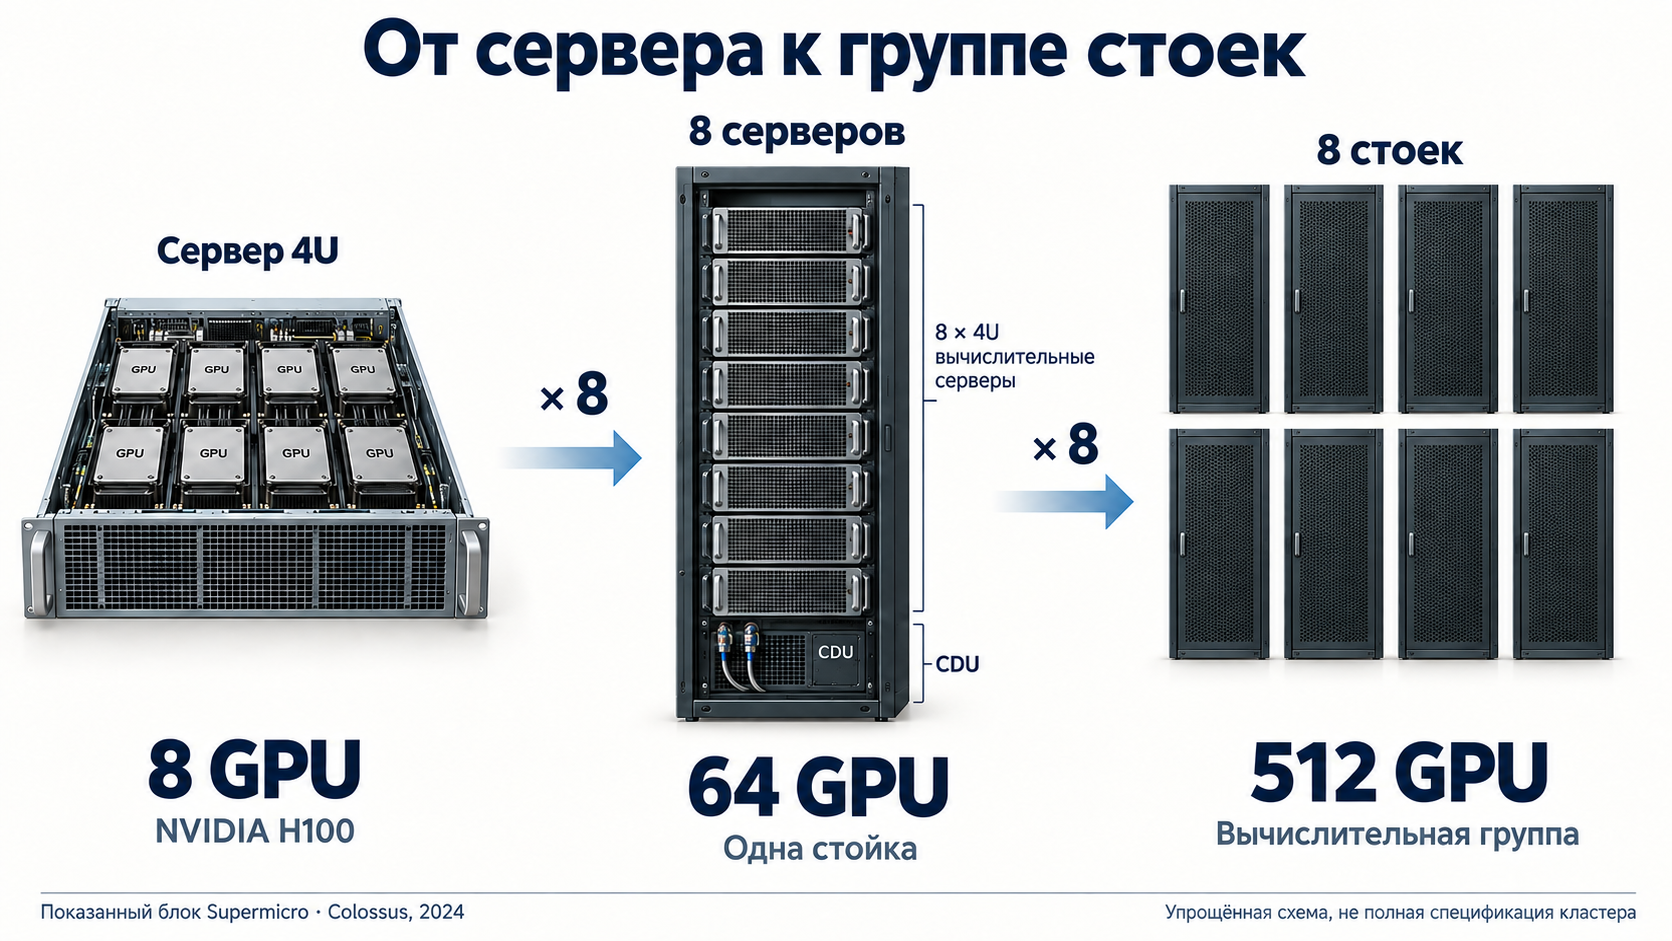
| Уровень | Состав | Количество GPU |
|---|---|---|
| Сервер 4U | Восемь ускорителей NVIDIA H100 | 8 |
| Вычислительная стойка | Восемь GPU-серверов, CDU и сопутствующее оборудование | 64 |
| Группа стоек | Восемь вычислительных стоек с сетевой инфраструктурой | 512 |
Таблица объясняет устройство показанного блока, но не является полной спецификацией Colossus. Из неё нельзя заключать, что все стойки комплекса одинаковы или что всё оборудование поставил один производитель.
С инженерной точки зрения повторяемая компоновка упрощает масштабирование: можно заранее согласовать размещение серверов, подключение питания, кабельные трассы и охлаждение. При этом простое добавление стоек ещё не гарантирует пропорционального ускорения обучения — важна работа всей системы.
Почему быстрая сеть здесь не менее важна, чем GPU
У обмена данными есть два уровня. Внутри восьмиускорительного NVIDIA HGX H100 используются NVLink и NVSwitch — высокоскоростные соединения между GPU. Их устройство описано в техническом материале NVIDIA. Между серверами Colossus работает другая инфраструктура: Ethernet-платформа NVIDIA Spectrum-X с BlueField-3 SuperNIC.
Это принципиальное различие. Сто тысяч ускорителей не соединены одной общей шиной NVLink, а их память не превращается автоматически в единый объём, доступный любой программе без изменений. Распределять модель и организовывать обмен должна программная среда.
В обзоре экспертов показаны подключения 400GbE и разделение сетей для обмена между GPU, остальных задач кластера и управления. Для GPU используется RDMA — механизм удалённого доступа к памяти, который сокращает участие центрального процессора в передаче данных.
Представьте команду инженеров, работающих над одним чертежом. Если каждый считает быстро, но пересылает результаты через медленный канал, команда будет ждать передачи файлов. В распределённом обучении такая задержка может повторяться на каждом шаге. Поэтому выбирать GPU, сетевые адаптеры и коммутаторы нужно как части одной архитектуры.
Как охладить такую систему — и почему вентиляторы остаются
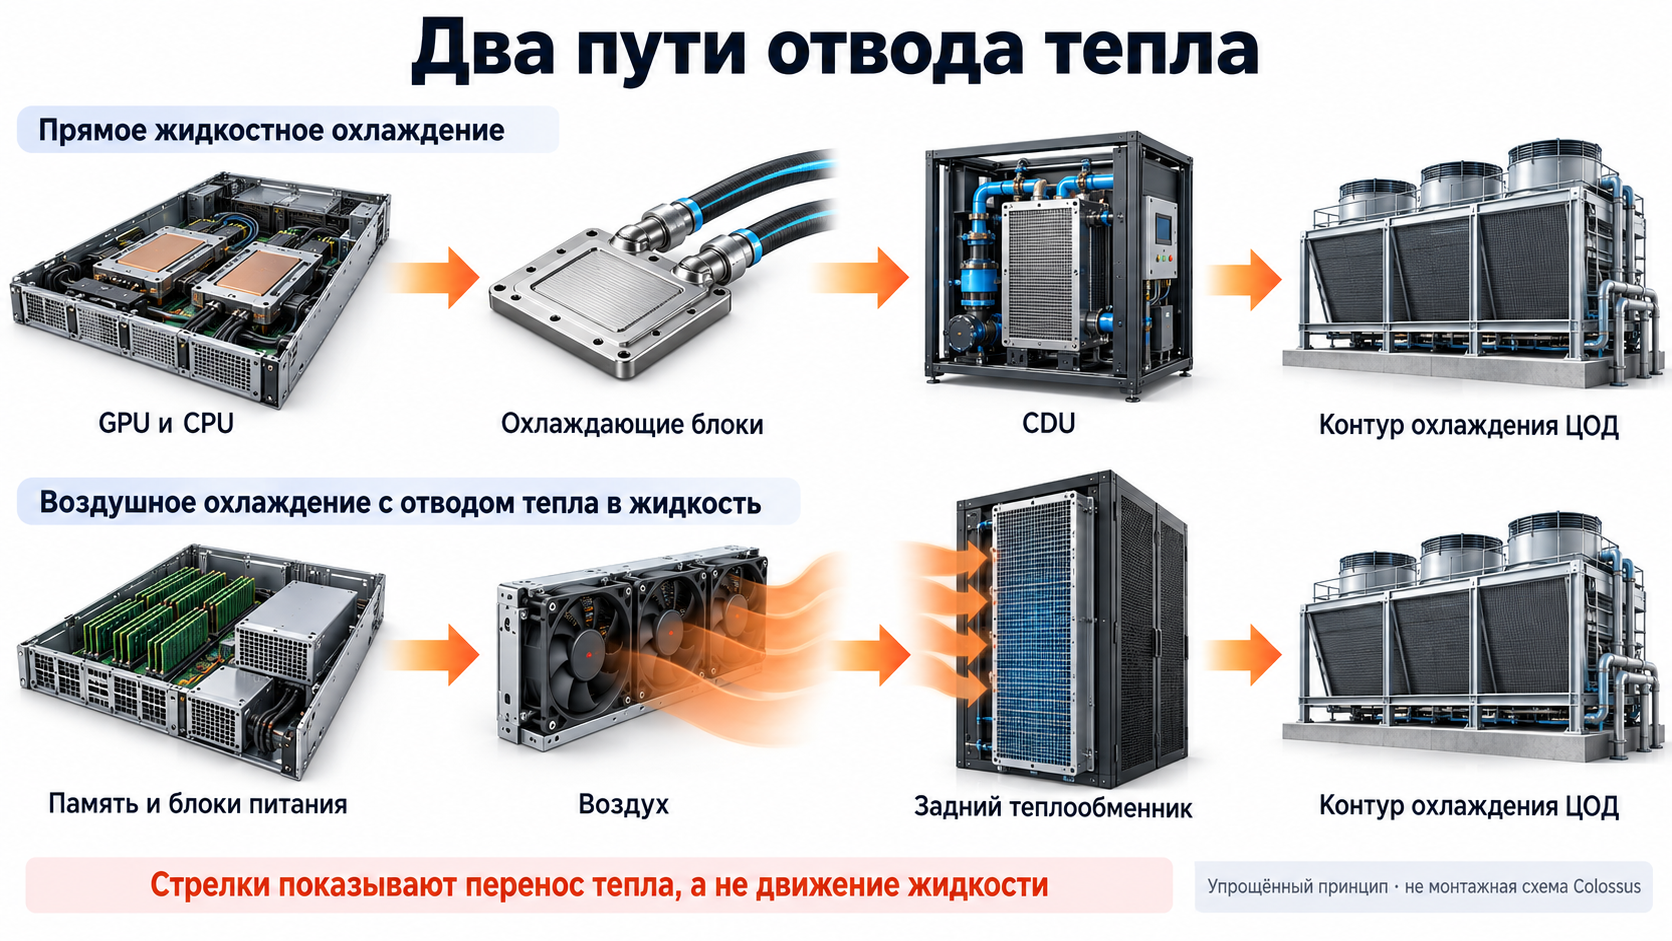
В жидкостном охлаждении Colossus тепло от горячих компонентов принимают охлаждающие блоки. Далее оно переносится теплоносителем к CDU — узлу распределения охлаждающей жидкости, связывающему серверный контур с охлаждением площадки. В показанных стойках CDU имеет резервируемые насосы и блоки питания. Устройство контуров и стоек мы разберём в следующей статье.
Но жидкость не отменяет воздушное охлаждение. Вентиляторы продолжают отводить тепло от памяти, блоков питания и других компонентов. Нагретый воздух проходит через теплообменник на задней двери стойки, который передаёт тепло жидкостному контуру. Так работают два взаимодополняющих пути отвода тепла.
Это не погружение серверов в ванну и не подключение оборудования к обычному водопроводу. Для конкретной системы нужно согласовать состав теплоносителя, совместимость материалов, расход, давление, контроль утечек и обслуживание. Ошибка в этих условиях способна ограничить работу даже правильно подобранного сервера.
Полезный вывод: проектировать охлаждение надо до закупки ускорителей. Наличие свободных мест в стойке ещё не означает, что туда можно установить мощную GPU-систему.
70 МВт только на GPU? Считаем без преувеличений
В спецификации NVIDIA H100 SXM указан настраиваемый TDP до 700 Вт. Если для наглядности принять 700 Вт на каждый из 100 000 ускорителей, получится:
100 000 × 700 Вт = 70 000 000 Вт = 70 МВт.
Это расчёт по верхнему значению TDP, а не измеренное потребление Colossus. Он не включает CPU, память, накопители, сеть, потери преобразования питания и оборудование охлаждения. Реальная мощность зависит от конфигурации, лимитов и выполняемой задачи. Смешивать эту оценку с фактическим показанием счётчика ЦОД нельзя.
Есть и менее очевидная проблема: нагрузка меняется во времени. По наблюдениям, накопители энергии Tesla Megapack применялись для сглаживания быстрых колебаний мощности. Они не создают электричество и не заменяют источник энергоснабжения: их задача в этом объяснении — буфер между меняющейся нагрузкой и питающей инфраструктурой.
Без хранилища и обычных процессоров GPU не справятся
В экскурсии видны не только GPU-стойки, но и CPU-серверы, а также узлы хранения Supermicro с NVMe-накопителями. У этих систем свои задачи: подготовка данных, обслуживание вычислительной среды и работа с хранилищем.
При обучении нужно не только читать датасет, но и сохранять контрольные точки — состояние модели и связанной с обучением среды. Они позволяют продолжить работу после остановки, не повторяя весь процесс с начала. Скорость чтения данных и записи контрольных точек поэтому влияет на полезную загрузку ускорителей.
Для собственного проекта систему хранения Supermicro следует подбирать не только по ёмкости. Важно оценить параллельный доступ, характер файлов, требуемую пропускную способность, резервирование и время восстановления. Универсальной нормы «столько-то терабайт на один GPU» здесь недостаточно.
Что из опыта Colossus полезно обычной компании
Покупка оборудования «как у Маска» сама по себе не решает бизнес-задачу. Обучение большой модели с нуля, её дообучение и запуск готового ИИ-помощника требуют разного масштаба ресурсов. Начинать стоит с нагрузки, а не с максимального количества ускорителей.
- Определите сценарий. Что требуется: обучение, дообучение, инференс, работа с изображениями или поиск по корпоративным документам?
- Опишите требования к памяти и скорости. Важны размер модели, формат вычислений, длина контекста, число одновременных запросов и допустимое время ответа.
- Проверьте весь путь данных. Если нужны несколько серверов, заранее оцените обмен между ними, доступ к хранилищу и совместимость программного стека.
- Согласуйте условия площадки. Электропитание, глубина и нагрузка на стойку, охлаждение и доступ для обслуживания должны соответствовать выбранной конфигурации.
- Задайте критерии приёмки. Проверять нужно свою модель и характерную нагрузку: скорость, стабильность, энергопотребление и восстановление после отказа.
Для первичного выбора доступны GPU-серверы Supermicro. Если задача связана с корпоративной базой знаний, следующий полезный материал — разбор архитектуры Agentic RAG на Supermicro. Это отдельный сценарий, а не уменьшенная копия обучающего кластера xAI.
Чтобы перейти от общей идеи к конфигурации, запросите коммерческое предложение под вашу ИИ-задачу. Укажите модель или тип нагрузки, требования к памяти и производительности, условия размещения и план расширения. Так сравнение оборудования будет опираться на реальные ограничения проекта.
Главный урок суперкомпьютера Илона Маска
Colossus показывает, что вычислительная мощность — результат совместной работы ускорителей, серверов, сети, хранения, электропитания, охлаждения и программного обеспечения. На масштабе 100 000 GPU слабое место любого из этих компонентов становится проблемой всей системы.
Тот же принцип действует при выборе одного сервера: ценность имеет не рекордное число в спецификации, а способность конфигурации стабильно выполнять вашу задачу. Именно поэтому историю Colossus интересно читать не только как рассказ о большом проекте Маска, но и как урок проектирования ИИ-инфраструктуры.
