HGX Rubin NVL8 или Vera Rubin NVL72: какую архитектуру Supermicro выбрать
HGX Rubin NVL8 и Vera Rubin NVL72 основаны на GPU Rubin, но задают разный масштаб системы. В первом случае базовая единица — сервер с восемью GPU. Во втором — стойка, объединяющая 72 Rubin GPU и 36 Vera CPU. От этой разницы зависят размещение модели, межсерверный обмен, программная совместимость и порядок ввода площадки в эксплуатацию.
На стенде Supermicro на GTC Berlin в октябре 2026 года рядом демонстрировались Rubin NVL8, Vera Rubin NVL72, Ethernet-оборудование Spectrum-X и другие системы для ИИ. Такой набор удобен для разбора: он показывает несколько ролей инфраструктуры, которые легко ошибочно объединить в одну строку «GPU-сервер». Основной выбор здесь — между серверным и стоечным вычислительным доменом.
Что показали на GTC Berlin и как связаны эти системы
В коротком обходе стенда ведущий Supermicro начал со слов: «Я хочу показать несколько систем, которые у нас здесь представлены» (перевод с английского). Дальше он последовательно перешёл от Arm-системы и сетевого коммутатора к стойке Vera Rubin, CPU-компонентам, HGX Rubin NVL8 и жидкостному варианту с восемью RTX PRO. Это разные аппаратные направления; переносить характеристики одного на остальные нельзя.
Выставочная демонстрация позволяет понять архитектуру, но не устанавливает комплект коммерческой поставки. Точные артикулы, поддержанные CPU, сетевые адаптеры, охлаждение и версии ПО фиксируют для конкретного заказа. Похожее название шасси не доказывает взаимозаменяемость платформ.
| Часть инфраструктуры | Практическая роль | Что она не заменяет |
|---|---|---|
| HGX Rubin NVL8 | Вычислительный узел с восемью GPU | Межсерверную сеть для распределённой работы нескольких узлов |
| Vera Rubin NVL72 | Стоечный домен на 72 GPU с Vera CPU | Хранилище, внешнюю фабрику и готовность здания |
| Spectrum-X Ethernet | Сетевую инфраструктуру с согласованными компонентами | Внутреннюю NVLink-связность выбранной GPU-платформы |
| Vera CPU и Arm-системы | CPU-часть платформы и соответствующие вычислительные задачи | GPU-память и поддержку произвольного x86-бинарного ПО |
| Системы с RTX PRO | Другой класс ускоряемых приложений и конфигураций | Гарантированную эквивалентность HGX Rubin по памяти и обмену |
Общий обзор DCBBS, Helios и анонсов предыдущей выставки уже есть в статье о Supermicro на Computex 2026. Здесь выбор сужен до вычислительного домена Rubin, перехода на Arm и проверок, которые позволяют сравнить NVL8 с NVL72 для одной нагрузки.
Почему девять NVL8 не равны одной NVL72
В обоих вариантах можно получить 72 GPU: 9 × 8 = 72. Но количество одинаково только арифметически. Девять NVL8 остаются отдельными восьмиускорительными доменами; обмен между серверами проходит по внешней фабрике. В NVL72 ускорители объединены стоечной NVLink-инфраструктурой. Приложению доступны разные пути обмена, и распределение работы должно это учитывать.
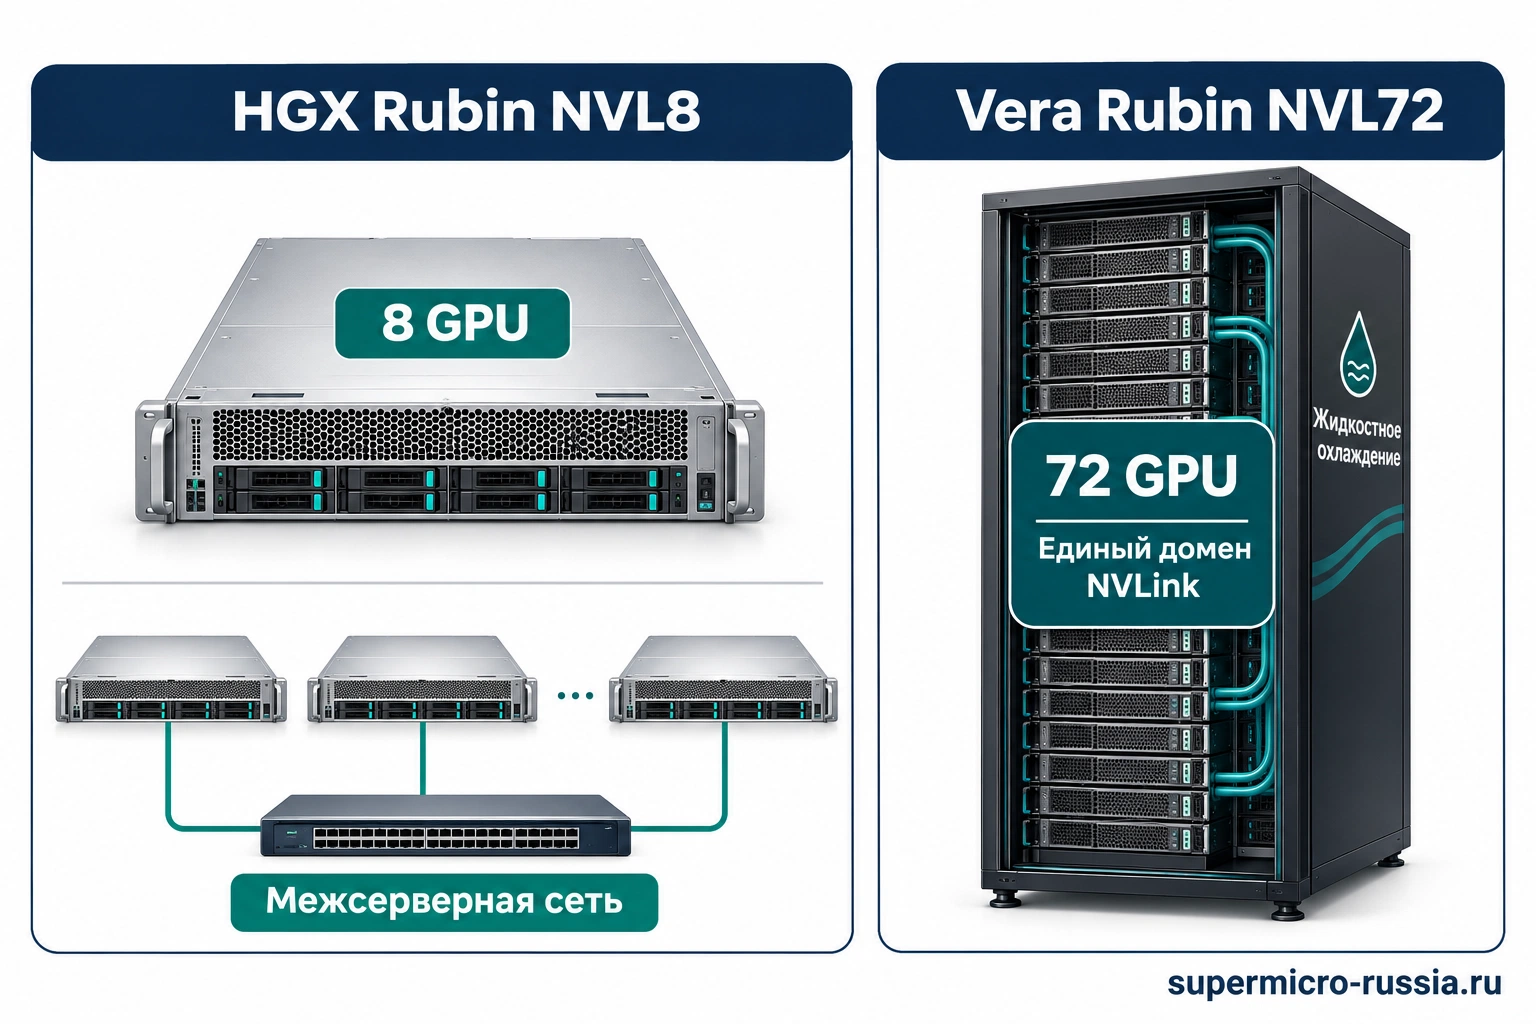
Для независимых моделей это различие может быть малозаметным: каждый экземпляр работает на своей группе. Для tensor parallelism, маршрутизации экспертов MoE или частых коллективных операций оно способно определять общую скорость. Однако стоечная связность не гарантирует выигрыш каждой модели. Если задержка возникает в CPU, загрузке данных или очереди, более широкий NVLink-домен может остаться недоиспользованным.
| Вопрос | Несколько HGX Rubin NVL8 | Vera Rubin NVL72 |
|---|---|---|
| Базовый масштаб | 8 GPU на систему | 72 GPU и 36 Vera CPU на стойку |
| Рост числа ускорителей | Добавление систем и внешней сети | Развёртывание стоечных систем и их объединение |
| Критическая граница обмена | Выход за пределы восьми GPU узла | Выход за пределы стоечного домена |
| Разделение заданий | Удобно привязывать группы к отдельным серверам | Требует политики размещения внутри общего ресурса |
| Что особенно важно проверить | Межузловое масштабирование | Программное использование большого NVLink-домена |
При сравнении надо сохранить одну модель, точность, длину последовательности, объём работы и целевое качество. Сопоставление максимальных FLOPS двух рекламных таблиц не показывает, как будет работать приложение. Особенно опасно сравнивать разреженную производительность одного формата с плотной производительностью другого.
Когда выбирать NVL8, а когда проверять NVL72
NVL8 логично оценивать для поэтапного роста и набора независимых задач, которые укладываются в восемь GPU или приемлемо масштабируются между узлами. NVL72 имеет смысл испытывать, когда нагрузке нужен большой тесно связанный домен, а площадка готова принять интегрированную стойку. Выбор подтверждают пилотом с целевыми ограничениями задержки и стоимости.
Несколько независимых сервисов
Допустим, три команды используют по восемь GPU, а каждый сервис помещается в свой узел. Начальный объём — 24 GPU, то есть три NVL8. Покупка 72 GPU под такую постоянную нагрузку означает использование только трети доступного количества, если остальные задачи не найдены. Общая стойка может быть оправдана подтверждённым планом роста или объединением очередей, но это должно быть частью расчёта загрузки.
Одна крупная распределённая модель
Если задача использует 64 GPU, её можно размещать на восьми восьмиускорительных системах и проверять цену межузлового обмена. Альтернатива — группа внутри NVL72. Здесь сравнивают скорость полезной работы, память на участника и хвостовые задержки. Оставшиеся восемь GPU в стойке не становятся автоматически резервом: приложение и планировщик должны уметь их использовать при заданном сценарии отказа.
Нагрузка с интенсивными CPU-инструментами
Агентная система может вызывать поиск, исполнять код, обращаться к базам и запускать внешние инструменты. Если эти этапы тормозят обработку, увеличение GPU не устранит очередь. Требуются отдельные измерения CPU, памяти, хранилища и времени внешних вызовов. CPU-системы на стенде показывают роль такого слоя, однако число CPU-узлов выводят из нагрузки приложения.
Как проверить память модели до выбора масштаба
Нижняя оценка памяти весов: W = число параметров × байт на параметр. Условная модель на 400 млрд параметров в BF16 требует около 800 ГБ только для весов. При идеальном равномерном делении на восемь GPU это по 100 ГБ на GPU; на 16 — по 50 ГБ. Это математическая нижняя граница, которая не учитывает состояние исполнения и не подтверждает поддержку такого деления выбранным движком.
Для инференса к весам добавляют KV-кэш, рабочие буферы, CUDA-графы и запас под запросы. Для обучения — градиенты, оптимизатор и активации. В MoE число активных параметров влияет на вычисления, но в памяти всё равно могут потребоваться веса множества экспертов. Нельзя оценивать размещение только по активным параметрам.
Суммарная HBM стойки также не превращается в обычный RAM-пул без участия ПО. Нужно выбрать tensor, pipeline, expert или data parallelism и проверить, какие части модели где хранятся. Для обслуживания нескольких моделей бывает выгоднее уменьшить группу одной модели, чтобы оставить независимые ресурсы под остальные.
Что меняется при переходе с x86 на NVIDIA Vera CPU
Vera относится к Arm-платформе. Контейнер, собранный только для x86_64, нельзя считать готовым к работе на aarch64. Важна вся цепочка: базовый образ, Python-пакеты с нативными расширениями, библиотеки, собственные плагины, средства наблюдения и резервного копирования. Совместимость одного фреймворка не подтверждает совместимость всего приложения.
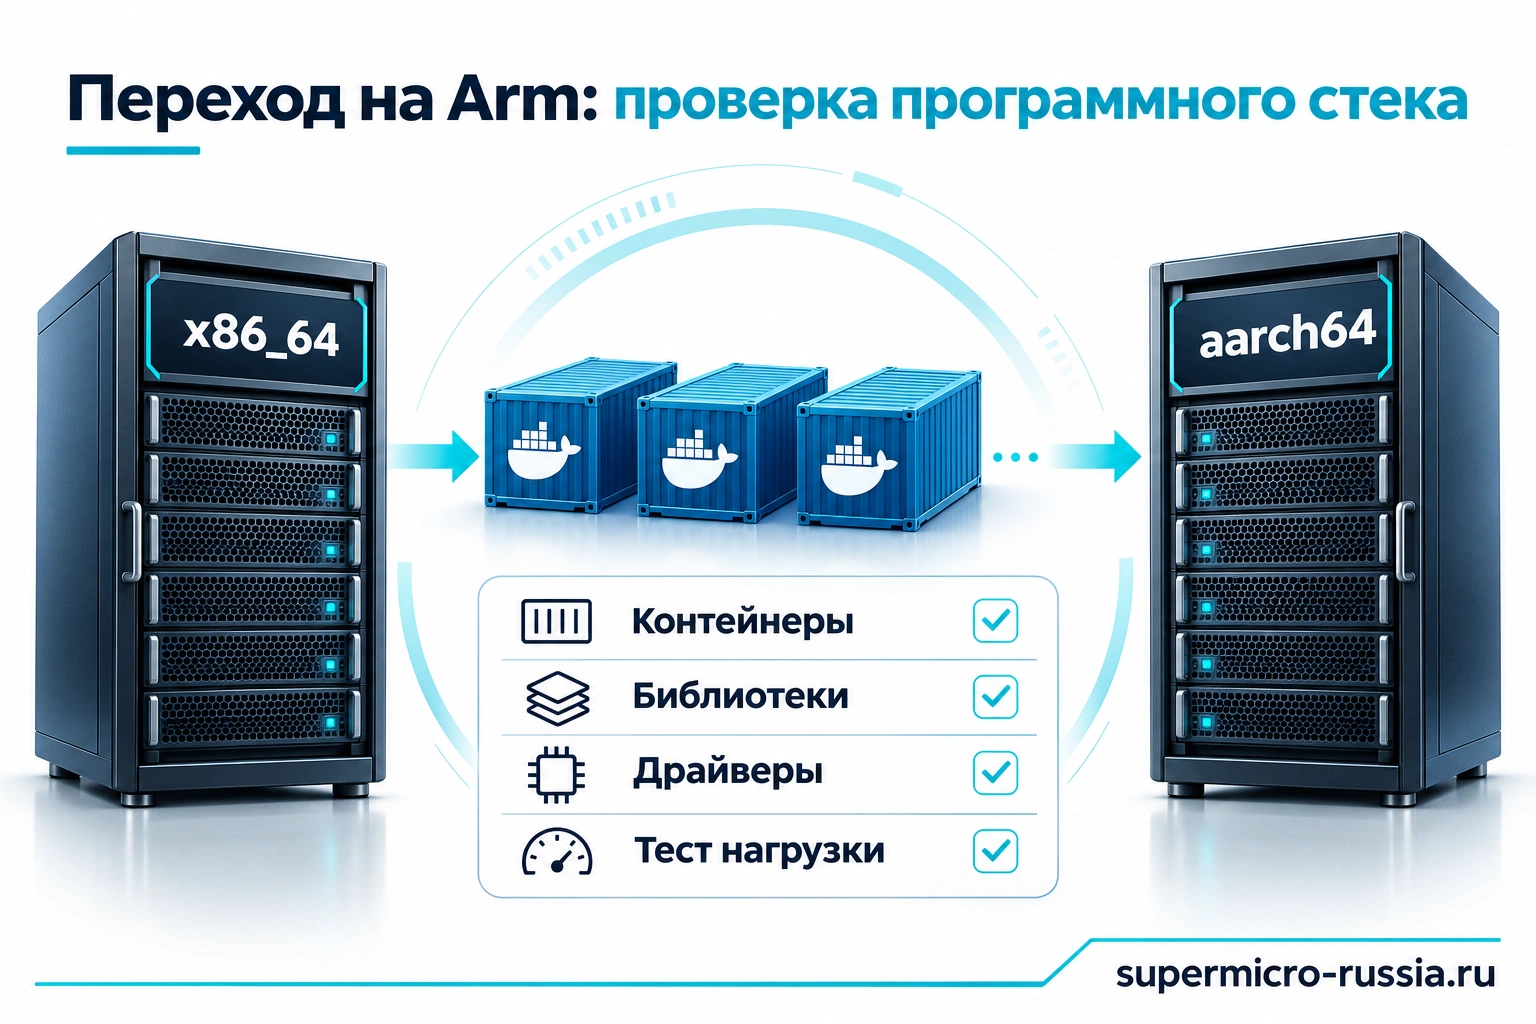
| Что переносится | Что проверить | Достаточный результат проверки |
|---|---|---|
| Контейнерный образ | Поддерживаемую архитектуру и конкретный digest | Образ получен и запускается на целевой системе |
| Python и нативные пакеты | Готовые сборки или воспроизводимую компиляцию | Импорт, функциональные тесты и реальная операция |
| CUDA и фреймворк | Матрицу версии, драйвера и GPU | Корректный расчёт и устойчивый запуск нагрузки |
| Собственные расширения | Инструкции CPU, ABI и параметры сборки | Пересборка и сравнение результатов с эталоном |
| Эксплуатационное ПО | Агенты мониторинга, безопасности, лицензии | Наблюдение, обновление и восстановление на пилоте |
Практичный перенос начинается с минимального воспроизводимого окружения: фиксируют версии и контрольные суммы моделей, затем переносят одну задачу. После проверки корректности измеряют задержку и пропускную способность. Только потом увеличивают число GPU. Иначе ошибка сборки может выглядеть как проблема новой архитектуры.
Для HGX Rubin NVL8 Supermicro предусмотрела варианты CPU-платформ, включая Vera и x86. Это направление портфеля, а не право установить произвольный CPU в выбранный сервер. Сокет, системная плата, прошивка, тепловой пакет и поддержанные конфигурации определяются точным SKU.
Какие сети и хранилище потребуются за пределами NVLink
NVLink обслуживает свою область обмена GPU. Пользовательские запросы, чтение датасета, запись результатов и управление оборудованием продолжают нуждаться в других соединениях. Поэтому даже большой стоечный домен не устраняет необходимость внешней сети и корректного подключения к данным.
Для прикидки клиентского канала 800 Гбит/с соответствуют 100 ГБ/с до накладных расходов. Два таких порта дают номинальную сумму 200 ГБ/с, но один поток или один процесс может не получить её целиком. Распределение по каналам, сетевой стек, клиент хранения и ограничения PCIe проверяют измерением.
Восемь узлов, каждый из которых одновременно читает по 10 ГБ/с, создают спрос на 80 ГБ/с полезного чтения. Если общая storage-фабрика выдаёт 50 ГБ/с, более быстрый обмен внутри вычислительной стойки этот недостаток не исправит. Профиль теста должен включать холодный старт моделей и одновременное чтение, а не только установившийся режим после прогрева кэшей.
Оборудование выбирают из серверов хранения под конкретный профиль. Хранилище датасетов, долговременные checkpoint и внешний KV-кэш могут иметь разные требования к размеру операций, задержкам и защите. Объединение этих ролей допустимо после проверки конкуренции за ресурсы.
Хватит ли обычной стойки и существующего охлаждения
Форм-фактор в U описывает высоту, но не готовность площадки. Для NVL72 проверяют габариты, массу, маршрут заноса, несущую способность пола, электропитание, жидкостный контур и обслуживание. Для компактного NVL8 перечень не становится необязательным: высокая плотность в 2U может создавать сложную тепловую и электрическую нагрузку.
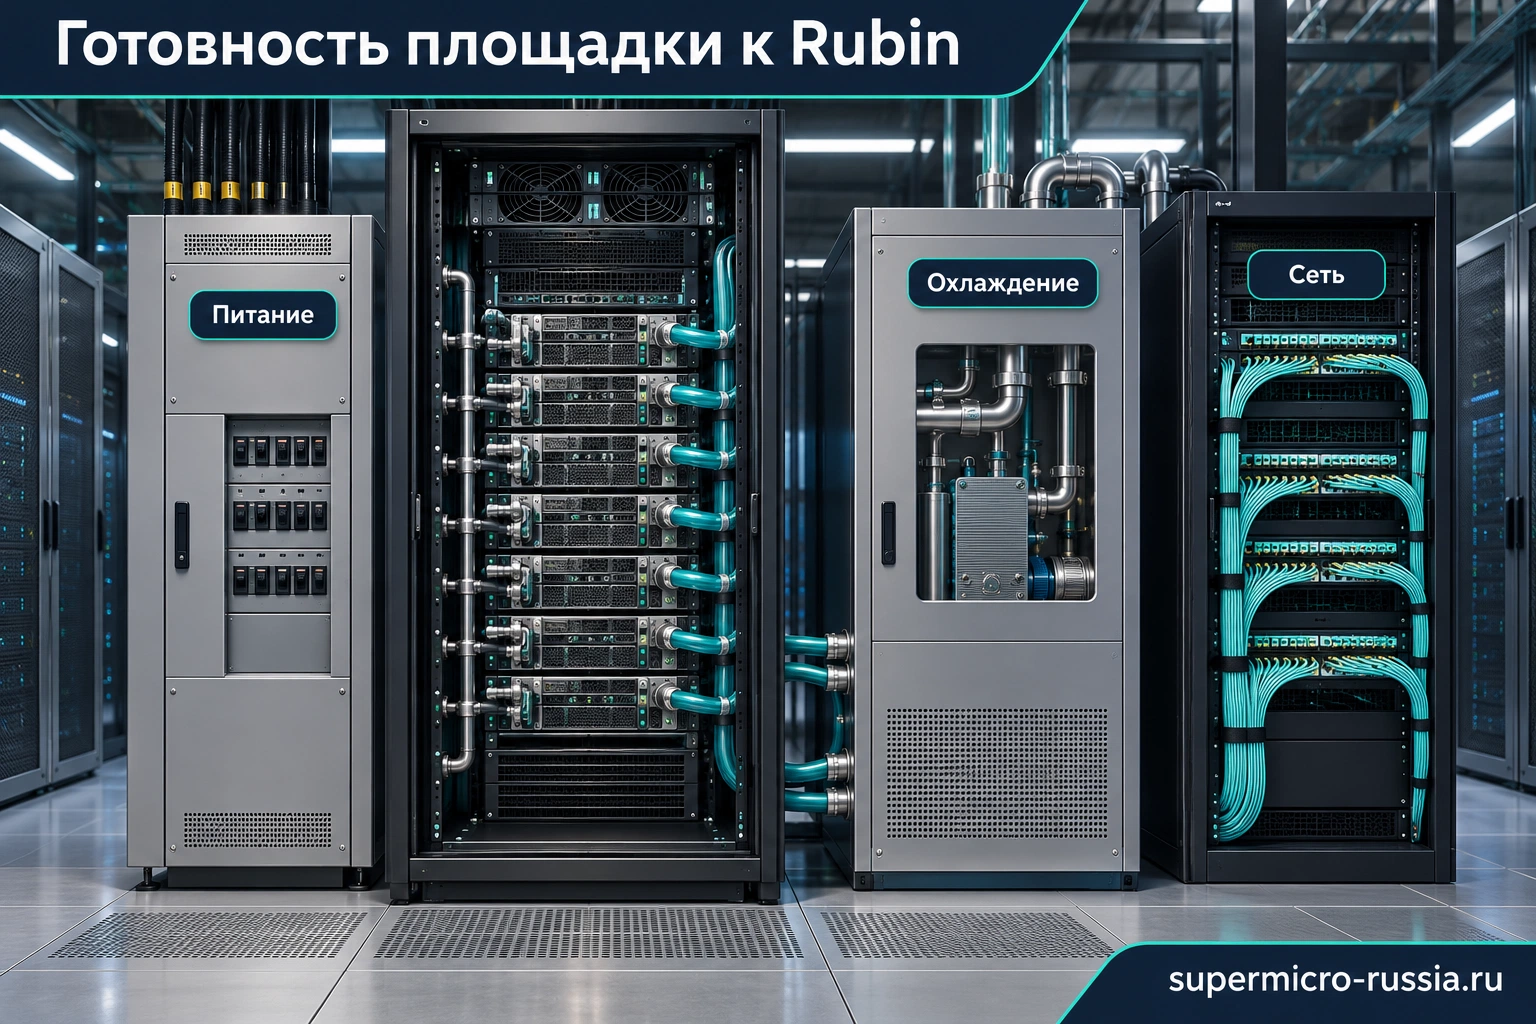
В портфеле Supermicro есть 2U HGX Rubin NVL8 с вариантами жидкостного охлаждения, включая решения отвода тепла в воздух через sidecar. L2A-система не уничтожает тепло: она передаёт его в помещение. Если зал не умеет отвести эту мощность, отсутствие водяного контура здания не решает проблему.
Рассмотрим отдельный расчётный пример, не паспортную мощность Rubin. При нагрузке комплекса 240 кВт и доле отвода в жидкость 90% в контур поступают 216 кВт, а на воздух остаются 24 кВт. При воде и ΔT = 10 °C идеализированный расход составляет около 310 л/мин. Затем учитывают свойства фактического теплоносителя, гидравлику и допустимые режимы оборудования.
Установленная мощность полок питания — предел определённой конфигурации, а не измеренное потребление стойки. В расчёте отдельно записывают рабочую нагрузку, пики, режим при отказе ввода, мощность насосов и внешнего сетевого оборудования. Резервирование должно сохраняться в согласованном режиме обслуживания, а не существовать только на схеме.
Как сравнивать стоимость полезного инференса
Стоимость токенов имеет смысл только вместе с требованиями к качеству и задержке. Быстрые ответы за пределами допустимой точности не являются полезным результатом. Также не все произведённые токены обслуживают успешные запросы: бывают отмены, тайм-ауты и повторные попытки.
Условный пример: система A выдаёт 1 млн выходных токенов в час при расходах 100 денежных единиц. Система B — 1,4 млн при расходах 130. Если все ответы соответствуют одному SLA, стоимость миллиона токенов равна 100 и примерно 92,86 соответственно. Но при доле пригодных ответов у B только 80% полезный объём составит 1,12 млн, а стоимость вырастет примерно до 116,07. Номинальная пропускная способность здесь дала бы неверный выбор.
В расходы включают амортизацию, обслуживание, лицензии, электричество и инженерную инфраструктуру. Для обучения вместо токенов ответа можно использовать стоимость завершённого запуска до одинакового качества. Сравнивать NVL8 и NVL72 стоит именно так, на нагрузке, которая соответствует будущей эксплуатации.
Как проверить переход с существующего GPU-парка
- Описать исходную нагрузку: модель, точность, входные и выходные последовательности, параллельность, метрики качества и предельные задержки.
- Зафиксировать исходный результат на нынешней системе, включая состав серверов и все версии ПО.
- Проверить перенос окружения на выбранную CPU-архитектуру и поддержку конкретного Rubin SKU.
- Провести тест одного узла или минимальной рабочей группы, затем увеличить масштаб без изменения смысла нагрузки.
- Повторить испытание при холодном кэше, фоновой нагрузке и согласованной деградации инфраструктуры.
- Проверить обновление, возврат к прежнему образу, сохранение результатов и передачу системы эксплуатационной команде.
Новый GPU-парк можно вводить отдельным пулом, направляя в него проверенные задачи. Такой подход позволяет возвращать нагрузку на прежнюю систему при программной проблеме. Смешивать поколения внутри одного синхронного задания стоит только после измерений.
Например, Supermicro SYS-822GS-NB3RT относится к HGX B300. Он может быть частью сравнения текущего Blackwell-парка с новой архитектурой, но не является Rubin NVL8 и не подразумевает установку Rubin вместо B300. Товарные предложения сравнивают по полному составу и условиям сервиса.
Вопросы, которые остаются после выбора NVL8 или NVL72
Можно ли превратить GB200 NVL72 в Vera Rubin NVL72 заменой GPU?
Рассчитывать на это как на штатный апгрейд нельзя. Различаются поколения вычислительных компонентов и их инфраструктура. Повторное использование стойки, питания, охлаждения или сети подтверждают по списку совместимых узлов и проекту переоснащения. Общие буквы NVL72 не являются подтверждением.
Нужно ли включать все 72 GPU в каждое задание?
Нет. Размер группы определяется приложением и поддержкой планировщика. Эксплуатационный проект должен описать совместное размещение задач, границы изоляции и поведение при обслуживании части системы. Большой домен не обязывает одну модель занимать весь ресурс.
Можно ли считать Spectrum-X обычным Ethernet-коммутатором?
Для проекта важен согласованный набор сетевых компонентов и настроек. Наличие Ethernet-портов на сервере ещё не подтверждает целевой режим работы всей фабрики. Проверяют адаптеры, прошивки, оптику, топологию и используемый транспорт приложения.
Подойдут ли системы с RTX PRO вместо Rubin?
Для некоторых задач — после сравнения памяти, поддерживаемого ПО и результатов пилота. Но восемь RTX PRO не эквивалентны восьми Rubin по определению. Отдельно проверяют способ связи ускорителей, масштаб одной модели и требования к точности вычислений.
Как оценить обслуживание, если вся стойка — один домен?
Нужно определить, какая часть нагрузки останется доступной при выводе конкретного узла, сетевого элемента или участка охлаждения. Затем проверить сценарий на разрешённой тестовой конфигурации. Наличие резервных компонентов и доступность приложения — разные показатели.
Означает ли стенд на выставке, что любую конфигурацию можно немедленно купить?
Нет. Возможность поставки определяется конкретной модификацией, регионом, комплектацией и сроком. В запрос включают обязательные компоненты, лицензии, услуги внедрения и критерии приёмки. Заголовок об анонсе не заменяет подтверждённую спецификацию.
Какие данные нужны для предметного выбора
Перед сравнением GPU-систем подготовьте схему приложения, результаты нынешней платформы, максимальный размер совместно работающей группы, требования к памяти и SLA. Добавьте ограничения по CPU-архитектуре, готовность питания и охлаждения, предполагаемую загрузку и сроки расширения. Тогда выбор между NVL8 и NVL72 можно обосновать измерениями, а каталог Supermicro использовать для подбора аппаратной части проекта.