Как выбрать сервер резервного копирования: объём, скорость восстановления и защита бэкапов
Сервер резервного копирования выбирают по тому, какие данные он должен вернуть, за какое время и после какого отказа. Большой дисковый массив решает только часть задачи. Если копия 10 ТБ должна восстановиться за четыре часа, всему тракту требуется около 694,4 МБ/с полезного потока ещё до учёта запуска приложения. Десятки терабайт свободного места эту скорость не заменят.
Окно ночного копирования и срок возврата приложения предъявляют разные требования к одному репозиторию. К объёму копий добавляются чтение для восстановления, удерживаемые версии и защита от удаления; затем проверяется весь путь до работающего сервиса.
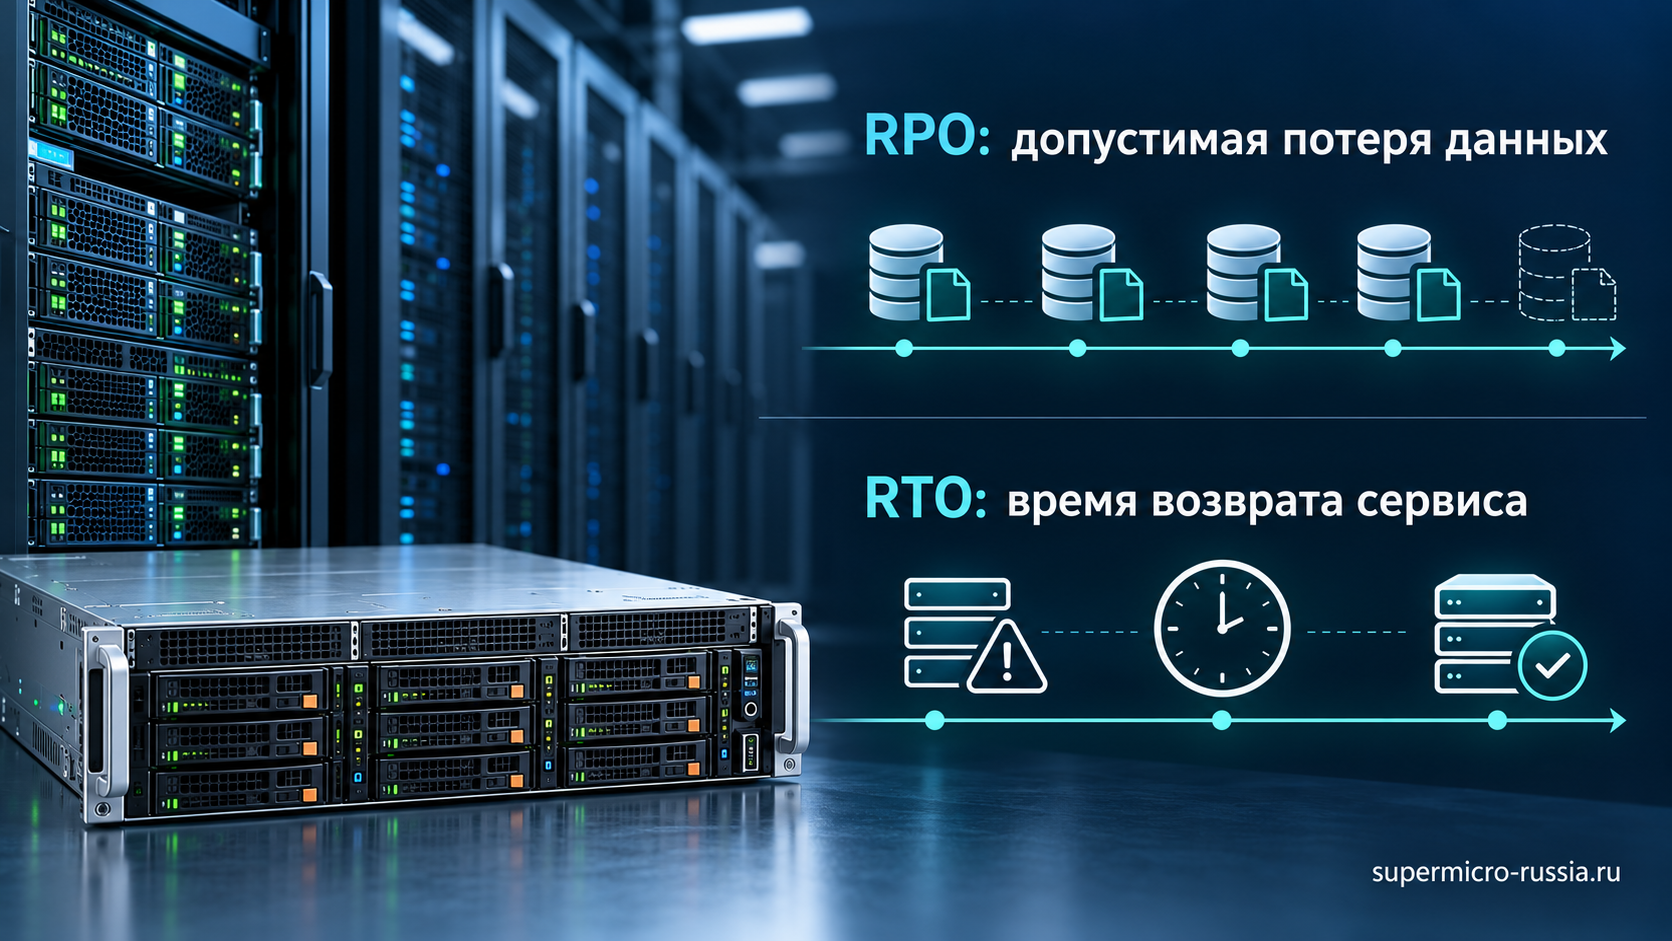
С чего начать: RPO, RTO и приоритеты восстановления
RPO описывает допустимую потерю данных во времени: насколько старой может быть последняя пригодная точка восстановления. RTO — целевой срок возврата сервиса после сбоя. Это разные требования. Ежедневная успешная копия не обеспечивает RPO 15 минут, а копирование каждые 15 минут не гарантирует запуск сервиса за 15 минут.
Для каждого приложения задают свой класс. Учётная система может требовать восстановления в течение часа, архив документов — в течение рабочего дня, тестовый стенд — позже. Приоритет задаёт порядок операций: инфраструктура доступа и имён, необходимые хранилища, СУБД, приложения и пользовательские проверки. Конкретный порядок зависит от зависимостей вашей системы.
RPO проверяют по времени последней пригодной точки восстановления. Если она датирована вчерашним днём, часовой RPO не обеспечен даже при ежечасном расписании заданий.
Какие объёмы нужны для расчёта репозитория?
Для расчёта нужны используемый объём защищаемых данных, суточные изменения, число точек, частота полных копий и долгосрочная политика. Номинальную сумму дисков в этот бюджет не подставляют.
Разделяют логический объём источника, объём прочитанного материала, переданный по сети поток и занятое пространство репозитория. Сжатие, исключения, дедупликация и пропуск пустых блоков изменяют эти величины по-разному. Уже сжатые видеоархивы и зашифрованные данные могут почти не уменьшаться. Рекламный коэффициент экономии нельзя подставлять вместо замера.
| Исходное значение | Пример | Как проверить |
|---|---|---|
| Защищаемые данные | 20 ТБ используемых данных | Инвентаризация приложений и выбранных томов |
| Изменения за сутки | 1 ТБ, то есть 5% исходного объёма | История нескольких представительных циклов |
| Краткосрочные точки | 30 ежедневных точек | Политика восстановления и способ формирования цепочки |
| Долгосрочные точки | Месячные и годовые по отдельному требованию | Реальный срок, объём и независимость хранения |
| Окно копирования | 2 часа на ежедневный инкремент | Расписание с учётом обслуживания и других задач |
| Цель восстановления | 10 ТБ за 4 часа | Тест полного пути до работоспособного приложения |
Как рассчитать ёмкость: полная копия и инкременты
Для цепочки из одной полной и 29 ежедневных инкрементных копий используем V = S + 29 × Δ. При условных S = 20 ТБ и Δ = 1 ТБ получим 49 ТБ до сжатия и служебных данных.
Если пилот подтвердил коэффициент хранения 0,65, объём составит 49 × 0,65 = 31,85 ТБ. При требовании оставлять 20% полезного тома свободными нужно 31,85 ÷ 0,8 = 39,8125 ТБ. Затем добавляют пространство для конкретных операций обслуживания и политик: новой полной копии, временного сосуществования цепочек, проверок и продлённой неизменяемости. Такой запас нельзя считать одинаковым для всех схем.
Без подтверждённого сжатия исходный бюджет при том же лимите заполнения — 49 ÷ 0,8 = 61,25 ТБ до дополнительного рабочего пространства. Разница существенная. Поэтому оценку делают как минимум в двух вариантах: измеренный типичный и неблагоприятный, в котором экономия меньше или прирост данных выше.
Как GFS и длительное хранение меняют ёмкость репозитория?
Политика с недельными, месячными и годовыми точками требует отдельного календаря хранения. Для каждой группы укажите частоту, число версий и место хранения: один срок «30 дней» этого не описывает.
Для консервативной оценки возьмём полный набор 10 TB, ежедневные изменения 0,3 TB, 30 ежедневных точек и 12 месячных полных копий. Если месячные копии физически независимы и дополнительного разделения блоков нет, бюджет равен 10 + 29 × 0,3 + 12 × 10 = 138,7 TB до сжатия и резерва. Если часть месячных точек совпадает с уже учтёнными копиями, пересечение вычитают. Это намеренно простая модель, не описание формата любого backup-продукта.
Почему 30 точек не всегда занимают ровно 30 суток?
Удаление старых данных зависит от целостности цепочки. Если для нужного инкремента требуется более старая полная копия, её нельзя удалить независимо. Периодические полные копии, GFS-точки, повторные задания и срок неизменяемости способны продлевать фактическое удержание файлов. Освобождение места может происходить ступенями.
Синтетическая полная копия собирается из уже имеющихся данных. При поддержке блочного клонирования файловая система может ссылаться на существующие блоки вместо повторной записи всего объёма. Это уменьшает дополнительные затраты, но не делает хранение бесплатным: изменённые блоки занимают место, а сохранённые точки удерживают старые блоки до истечения зависимостей и политик.
Физическая дедупликация, сжатие и Fast Clone — разные механизмы. Для каждого проверяют совместимость файловой системы, параметры создания тома, формат backup-файлов и ограничения версии ПО. Увеличивать срок неизменяемости на заполненном репозитории без пересчёта ёмкости опасно: политика удаления уже не сможет быстро освободить защищённые файлы.
Как посчитать окно резервного копирования?
Минимальная полезная скорость: B = объём передаваемых данных ÷ доступное время. Для 1 ТБ за два часа нужно 1 000 000 МБ ÷ 7200 с = 138,9 МБ/с. Это около 1,11 Гбит/с полезных данных. Обычное соединение 1GbE с теоретическим пределом 125 МБ/с до накладных расходов уже не укладывается в условие, если весь этот терабайт действительно передаётся по сети.
Но одинаковый размер инкремента в репозитории не означает одинаковый сетевой поток. Если сжатие выполняется до сети, данных может быть меньше. Если источник приходится сканировать полностью, чтение и CPU могут оставаться значительными даже при небольшом переданном инкременте. В расчёте явно указывают, к какому участку относится объём.
Первую полную копию планируют отдельным окном. Для 20 ТБ за восемь часов потребуется 694,4 МБ/с полезного потока. Более длинное первичное окно допустимо, если оно согласовано до ввода в эксплуатацию.
Как рассчитать скорость восстановления и реальный RTO?
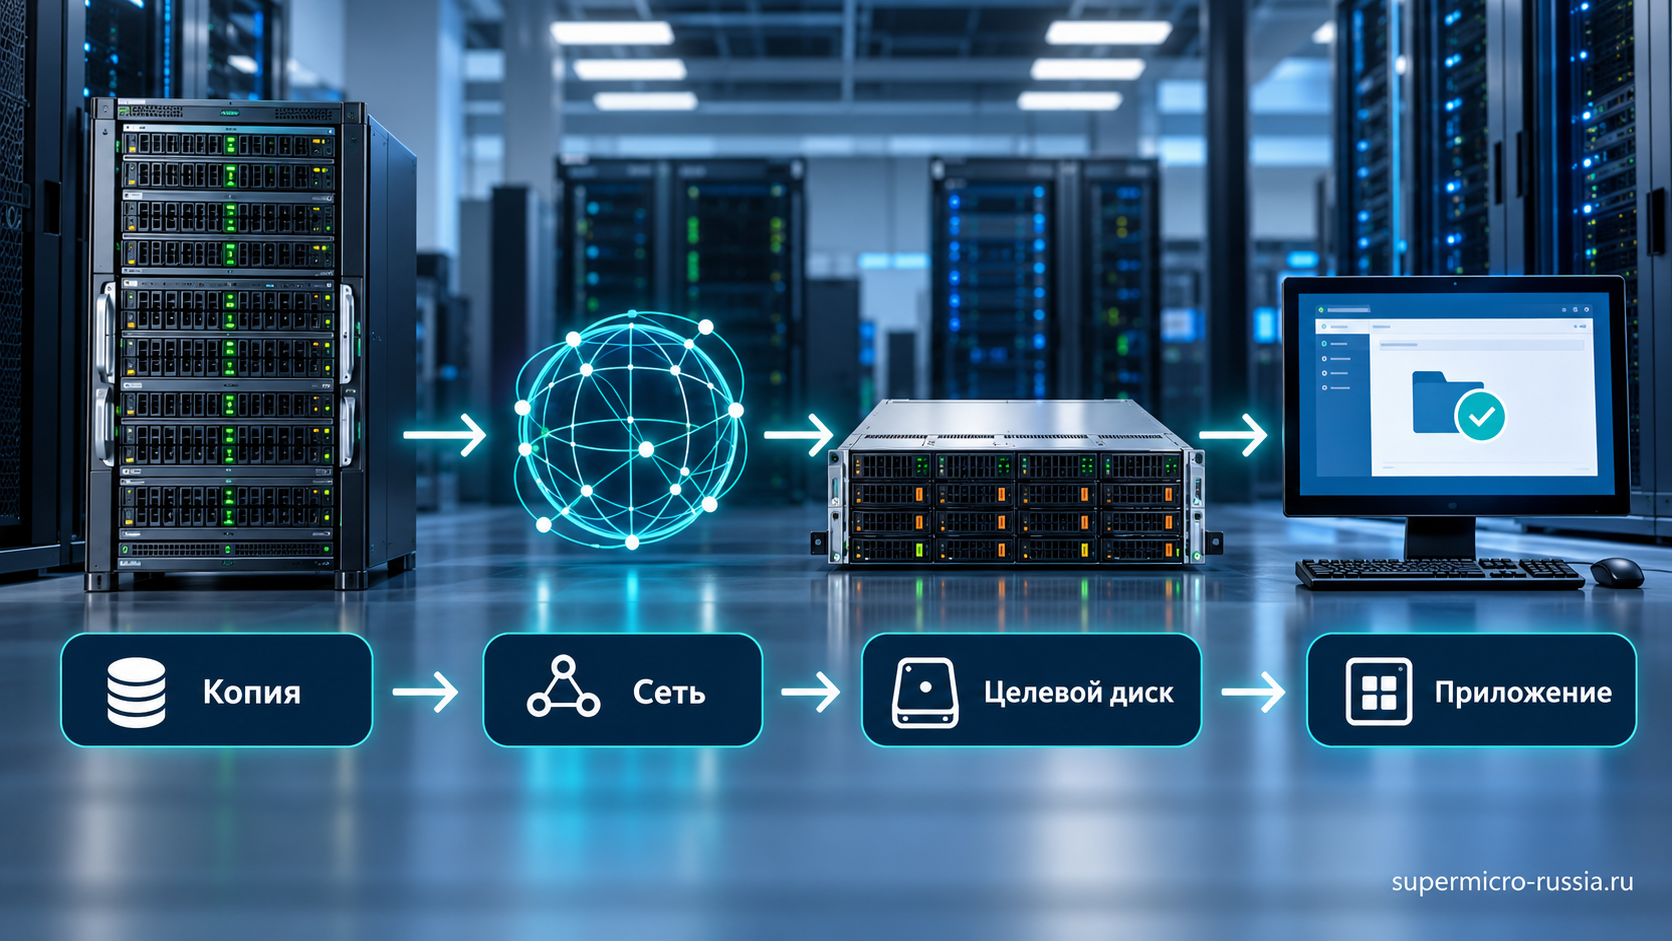
У восстановления есть собственная цепочка: чтение backup-файлов, декомпрессия и расшифрование, передача, запись на целевые накопители, воспроизведение журналов и запуск приложения. Скорость ограничена самым медленным участком. Быстро записывать последовательный бэкап на HDD — не то же самое, что одновременно читать несколько цепочек и возвращать десятки ВМ.
| Возвращаемый объём | Время только на перенос | Минимальный полезный поток | Сетевой эквивалент до накладных расходов |
|---|---|---|---|
| 1 ТБ | 1 час | 277,8 МБ/с | 2,22 Гбит/с |
| 5 ТБ | 4 часа | 347,2 МБ/с | 2,78 Гбит/с |
| 10 ТБ | 4 часа | 694,4 МБ/с | 5,56 Гбит/с |
| 20 ТБ | 8 часов | 694,4 МБ/с | 5,56 Гбит/с |
Если из RTO четыре часа один час уходит на подготовку, проверку и запуск приложения, для переноса 10 ТБ остаётся три часа. Требуемый поток вырастает до 925,9 МБ/с. Сравнивать его нужно с фактической производительностью всего пути. Даже 10GbE-порт не гарантирует такой результат, если диски назначения пишут медленнее.
Мгновенный запуск ВМ из копии может сократить время возврата доступа, но создаёт другую нагрузку на репозиторий и не отменяет последующую миграцию данных. Проверяют производительность приложения в этом режиме, число одновременно запущенных систем и влияние на текущие задания копирования.
Как считать восстановление от требуемого RTO, а не от скорости диска?
Из полного RTO сначала вычитают обнаружение инцидента, принятие решения, подготовку среды, запуск зависимостей и проверку приложения. Остаток времени доступен для получения данных. Заранее определите, где лежат каталог копий и ключи и кто выдаст доступ при потере основной среды.
Допустим, нужно перенести 10 TB полезных данных. Канал 10 Gbit/s при условном устойчивом использовании 70% даёт 7 Gbit/s, или 875 MB/s. Нижняя оценка одной передачи равна 10 000 000 MB / 875 MB/s ≈ 11 429 секунд, то есть 3 часа 10 минут. Здесь ещё нет чтения медленного источника, декомпрессии, восстановления цепочки и запуска приложения. Обещать двухчасовой RTO для такой полной передачи нельзя.
Если для собственно переноса осталось 90 минут, нужен поток 10 000 000 / 5400 ≈ 1852 MB/s, или 14,8 Gbit/s полезных данных. Это требование ко всему пути, а не только к сетевому порту. Альтернативой может быть согласованный способ раннего запуска критичной части приложения с фоновым переносом, если его действительно поддерживает выбранное ПО и проверка подтверждает нужную производительность.
HDD, SSD или смешанная конфигурация?
Большие HDD удобны для ёмкого последовательного хранения. SSD полезны для системного тома, метаданных, частых мелких операций и сценариев быстрого запуска из резервной копии. Выбор определяется сочетанием объёма и RTO. Покупать весь репозиторий на NVMe ради одного быстрого сетевого теста не всегда оправданно; экономить на дисках при требовании быстрого массового восстановления тоже нельзя.
Проверяют контроллер, backplane, поддержку накопителей ОС, режим записи и защиту кэша. Рекомендации backup-продукта по RAID, файловой системе и размеру полосы имеют приоритет над привычной схемой администратора. Аппаратный RAID, HBA с программным управлением и специализированная система хранения требуют разных решений.
Сам RAID не является резервной копией. Он помогает пережить определённый отказ диска, но не возвращает предыдущую версию удалённой базы. Общая архитектура хранения разобрана в статье NAS или сервер хранения, а здесь критерием остаётся восстановление из независимой копии.
CPU, RAM и параллельные задания: как избежать узкого места?
Выясняют, какие роли совмещены на сервере: управление заданиями, proxy, репозиторий, шифрование, дедупликация, проверка целостности и сканирование. Если сжатие выполняет proxy на другом узле, требования к CPU репозитория отличаются от машины, выполняющей всё сразу. Минимальные требования установки ПО не являются спецификацией для полной рабочей нагрузки.
Число параллельных задач ограничивают самым узким ресурсом. Условные восемь потоков по 150 МБ/с требуют 1200 МБ/с полезной полосы. Это почти весь теоретический бюджет 10GbE ещё до протокольных расходов. Шестнадцать потоков на том же тракте не удвоят скорость и могут ухудшить задержки дисков.
Как проверить репозиторий при одновременных задачах?
На календаре заданий отметьте пересечения инкрементов, полных и синтетических копий, проверки целостности, внешней копии и восстановления. На этих интервалах репозиторий должен одновременно читать и писать, а не показывать только скорость пустого последовательного теста.
Пусть восемь задач пишут по 100 MB/s и параллельно восстановление читает 300 MB/s. Система хранения должна обслужить 800 MB/s записи и 300 MB/s чтения в требуемом режиме. Это не просто «диск на 1100 MB/s»: смешанные обращения, размеры блоков и очереди меняют поведение. Отдельно оценивают входящий и исходящий трафик сетевых портов.
Увеличивайте число задач ступенями. Если переход с восьми на шестнадцать почти не увеличивает полезный поток, но удваивает задержку и расход памяти, параллелизм уже не даёт ожидаемой пользы. Предел concurrent tasks должен опираться на процессоры, память и накопители конкретного backup-продукта.
Что такое неизменяемый репозиторий и каковы пределы защиты?
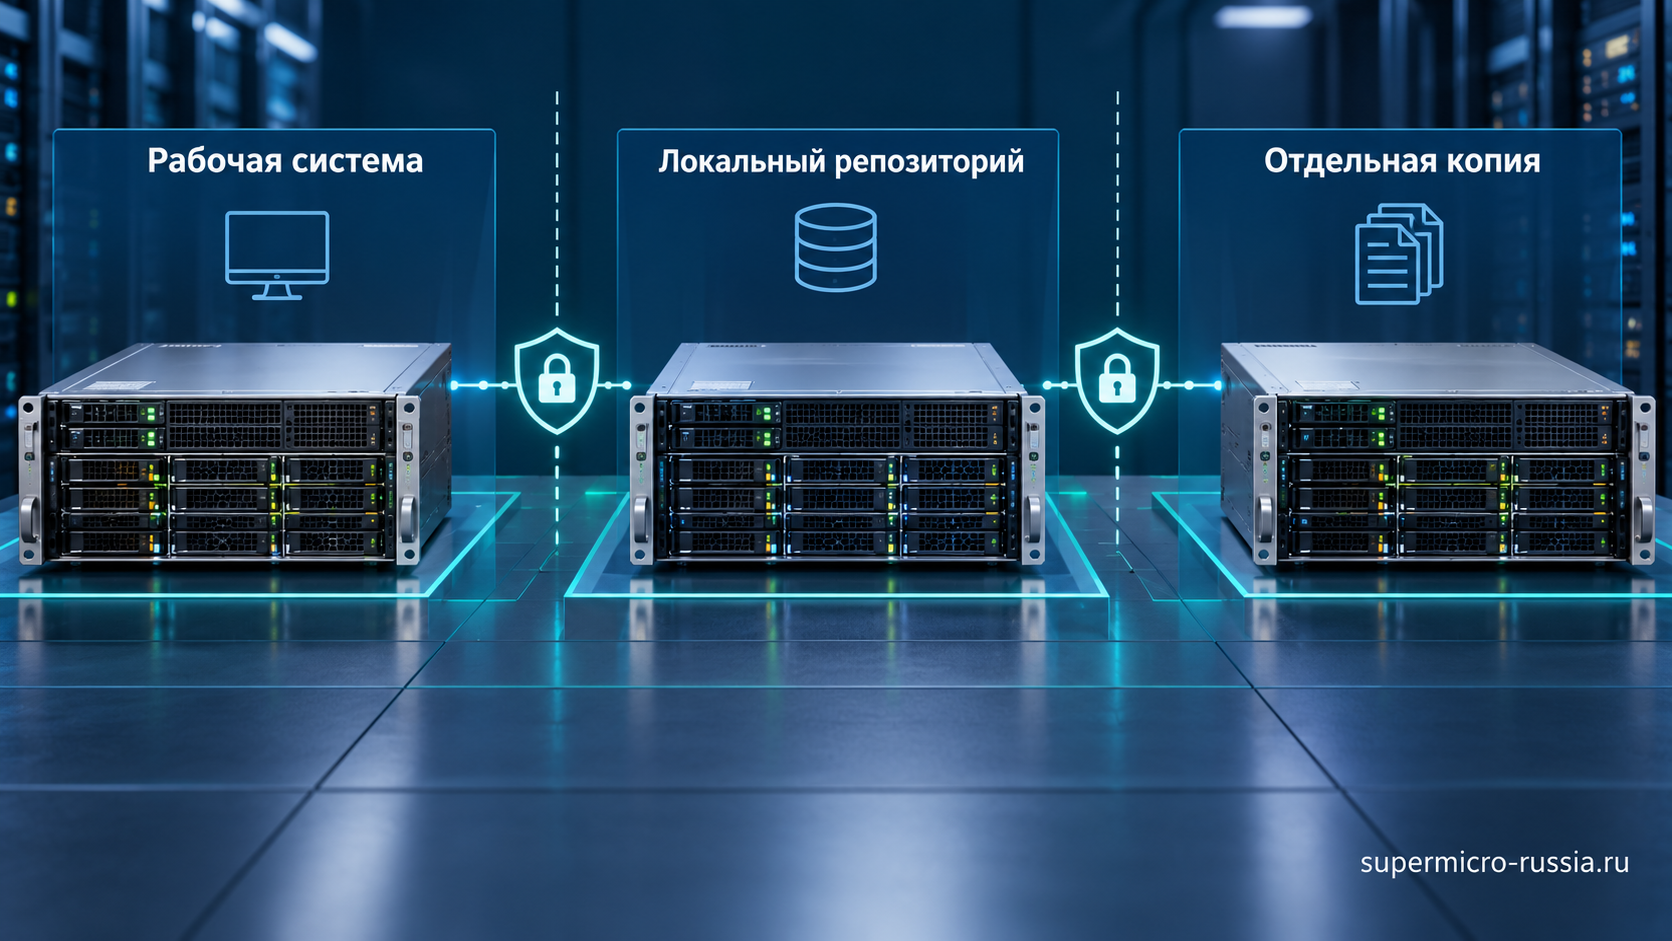
Неизменяемость ограничивает изменение и удаление backup-файлов в течение заданного срока. Границу защиты задают реализация хранилища, учётные данные и доступ к оборудованию.
Veeam Hardened Repository использует Linux-хранилище с поддерживаемыми механизмами неизменяемости. Для снижения поверхности атаки подходит отдельная физическая машина с локальными накопителями. Обычная SMB/NFS-папка, смонтированная в Linux, не становится таким репозиторием только из-за выбора каталога в мастере. XFS с поддерживаемым клонированием блоков может уменьшать накладные расходы синтетических полных копий.
Для развёртывания Veeam предусмотрены механизмы безопасной аутентификации, включая одноразовые учётные данные, а в соответствующем варианте appliance — сертификаты. Способ выбирают для конкретной версии и варианта установки. Постоянный административный ключ от репозитория на скомпрометированном backup-сервере ухудшает изоляцию.
«Я настоятельно рекомендую использовать одноразовые учётные данные».
Рик Вановер, Veeam, перевод фрагмента о подключении защищённого репозитория.
Root, загрузочный носитель, доступ к дискам и BMC рассматривают отдельно от обычных прав backup-системы. Контроль над этими средствами может позволить уничтожить оборудование или данные вопреки файловым ограничениям.
Почему immutable-копии могут храниться дольше обычного retention?
Срок защиты от удаления и желаемое количество точек восстановления решают разные задачи. Если файл ещё защищён, обычная очистка не обязана освободить его сразу после выхода точки из логической политики. На расход влияют также зависимости цепочки и правила продукта. Проектируйте запас на период перекрытия вместо ожидания, что каждый новый день обязательно удалит ровно один старый.
Например, временное перекрытие дополнительно удерживает 7 TB данных. При базовом занятом объёме 40 TB фактический пик становится 47 TB. С проектным ограничением заполнения 80% нужно 58,75 TB полезной ёмкости. Применять только 40 / 0,8 = 50 TB в таком сценарии недостаточно. Для реального проекта объём перекрытия получают из моделирования выбранной цепочки, а не принимают 7 TB как норму.
Отдельный сигнал мониторинга — изменение срока immutability. В демонстрации Veeam Hardened Repository внимание уделено контролю этой настройки и физическому размещению репозитория. Учебная виртуальная машина в ролике выбрана ради показа; её нельзя без оговорок принимать за архитектуру защищённого производственного хранилища.
Что полезно взять из практического теста Veeam v13?
В разборе Labs Hands On после добавления Linux-репозитория выполняются полная копия тестовой ВМ, инкремент и попытка обычного удаления защищённых файлов. Операция удаления завершается отказом, а проверка атрибутов подтверждает установленную защиту. Это полезная проверка фактического поведения, дополняющая значок замка в интерфейсе.
Сколько копий нужно и где хранить отдельную?
Рабочая система, локальная копия и отдельная копия решают разные задачи. Локальный репозиторий удобен для быстрого восстановления. Копия в другой зоне отказа помогает при потере площадки. Offline-носитель или правильно настроенное неизменяемое хранилище уменьшает часть рисков уничтожения через сеть. Требуемое сочетание задают по модели отказов.
Известный принцип 3-2-1 и его расширения полезны как отправная точка, но сами цифры не доказывают независимость. Два массива в одной стойке с одними административными правами и питанием могут потеряться одновременно. Также два экземпляра одного уже повреждённого backup-файла не равны двум пригодным точкам восстановления.
Ключи шифрования, конфигурацию backup-системы и инструкции доступа сохраняют независимо и защищают. Потеря единственного пароля способна сделать исправные копии бесполезными. Для аварийного сценария проверяют, что необходимые сведения доступны без работающего основного домена и без исходного backup-сервера.
Что дают Scale-Out Repository, Copy и Move?
В дополнительном разборе Scale-Out Backup Repository показаны добавление extent, политики размещения и переход данных между уровнями. Для расчёта полезно разделять расширение рабочего репозитория и создание дополнительной копии. Добавление ёмкости в общий пул само по себе не образует независимый резерв.
Copy создаёт дополнительную копию, Move переносит подходящие данные на другой уровень. Политики проверяют для выбранного продукта, уровня и сроков. Перемещение старых данных само по себе не создаёт независимую копию; требования обычного NFS extent и Hardened Repository также проверяют раздельно.
Объектный или архивный уровень может иметь другие задержки доступа, требования к извлечению, стоимость операций и скорость восстановления. «Есть в облаке» не означает «готово к немедленному запуску приложения». Для каждого класса данных задайте, откуда реально выполняется восстановление и сколько времени занимает подготовка чтения.
Матрица совместимости до покупки сервера
| Участок | Что подтвердить | Практический риск |
|---|---|---|
| Источники | Поддерживаемые версии ОС, гипервизоров, СУБД и агентов | Копия файла есть, согласованного приложения нет |
| Репозиторий | Локальный, блочный, файловый или объектный тип по требованиям продукта | Выбранный способ хранения не поддерживает нужную защиту |
| Файловая система | Версия, параметры тома, immutable и block clone при необходимости | Не работает ожидаемая экономия или неизменяемость |
| Накопители и контроллер | ОС, драйвер, RAID/HBA, кэш и защита питания | Недостаточный поток либо риск потери подтверждённой записи |
| Сеть | Порты, трансиверы, маршруты, резервирование, доступ при аварии | Нужная скорость есть только на одном участке |
| Восстановление | Совместимые целевые ресурсы и средства запуска | Копия исправна, но восстановить её некуда |
Как выбрать платформу Supermicro для backup-репозитория?
Под заданные объём и потоки выбирают число отсеков, контроллер и сеть. Подходящие варианты ищут в серверах хранения Supermicro; серверную платформу проверяют вместе с нужными накопителями и адаптерами.
Например, 12 рабочих HDD по 12 ТБ в условной схеме с двумя дисками эквивалентной ёмкости под двойную чётность дают около 120 ТБ до служебных расходов. Это расчёт ёмкости, а не подтверждение скорости конкретной модели. Отдельные SSD для ОС и свободные отсеки учитывают в составе шасси. Hot spare, если он нужен, добавляют сверх рассчитанного рабочего состава.
Для backup-сервера полезны удалённая консоль, наблюдение за дисками и доступная замена накопителей. BMC отделяют от пользовательской сети. Варианты под выбранный backup-продукт сравнивают через каталог оборудования Supermicro, учитывая требуемое восстановление.
Как проверить резервную копию приложения?
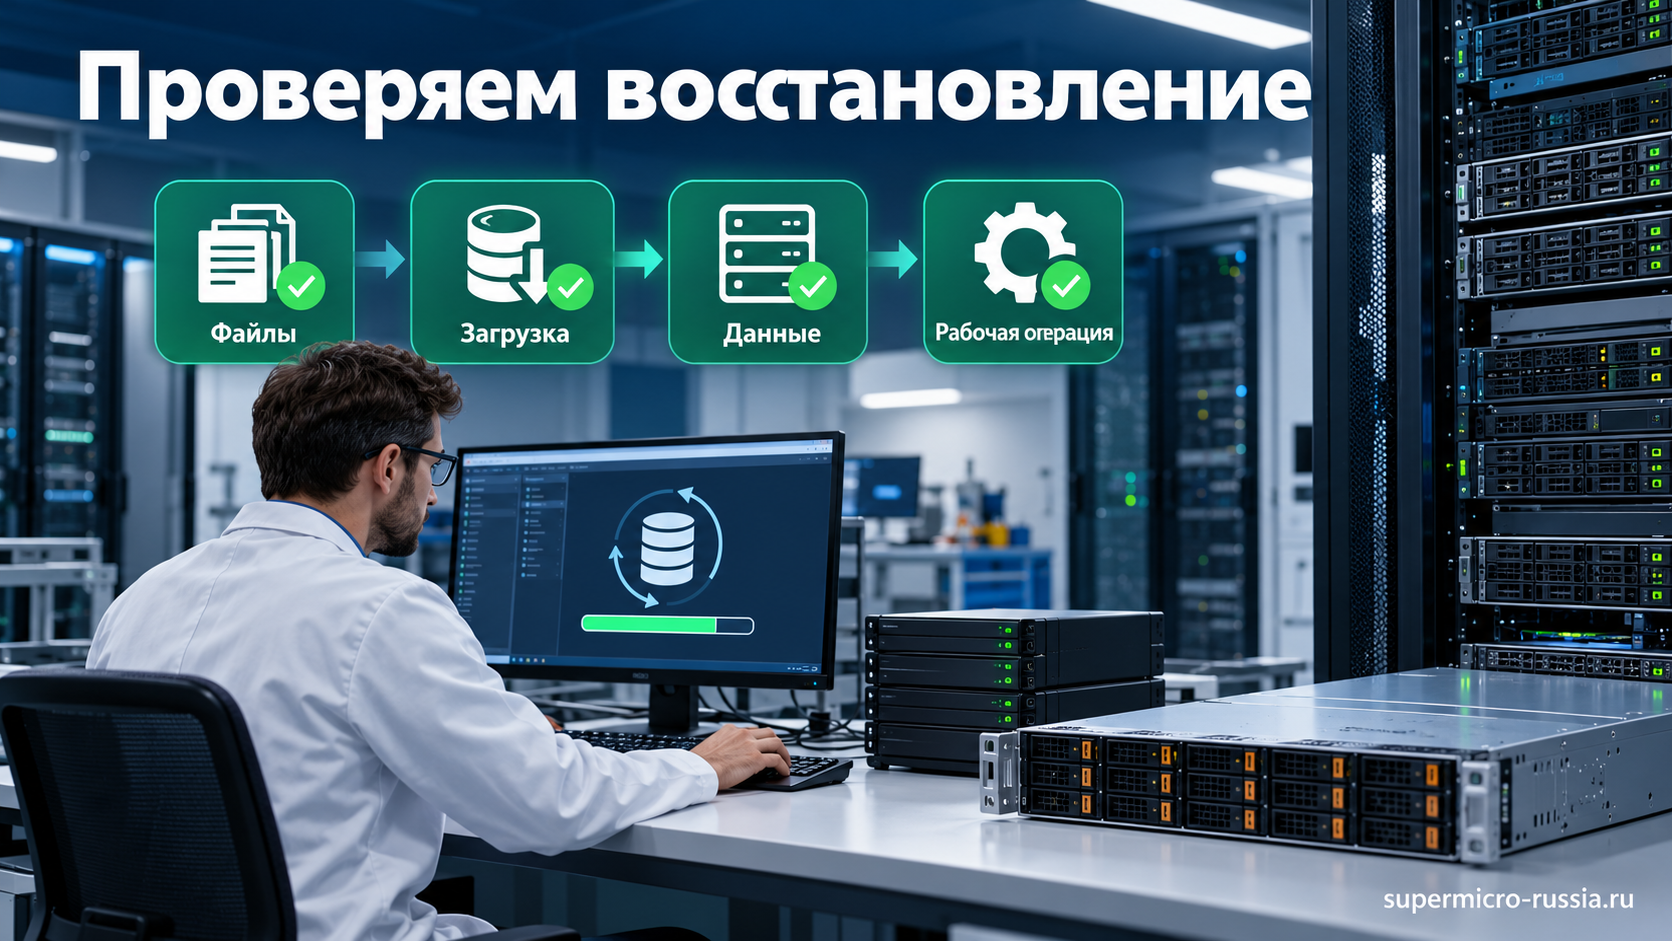
Контрольная сумма проверяет целостность сохранённого объекта, но не подтверждает работоспособность всей системы. Для базы данных нужны согласованный способ создания копии, необходимые журналы и проверка восстановления. Для ВМ — загрузка, доступ к дискам и запуск служб. Для пользовательских файлов — чтение, права и корректные версии.
Восстановление проводят в изолированной среде, чтобы тестовый сервер не выдал себя за рабочий, не отправил письма, не выполнил задания и не изменил внешние системы. Затем проверяют конкретную операцию: открыть документ, выполнить контрольный запрос, сформировать отчёт, подтвердить число или выборку записей. Доступность окна входа ещё не означает, что приложение готово обслуживать пользователей.
Время измеряют от согласованной начальной точки до подтверждения сервиса, отдельно записывая этапы. Если восстановление 1 ТБ идёт со скоростью 400 МБ/с, перенос занимает около 41 минуты 40 секунд. Дополнительные 20 минут на запуск и проверку дают уже 1 час 1 минуту 40 секунд. Именно это значение сравнивают с часовым RTO, а не только скорость копирования.
Как согласовать порядок восстановления нескольких систем?
Репозиторий не должен восстанавливать всё одновременно без приоритетов. Учётная система может зависеть от каталога пользователей, DNS, базы и файлового ресурса. Пока не восстановлены зависимости, уже запущенная ВМ не делает бизнес-службу доступной. Постройте последовательность с ответственными и контрольной операцией для каждого шага.
Задачи, назначенные разным группам, часто делят один сетевой порт и одни диски. Если два восстановления получили по 500 MB/s в отдельных тестах, это не доказывает 1000 MB/s вместе. В общем прогоне проверяют очередь на чтении, CPU декомпрессии, сетевой выход и запись целевого хранилища. При необходимости менее важные системы запускают позже, чтобы соблюсти срок критичной.
Для защиты от уничтожения рабочей среды полезно провести проверку без её вспомогательных сервисов: с заранее сохранённой инструкцией, отдельным доступом и проверяемыми копиями необходимых настроек. Пароли и ключи не помещают в открытый протокол испытаний. В нём фиксируют только факт наличия доступа, ответственного и безопасный способ получения.
После запуска проверяют согласованность данных и бизнес-операцию: вход пользователя, открытие документа, проведение тестовой транзакции или восстановление выбранного файла. Затем подтверждают возобновление резервного копирования уже восстановленной системы. Успешный аварийный запуск без дальнейшей защиты оставляет новый контур в уязвимом состоянии.
Как посчитать канал для удалённой копии и отставание репликации?
Для внешней копии важен ежедневный объём изменений и реально доступное окно передачи. Если требуется передать 1 TB за десять часов, средний полезный поток должен составлять около 27,8 MB/s, или 222 Mbps. Это нижняя расчётная граница до накладных расходов и конкурирующих приложений. Номинальный канал 200 Mbps уже не выполняет условие даже без потерь.
После длительного обрыва возникает очередь. При поступлении новых изменений 1 TB в сутки канал должен переносить и текущий поток, и накопленное отставание. Если он передаёт ровно суточные изменения за сутки, очередь после аварии не сокращается. В проекте задают срок догоняющего копирования и резерв полосы для него.
Восстановление через удалённую площадку считают отдельно. Один и тот же канал может быть достаточен для небольших суточных изменений и непригоден для возврата многотерабайтной полной базы в короткий RTO. Возможные решения — локальная восстановительная копия, заранее подготовленная площадка или согласованный более длительный аварийный режим. Сам факт наличия внешней копии не обещает быстрый возврат сервиса.
Программа приёмки сервера резервного копирования
| Проверка | Что измерить или подтвердить | Результат |
|---|---|---|
| Полная и инкрементная копии | Прочитанный, переданный и сохранённый объёмы, время | Фактическое окно и коэффициент хранения |
| Политика удержания | Занятое место после полного цикла ротации | Ёмкость хватает без аварийного удаления |
| Неизменяемость тестовой точки | Поведение разрешённых и запрещённых операций | Защита работает в пределах заданной модели доступа |
| Восстановление при текущем копировании | Поток, задержки и завершение обеих задач | Приоритет восстановления соблюдается |
| Потеря исходного хоста | Восстановление на другом совместимом ресурсе | Нет скрытой зависимости от исходной машины |
| Потеря основной инфраструктуры доступа | Ключи, конфигурация, инструкции и необходимые учётные записи | Аварийное восстановление выполнимо |
| Контроль приложения | Загрузка, согласованность и рабочая операция | Подтверждены RPO и RTO конкретного сервиса |
После ввода наблюдают за последней пригодной точкой восстановления, отдельной копией, свободным местом и ростом изменений. Учебные восстановления повторяют по регламенту и после изменений backup-продукта, СУБД или хранения, которые затрагивают проверенный сценарий.
Частые вопросы о сервере для бэкапов
Можно ли хранить копии на том же физическом сервере, что и рабочие ВМ?
Это может помогать при отдельных логических ошибках, но не защищает от потери самого хоста, его дисков и части административных атак. Такой экземпляр не считают единственной независимой копией.
Нужно ли учитывать рост данных в старых месячных копиях?
Да. Месячные точки разного возраста могут иметь разный размер. Модель с двенадцатью одинаковыми файлами — упрощение; при устойчивом росте стройте календарь размеров и удержания.