Пузырь ИИ: как подобрать инфраструктуру Supermicro без лишних мощностей
Споры о том, существует ли пузырь ИИ, обычно сводятся к оценке всего рынка. Для компании, которая выбирает вычислительное оборудование, важнее другой вопрос: не создаёт ли она собственный локальный «пузырь», закупая GPU раньше, чем измерила реальную нагрузку? Дорогой ускоритель приносит пользу только тогда, когда получает данные без задержек, загружен подходящими задачами и поддержан сетью, хранилищем, питанием и охлаждением.
Разберём, почему количество установленных GPU не равно полезной вычислительной мощности, как различаются обучение, дообучение, инференс и RAG и по каким данным выбирать GPU-серверы SUPERMICRO. Цель — не угадать судьбу рынка искусственного интеллекта, а собрать инфраструктуру, которую можно загрузить, обслуживать и масштабировать.
Пузырь ИИ — вопрос рынка или ошибка конкретного проекта?
Рынок может расти, а отдельный проект всё равно оказаться переоснащённым. И наоборот: осторожный пилот способен подтвердить спрос и оправдать быстрое расширение. Поэтому решение о закупке нельзя строить только на новостях о новых моделях, количестве ускорителей у лидеров отрасли или прогнозе стоимости вычислений.
Локальный инфраструктурный «пузырь» возникает, когда мощность приобретают под предположение, которое ещё не проверено эксплуатацией. Например, команда рассчитывает на постоянное обучение моделей, но фактически запускает эпизодические задачи инференса; покупает восемь ускорителей, хотя программный стек эффективно использует только один или два; закладывает высокую пиковую производительность, но не учитывает периоды подготовки данных и ожидания согласований.
Из этого не следует, что оборудование нужно покупать только после появления очереди из пользователей. Вычислительная инфраструктура требует запаса по мощности, резервирования и времени на поставку. Но запас должен быть обоснован сценарием роста, а не выражаться в принципе «возьмём максимум — потом пригодится».
Установленные GPU не равны полезной мощности
Ускоритель может быть физически установлен и технически исправен, но значительную часть времени ждать данные, синхронизацию с другими GPU или свободный слот в программной очереди. Поэтому оценивать проект только по числу GPU, объёму их памяти или пиковой производительности недостаточно.
Полезная мощность — это способность всей системы завершать нужные бизнесу задания с требуемой скоростью, качеством и стоимостью. Для её оценки нужны не рекламные максимумы, а метрики конкретного приложения: время обучения, число обработанных запросов, задержка на заданном перцентиле, скорость индексации документов, длительность окна пакетной обработки и стоимость завершённой задачи.
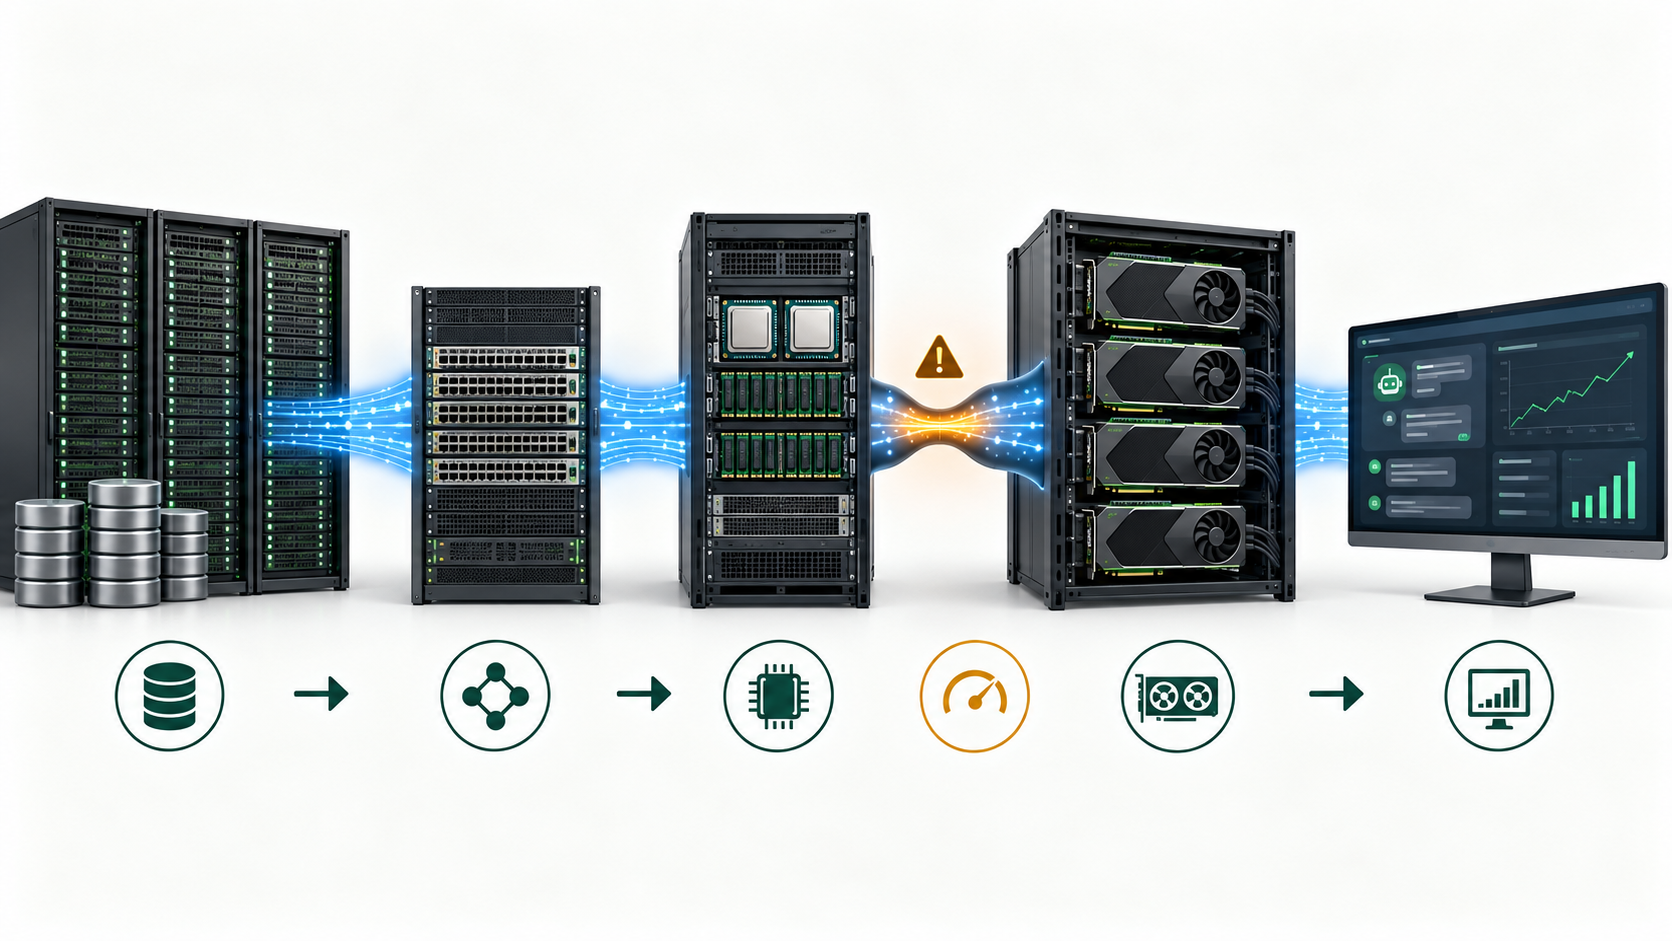
Самый дорогой компонент не обязательно является текущим ограничением. Если GPU недополучает данные, добавление ещё одного ускорителя лишь увеличит очередь на узком участке. Причиной могут стать накопители, сеть, объём оперативной памяти, подготовка данных на CPU, обмен между ускорителями или код, который плохо распараллеливается.
Сначала нагрузка: обучение, дообучение, инференс или RAG
Фраза «нам нужен сервер для ИИ» описывает технологию, но не рабочую нагрузку. Перед подбором оборудования нужно разделить хотя бы четыре сценария.
| Сценарий | Что измерять на пилоте | Что часто становится ограничением |
|---|---|---|
| Обучение с нуля | Время шага и эпохи, масштабирование на нескольких GPU, скорость контрольных точек | Обмен между ускорителями, память GPU, сеть кластера, подача данных и хранилище |
| Дообучение | Размер модели и набора данных, длительность запуска, повторяемость экспериментов | Память GPU, пропускная способность ввода-вывода, эффективность выбранного метода |
| Инференс | Запросы в секунду, задержка p95/p99, размер контекста, число одновременных пользователей | Память и пропускная способность GPU, пакетирование, сеть, программный сервер модели |
| RAG и интеллектуальный поиск | Скорость индексации, время извлечения документов, задержка полного ответа, качество поиска | Хранилище, CPU и RAM, векторная база, сеть и только затем генеративная модель |
В реальном сервисе сценарии могут сочетаться. Например, днём сервер обрабатывает запросы пользователей, ночью переиндексирует документы, а периодически используется для дообучения. Тогда проектировать систему надо по профилю нагрузки во времени, а не по единственному максимальному тесту.
Для RAG полезно отдельно описать путь данных от источника до ответа. В материале про архитектуру Agentic RAG показано, почему такие решения нельзя сводить к одной видеокарте: работа распределяется между извлечением знаний, вычислениями и хранением.
Пять узких мест, которые создают дорогой простой
1. Память и связь между GPU
Модель, служебные данные и промежуточные результаты должны помещаться в доступную память. Если задача распределяется между несколькими ускорителями, важна не только сумма гигабайтов: программная схема распределения определяет объём и частоту обмена. Проверять нужно конкретную модель, точность вычислений, размер контекста и используемый фреймворк.
2. Сеть
В одном сервере и между серверами действуют разные соединения. При переходе от одиночной системы к кластеру задержки и пропускная способность сети становятся частью вычислительного процесса. Топологию, адаптеры, коммутаторы и кабельную инфраструктуру нужно считать вместе, а не добавлять после покупки GPU.
3. Хранилище и подготовка данных
Датасеты требуется загрузить, проверить, преобразовать и подать вычислителям. При обучении система также записывает контрольные точки, а в RAG постоянно работает с документами и индексами. Поэтому серверные системы хранения SUPERMICRO подбирают по профилю ввода-вывода, параллельности доступа, резервированию и восстановлению, а не только по суммарной ёмкости дисков.
4. Питание и охлаждение
Свободное место в стойке ещё не означает готовность площадки к GPU-системе. Нужно заранее проверить доступную электрическую мощность, схему резервирования, распределение нагрузки, отвод тепла и требования выбранной конфигурации. Воздушное и жидкостное охлаждение — не взаимозаменяемые наклейки в спецификации: решение согласуют с сервером, стойкой и инженерными системами объекта. Supermicro описывает такой комплексный подход в материалах о жидкостном охлаждении дата-центров.
5. Программный стек и эксплуатация
Даже сбалансированное оборудование не гарантирует высокой загрузки. Нужны драйверы и библиотеки совместимых версий, мониторинг, планировщик задач, контроль доступа, резервное копирование, процесс обновлений и специалисты, которые умеют находить причину простоя. До заказа полезно зафиксировать, кто отвечает за каждый уровень — от микрокода до прикладной модели.
Облако, собственный сервер или кластер?
Универсального ответа нет. Облачный доступ удобен для короткого эксперимента и нестабильной нагрузки: не нужно заранее готовить площадку, а конфигурацию проще менять. Собственный сервер оправдан, когда задача повторяется, данные должны оставаться в контролируемом контуре, важна предсказуемая доступность или аренда при фактическом профиле использования становится менее удобной.
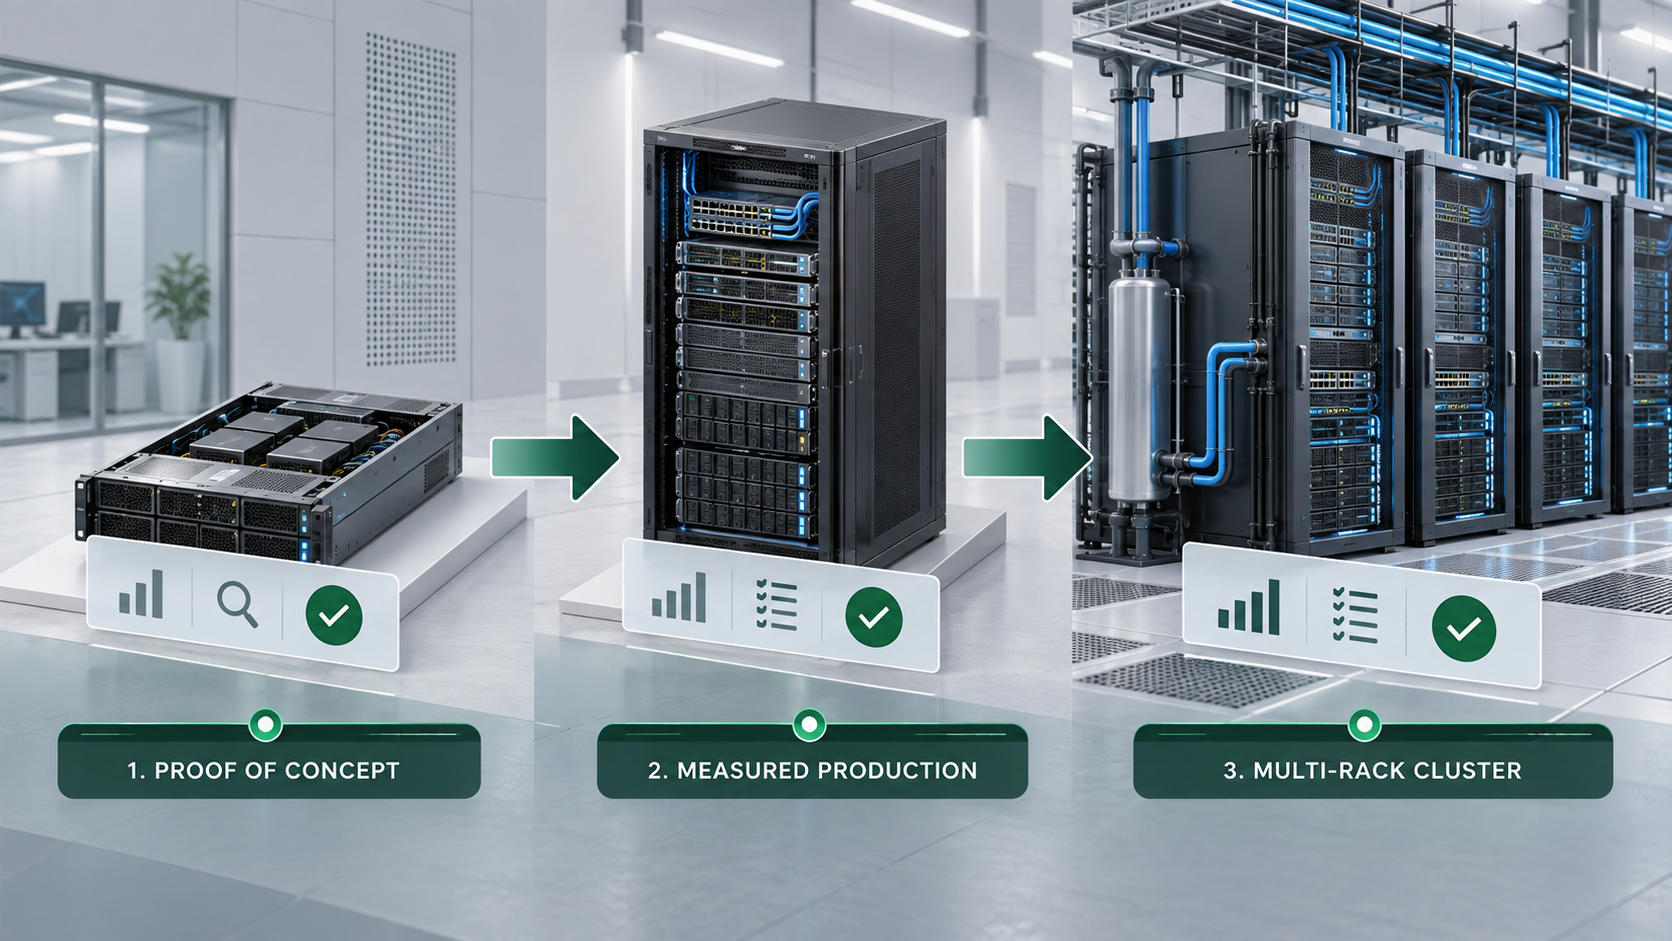
Кластер нужен не потому, что «один сервер недостаточно серьёзный», а когда тесты подтверждают необходимость нескольких узлов и программное обеспечение умеет использовать их совместно. Нередко рациональная последовательность выглядит так: краткий облачный тест, локальный пилот на одном сервере, производственная система и только затем масштабирование по измеренным ограничениям.
| Вопрос | Почему он важен |
|---|---|
| Нагрузка постоянная или эпизодическая? | Определяет экономику владения и допустимость очереди на ресурс. |
| Можно ли вынести данные за пределы контура? | Влияет на архитектуру, безопасность и набор доступных сервисов. |
| Как быстро должна меняться конфигурация? | Эксперименту нужна гибкость, производству — повторяемость и поддерживаемость. |
| Есть ли готовая площадка? | Электропитание, охлаждение и сеть могут ограничить выбор сильнее бюджета на GPU. |
| Кто будет эксплуатировать систему? | Без мониторинга и компетенций оборудование может простаивать независимо от его характеристик. |
Как масштабировать ИИ-инфраструктуру без закупки «на вырост»
- Зафиксировать критерий успеха. Не «модель запускается», а измеримый результат: допустимая задержка, производительность, срок обучения, качество поиска или стоимость задания.
- Провести воспроизводимый пилот. Использовать реальные размеры моделей, наборов данных и контекста. Синтетический тест полезен для сравнения компонентов, но не заменяет профиль приложения.
- Найти первое ограничение. Записать загрузку GPU и CPU, использование памяти, сетевой обмен, чтение и запись, время ожидания в очереди. Масштабировать тот ресурс, который действительно сдерживает результат.
- Собрать производственный узел. Добавить резервирование, безопасность, мониторинг и обслуживание. Производительность лабораторного стенда без этих функций может не повториться.
- Расширять повторяемыми блоками. Для нескольких стоек заранее согласовать сеть, питание, охлаждение и управление. Именно системный уровень Supermicro называет Data Center Building Block Solutions: сервер — лишь один из строительных блоков.
Какие решения Supermicro рассматривать
Начинать подбор лучше с класса системы и ограничений площадки. В каталоге доступны как готовые серверы Supermicro, так и серверные платформы Supermicro для согласованной конфигурации. Ниже — не рейтинг и не взаимозаменяемые варианты, а три разных направления для технического обсуждения.
| Модель | Платформа | Когда включить в шорт-лист |
|---|---|---|
| Supermicro AS-4125GS-TNRT | 4U, два процессора AMD EPYC 9004/9005, до восьми двухслотовых PCIe GPU | Когда нужна плотная восьмиускорительная система на платформе AMD и площадка рассчитана под форм-фактор 4U. |
| Supermicro AS-5126GS-TNRT | 5U, два процессора AMD EPYC 9004/9005, до восьми двухслотовых PCIe GPU, 24 слота DIMM | Когда рассматривается актуальная AMD-платформа с расширенным внутренним пространством и поддержкой совместимых современных ускорителей. |
| Supermicro SYS-521GE-TNRT | 5U, два Intel Xeon Scalable 4-го/5-го поколения, до восьми двухслотовых или десяти однослотовых GPU | Когда требуется процессорная платформа Intel и гибкая компоновка PCIe-ускорителей. |
Количество поддерживаемых GPU не означает совместимость с любой видеокартой. Перед заказом необходимо проверить актуальную матрицу поддерживаемых ускорителей, габариты и мощность конкретной модели, комплектацию кабелями и райзерами, версию прошивок, требования к питанию и охлаждению. Конфигурация поставки также может отличаться от максимальных возможностей платформы.
Если проект шире одного сервера, изучите решения SUPERMICRO для ИТ-инфраструктуры и отдельно согласуйте вычислительные узлы, GPU-ускорители и видеокарты, сеть, хранилище, стойки и инженерные системы. Такой подход соответствует идее DCBBS — проектированию дата-центра из совместимых строительных блоков.
Что должно войти в техническое задание
- названия моделей, фреймворков и версий программного стека;
- режим работы: обучение, дообучение, инференс, RAG или смешанный профиль;
- размер модели, точность вычислений, длина контекста и ожидаемая конкурентность;
- объём данных, характер файлов, скорость чтения и записи, правила хранения;
- целевые показатели производительности и метод их проверки;
- схема сети внутри сервера и между узлами;
- требования к резервированию, времени восстановления и доступности;
- ограничения стойки по глубине, массе, питанию и тепловой нагрузке;
- требования информационной безопасности и размещения данных;
- план роста на один, два и три следующих этапа без покупки всего объёма заранее.
Полезное ТЗ позволяет сравнивать не абстрактные «самые мощные серверы», а конфигурации, способные выполнить одну и ту же задачу. Для расчёта конкретной системы можно направить требования через форму запроса коммерческого предложения.
Какие метрики покажут, что мощности не простаивают
Единственной нормы загрузки GPU для всех проектов не существует. Высокий процент в одном графике может скрывать ожидание памяти, а низкий быть нормальным для сервиса с редкими, но критичными запросами. Смотреть нужно на систему метрик и результат приложения:
- время выполнения полезной работы — обучения, индексации или пакетного задания;
- пропускная способность и задержка при реальном числе пользователей, включая p95 и p99;
- загрузка и память GPU вместе с причинами ожидания;
- скорость и задержка ввода-вывода, сетевой обмен и время записи контрольных точек;
- длина очереди и время ожидания ресурса — признак того, что мощность может требовать расширения;
- энергия и стоимость завершённой задачи, а не только мощность оборудования в паспорте;
- доля времени простоя из-за обслуживания или ошибок.
Измерения стоит сохранять как базовую линию до и после изменений. Тогда решение о новом GPU, более быстрой сети или расширении хранилища будет опираться на эффект, а не на впечатление.
Частые вопросы
Нужно ли сразу покупать сервер на восемь GPU?
Нет, если пилот не показал необходимость такого масштаба. Восьмиускорительная платформа полезна для задач, которые способны использовать несколько GPU и требуют соответствующей памяти или производительности. Для другого приложения рациональнее может быть меньшая конфигурация с возможностью дальнейшего расширения.
Можно ли оценить сервер только по объёму памяти GPU?
Объём памяти определяет, какие модели и данные можно разместить, но не описывает скорость всей системы. Нужно учитывать вычислительную производительность, пропускную способность памяти, связь между GPU, CPU, RAM, накопители, сеть и эффективность программного стека.
Всегда ли жидкостное охлаждение лучше воздушного?
Не всегда. Выбор зависит от тепловой плотности, конфигурации сервера, возможностей площадки, стоимости внедрения и обслуживания. Для конкретного оборудования следует использовать поддерживаемый производителем вариант и проверять параметры всего контура.
Как понять, что пора переходить от одного сервера к кластеру?
Когда измерения показывают, что один узел не достигает требуемой производительности или памяти, а задача и программное обеспечение масштабируются на несколько серверов. До расширения полезно исключить локальные ограничения хранения, сети и кода.
Главный вывод
Спор о глобальном пузыре ИИ не даёт готового ответа на вопрос о закупке. Практическая защита от лишних мощностей — измеримый пилот, расчёт полного тракта данных и поэтапное масштабирование. GPU-сервер нужно рассматривать вместе с сетью, хранилищем, питанием, охлаждением и эксплуатацией.
Крупные проекты показывают, насколько важна архитектура целиком. Например, в разборе суперкомпьютера xAI Colossus количество ускорителей имеет смысл только в связке с повторяемыми стойками, сетью и охлаждением. Для корпоративного проекта принцип тот же, хотя масштаб может начинаться с одного узла: сначала определить полезную нагрузку, затем выбрать проверяемую конфигурацию и оставить понятный путь роста.
