Как построить отказоустойчивый кластер хранения на Supermicro?
Отказоустойчивый кластер хранения на Supermicro нужен, когда данные должны оставаться доступны после отказа узла, накопителя или сетевого пути. Его нельзя получить простым объединением нескольких серверов: нужны согласованная схема размещения данных, правила принятия решений, резервирование инфраструктуры и проверка со стороны приложения.
Главный вопрос перед покупкой звучит так: какой отказ система обязана пережить, с какой потерей данных и за какое время? Ответ определяет число независимых узлов, политику защиты, резерв ёмкости, сеть и программный стек. Разберём проектирование хранилища — от двухузловой схемы до распределённого кластера. Расчёты ниже учебные; они показывают методику и не являются результатами испытаний конкретной комплектации.
Как работает отказоустойчивый кластер хранения?
Кластер размещает копии данных или фрагменты с избыточностью на разных устройствах и обслуживает запросы по предусмотренным правилам даже при недоступности части оборудования. Для этого исправным компонентам должны быть доступны нужные данные, сеть, служебные роли и право продолжать работу. После отказа система восстанавливает заданный уровень защиты на оставшихся ресурсах либо после замены компонента.
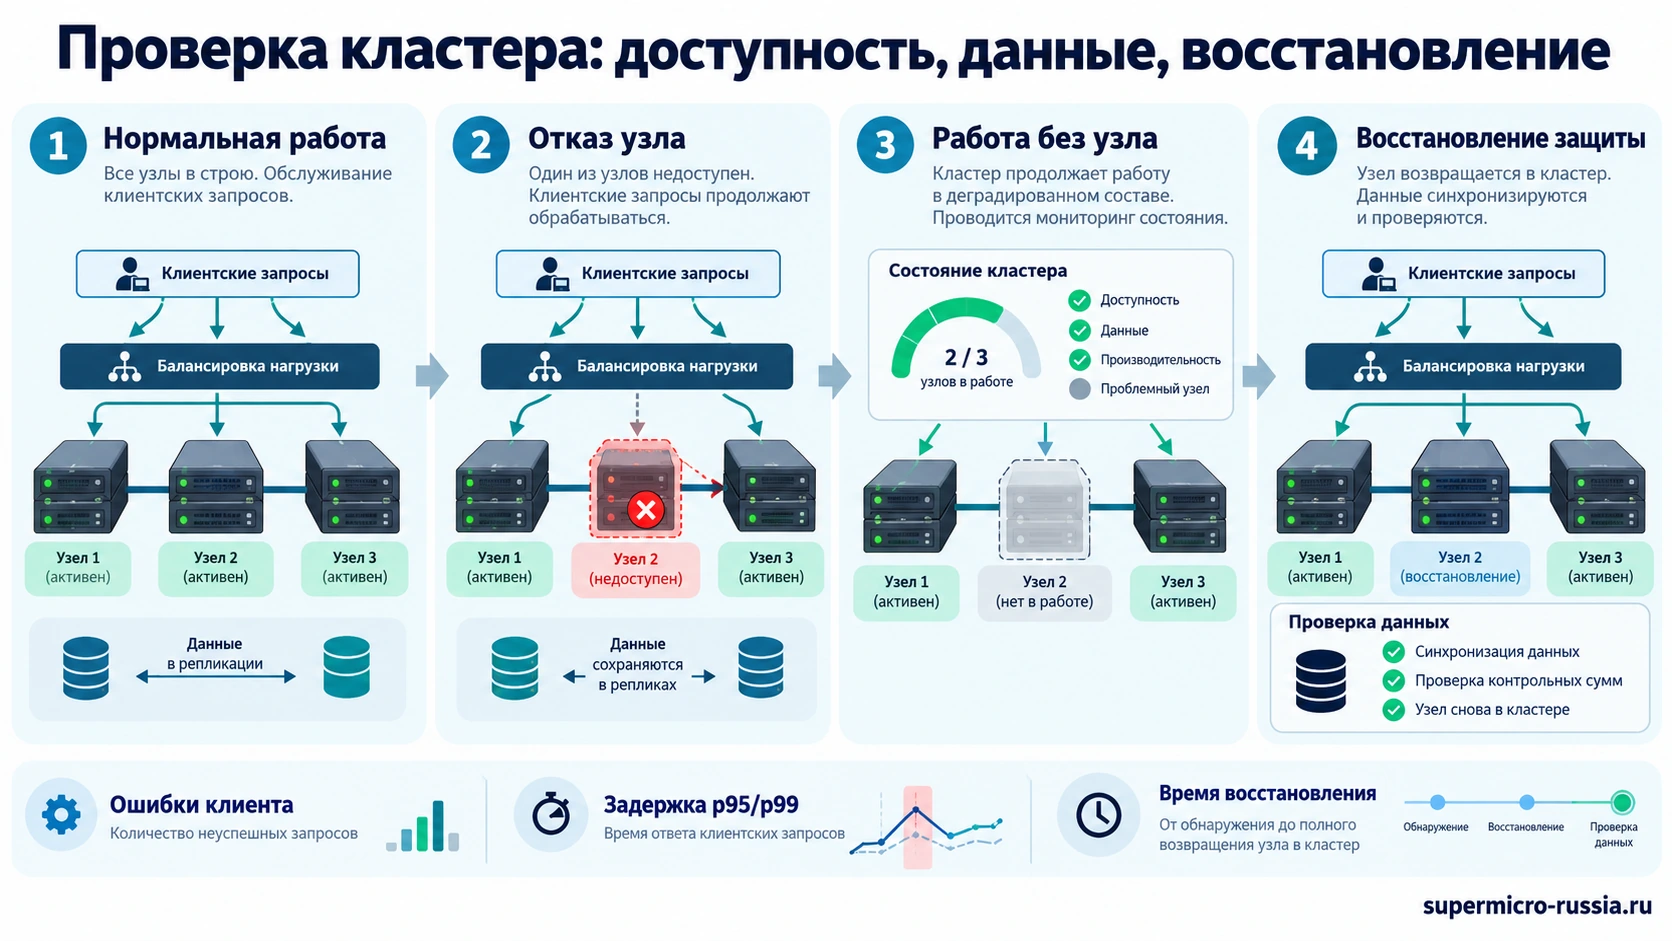
Проверяют четыре независимых результата: данные сохранились; клиент получил доступ; задержка осталась приемлемой; защита восстановилась. Зелёный индикатор в панели управления подтверждает только часть этой цепочки. Файловая шара может быть недоступна из-за шлюза или DNS при полностью исправном распределённом хранилище.
Показательный мотив проекта Linus Tech Tips на Supermicro GrandTwin сформулирован от первого лица: «У всех версий нашего сервера для видеомонтажа была общая проблема: он был один». Это перевод фрагмента описания проекта. Замена одиночной системы кластером устраняет зависимость от одного сервера только в пределах правильно спроектированной архитектуры.
Что задать сначала: RPO, RTO и допустимую деградацию
RPO — допустимая потеря последних изменений, выраженная временем. RPO 15 минут допускает потерю соответствующего интервала данных при оговорённом событии. RPO 0 означает требование сохранить подтверждённые записи в определённых сценариях отказа; оно не защищает от удаления данных администратором или программой.
RTO — целевое время восстановления сервиса. В него входят обнаружение неисправности, переключение, повторное подключение клиента и действия приложения. Пять секунд на изменение роли в кластере не равны пяти секундам простоя всей бизнес-операции.
| Требование | Как записать в ТЗ | Почему это меняет проект |
|---|---|---|
| Потеря данных | Подтверждённые записи сохраняются при отказе одного узла | Нужны подходящие подтверждения записи и размещение защиты |
| Восстановление доступа | Клиент снова читает и записывает в течение 60 секунд | Важны протокол, шлюзы, тайм-ауты, приложение |
| Производительность | При одном отказе сохраняется заданная нагрузка и p99 | Нужен запас сети, CPU и дискового ввода-вывода |
| Восстановление защиты | Срок перестроения измеряется под рабочей нагрузкой | Нужны свободная ёмкость и ресурсы для recovery |
Для масштаба: доступность 99,9% за условные 365 дней соответствует примерно 8 часам 46 минутам недоступности; 99,99% — 52 минутам 34 секундам; 99,999% — 5 минутам 15 секундам. Это арифметика календарного интервала, а не обещание конкретной системы. В договоре отдельно определяют время обслуживания, границы измерения и исключения.
Два контроллера, два сервера или распределённое хранилище?
Под словом «кластер» скрываются разные схемы. Нельзя переносить число узлов, способ защиты и требования одного продукта на другой.
| Архитектура | Где находятся данные | Что проверять |
|---|---|---|
| Два сервера и общая СХД | На внешней системе хранения | Отказоустойчивость самой СХД, multipath, контроллеры, дисковые полки и клиентский сервис |
| Два узла с синхронной репликацией | На локальных накопителях обоих узлов | Арбитраж, fencing, поддерживаемые расстояния и задержки, поведение при потере связи |
| Распределённое SDS | На нескольких storage-узлах | Размещение копий/фрагментов, служебные роли, кворум, запас для перестроения |
| Активный сервер и резервная копия | Рабочая копия плюс отдельный репозиторий | Время развёртывания и восстановления; автоматического HA может не быть |
Если нужны прежде всего вычислительные узлы для ВМ, состав готового проекта удобнее обсуждать через решение для кластера виртуализации Supermicro. Здесь рассматриваем другой слой: как переживает отказ само хранилище и как убедиться, что клиент продолжает работать.
Два сервера часто позволяют снизить стартовые затраты, но не отменяют третью независимую роль арбитража, когда её требует выбранный стек. Свидетель не хранит дополнительную полную копию рабочих данных и не заменяет резервный storage-узел. Общая СХД также не становится отказоустойчивой только потому, что к ней подключены два хоста.
Почему несколько узлов в одном шасси — общий риск
Домен отказа — группа компонентов, которые могут стать недоступны из-за одной причины. Для диска это может быть устройство, для узла — материнская плата, для нескольких узлов — шасси, коммутатор, линия питания или стойка.
У многоузловой платформы отдельные CPU и RAM каждого узла не устраняют все зависимости от общего корпуса. Нужно проверить распределение питания, сетевых подключений, охлаждения и обслуживания. Четыре storage-узла в одном шасси способны одновременно стать недоступны при событии, которое не сводится к отказу одной платы.
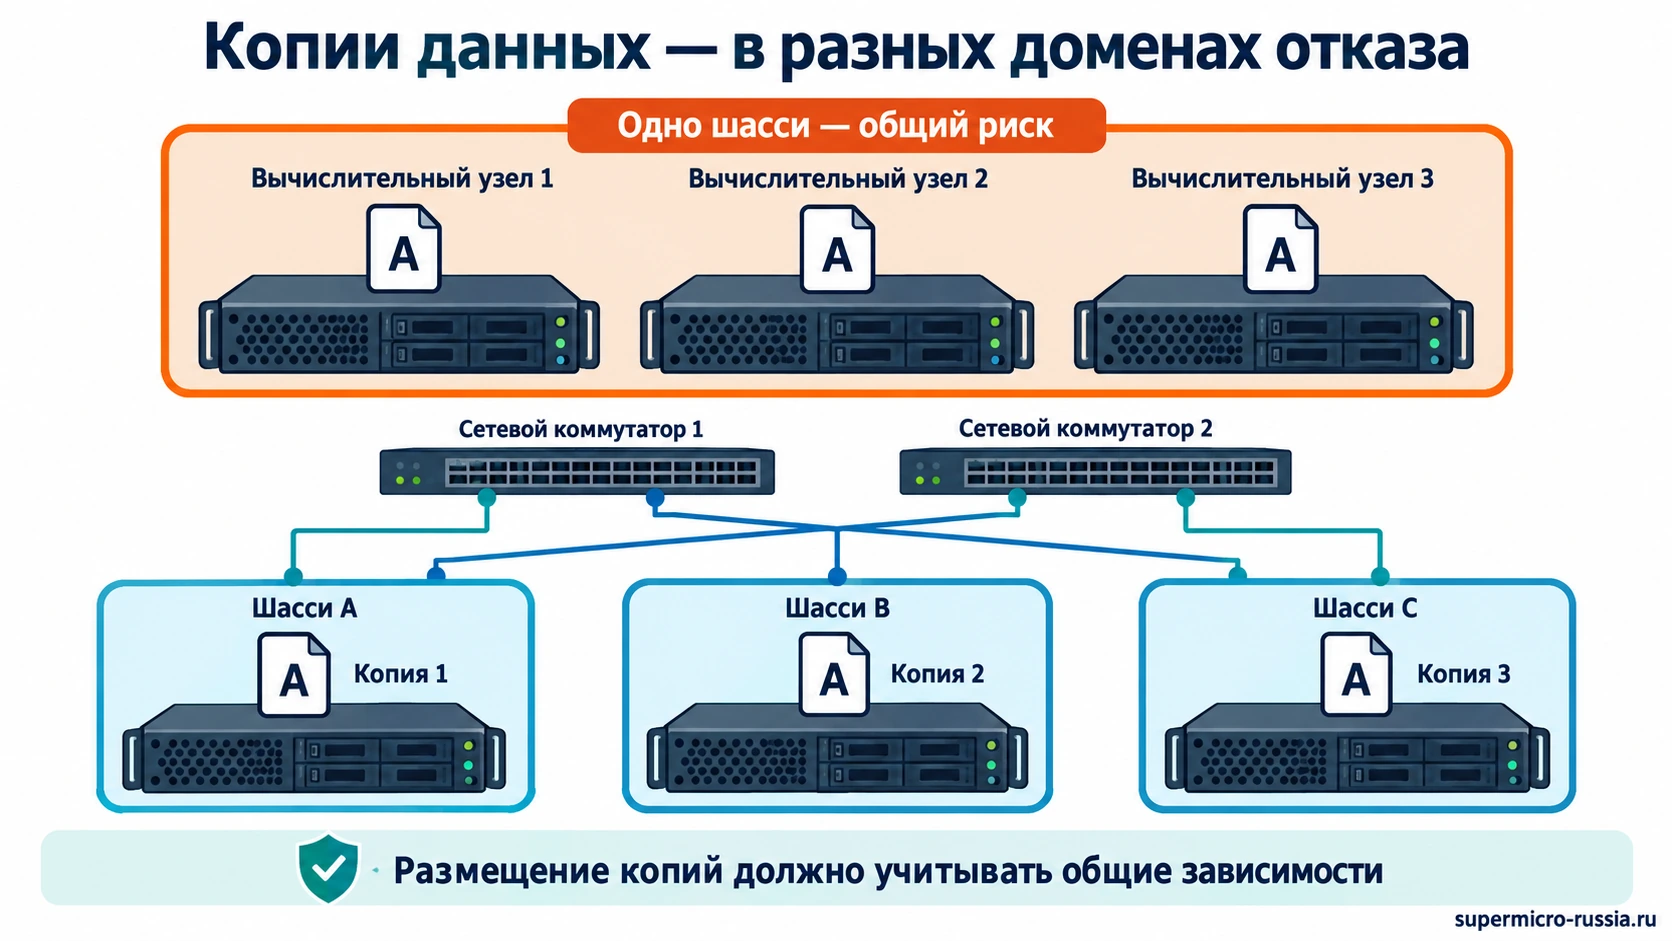
Политика размещения данных должна отражать физическую топологию. Если три реплики лежат на трёх узлах одного корпуса, правило «разные host» выполнено, но защита от потери корпуса отсутствует. Если требуются три независимые копии на уровне шасси, нужны соответствующие независимые шасси и поддерживаемое правило размещения.
Та же логика действует для служебных ролей. Три монитора, питающиеся от одной PDU, не дают независимого голосования при отказе этой PDU. Два блока питания, включённые в один источник, защищают от отказа модуля, но не от потери общего источника. Схему A/B проверяют по всей цепочке, включая оборудование сети.
Сколько серверов нужно и зачем кворум?
Число серверов определяется программной системой, схемой защиты, доменами отказа и запасом после неисправности. Универсального правила «три сервера достаточно для любого кластера» нет. Например, у Ceph мониторы и OSD выполняют разные функции, а у конкретной версии WEKA минимальная конфигурация определяется собственными требованиями. Для новой bare-metal-инсталляции WEKA 6.0 базовый минимум составляет восемь серверов; это не минимальное число для всех SDS.
Кворум позволяет согласовать состояние управляющей системы. Для большинства из N голосов требуется floor(N/2) + 1. В конфигурации Ceph MON три монитора требуют двух доступных голосов, пять — трёх. Четыре монитора требуют трёх голосов и по допустимому числу потерь не превосходят три.
| Число Ceph MON | Большинство | Сколько MON можно потерять с сохранением большинства |
|---|---|---|
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
Эта таблица относится к голосованию мониторов, а не к доступности всех данных. Даже при наличии кворума конкретная группа данных может не обслуживать запись из-за нехватки реплик. И наоборот: наличие дисков с данными не заменяет необходимые управляющие роли.
При сетевом разделении важно исключить ситуацию, когда обе стороны независимо принимают несовместимые записи. В двухузловых стеках для этого применяют предусмотренные продуктом механизмы арбитража и fencing. Нельзя включать запись на изолированной стороне «для доступности», не понимая последствий для согласованности.
Репликация или erasure coding: как считать защиту
При трёх полных копиях 1 ТБ логических данных занимает приблизительно 3 ТБ физических ресурсов до дополнительных накладных расходов. Для erasure coding данные делят на k информационных и m защитных фрагментов. Базовая доля полезной ёмкости равна k / (k + m).
| Схема | Физический объём на 1 ТБ данных | Доля данных до резервов | Важное ограничение |
|---|---|---|---|
| 2 полные копии | Около 2 ТБ | 50% | После потери одной копии остаётся один экземпляр |
| 3 полные копии | Около 3 ТБ | 33,3% | Продолжение записи зависит от политики и состояния реплик |
| EC 4+2 | Около 1,5 ТБ | 66,7% | Нужны подходящие независимые домены для шести фрагментов |
| EC 8+2 | Около 1,25 ТБ | 80% | Выше требования к топологии и анализу восстановления |
EC экономит место, но добавляет вычисления и обмен при записи и восстановлении. Для мелких перезаписей, больших последовательных файлов и архивных объектов результаты различаются. Поддержка EC для нужного вида доступа, метаданных и операций зависит от стека и версии; нельзя выбирать профиль только по проценту полезной ёмкости.
В Ceph параметр size задаёт желаемое число реплик, а min_size — минимальное число доступных реплик для обслуживания операций соответствующего пула. Для size=3 и min_size=2 работа с одной репликой не разрешается этой политикой. Изменение min_size ради снятия блокировки не восстанавливает защиту и может увеличить риск потери данных.
Как рассчитать полезную ёмкость и резерв для восстановления?
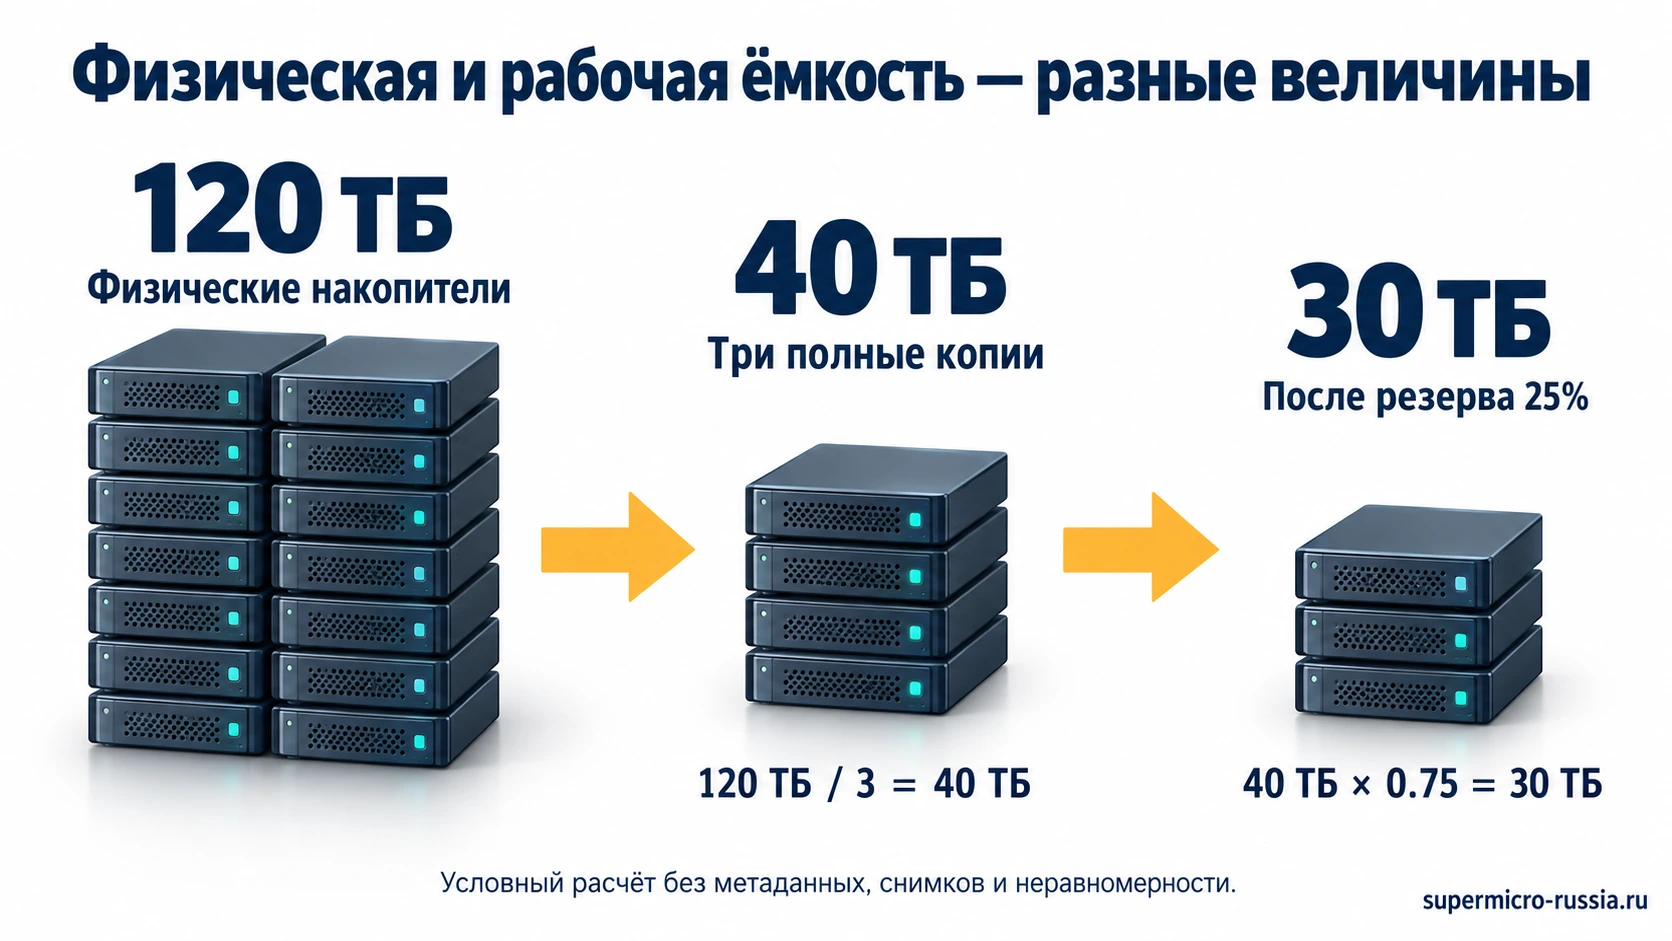
Разделяйте физическую ёмкость накопителей, логическую ёмкость после защиты и рабочий лимит заполнения. Простой предварительный расчёт для одинаковых дисков:
Рабочий объём ≈ физический объём × доля данных после защиты × (1 − резерв).
Для условных 120 ТБ и трёх копий получаем 40 ТБ до резервов. Если оставить 25% от этого объёма свободными, для плановой загрузки остаётся 30 ТБ. Затем учитывают метаданные, снимки, неравномерность, служебные области и фактическую методику ёмкости выбранного продукта. Резерв 25% здесь — допущение примера, а не универсальная настройка SDS.
Нужно проверить и состояние после отказа. Пусть шесть одинаковых узлов имеют по четыре SSD 7,68 ТБ. Физический объём — 184,32 ТБ, при трёх копиях — 61,44 ТБ до накладных расходов. Плановые 40 ТБ данных потребуют около 120 ТБ под реплики. После потери одного узла остаётся 153,6 ТБ физических ресурсов; после полного восстановления трёх копий расчётное заполнение оставшихся ресурсов составит 78,1%.
Это ещё не доказательство достаточности: фактические пороги, распределение и служебные расходы могут изменить результат. Если исчезают сразу два таких узла, остаётся 122,88 ТБ — почти весь объём уже нужен для тех же 120 ТБ реплик. Нормальное состояние с большим запасом превращается в практически непригодное для перестроения.
В минимальном кластере из трёх host-доменов при трёх репликах после потери одного host восстановить три независимые host-копии без добавления нового домена невозможно. Свободное место на двух оставшихся серверах не создаёт третий независимый сервер.
Какие CPU, RAM и накопители нужны storage-узлам?
Ресурсы storage-узла расходуются на клиентские операции, репликацию или кодирование, контроль целостности, сеть и восстановление. Конфигурацию подбирают под количество дисков, тип доступа и требования программного стека. Для NVMe-кластера ограничением нередко становится обработка операций или сеть раньше, чем номинальная скорость SSD.
RAM нужна не только для кэша: память потребляют OSD/службы хранения, индексы, метаданные, сетевые буферы и ОС. Универсальная норма «1 ГБ RAM на 1 ТБ» не учитывает ни число процессов, ни файловую нагрузку. Считать следует по ролям и ожидаемым пикам, включая recovery. Для сетевого адаптера и накопителей проверяют также привязку PCIe и NUMA: физически установленная карта не всегда имеет одинаковую доступность от всех CPU.
Для SSD важны устойчивая задержка, защита от потери питания, ресурс записи, совместимость прошивки и поведение после исчерпания буфера. Если приложение записывает 2 ТБ в сутки, при трёх копиях нижняя оценка записи на кластер — 6 ТБ в сутки до дополнительных операций стека и самих SSD. При равномерном распределении по 24 накопителям это 0,25 ТБ на диск в сутки; recovery, перекосы и write amplification требуют отдельного запаса.
Для подбора аппаратной основы полезно сравнить серверные системы хранения Supermicro по числу отсеков, доступным PCIe и возможностям сети. Подтверждение совместимости должно относиться ко всей сборке: платформа, SSD, NIC, прошивки, ОС и версия SDS.
Хватит ли 10 или 25 Гбит/с для кластера?
Скорость порта задаёт верхнюю границу передачи, но не скорость приложения. Без накладных расходов 10 Гбит/с соответствуют 1,25 ГБ/с, 25 Гбит/с — 3,125 ГБ/с, 100 Гбит/с — 12,5 ГБ/с. Реальная полезная скорость ниже и делится между клиентами, защитой данных и восстановлением.
Для условного восстановления 10 ТБ при реально доступной полезной скорости 0,5 ГБ/с арифметический минимум — 20 000 секунд, то есть 5 часов 33 минуты. При 1 ГБ/с — 2 часа 47 минут. Это оценка переноса одного объёма: чтение нескольких источников, EC, ограничения дисков и фоновая нагрузка способны увеличить время.
В трёхрепличной схеме клиентская запись 1 ГБ/с может требовать передачи дополнительных копий между узлами. Конкретный объём зависит от тракта записи и размещения. Поэтому сравнение только клиентских 1 ГБ/с с номиналом сетевого порта неполно: нужны также backend-трафик, двунаправленность, распределение по портам и запас на сбой пути.
Два адаптера или два порта не гарантируют удвоения скорости одного соединения. Нужны поддерживаемые bonding/multipath/маршрутизация и независимые коммутаторы. Приёмка должна включать отключение одного пути. MTU, VLAN, прошивки и драйверы настраивают согласованно, а RDMA используют только там, где его предусматривает выбранная архитектура.
Почему исправные данные могут быть недоступны по SMB или NFS?
Клиент видит сервис, а не набор storage-дисков. Для файлового доступа могут понадобиться отдельные шлюзы, виртуальное имя или адрес, каталог пользователей, DNS, Kerberos и механизмы восстановления сессии. Один NFS-шлюз перед распределённым хранилищем возвращает зависимость от единственного сервера.
У SMB проверяют поддержку предусмотренных механизмов высокой доступности сервером и клиентом, сохранение открытых файлов и поведение блокировок. У NFS — режим экспорта, состояние сессий, повтор операций и тайм-ауты. Формулировка «файлы доступны после переподключения» существенно слабее требования «операция приложения завершилась без ошибки».
Для блочного доступа проверяют multipath, работу инициатора и согласованный доступ к файловой системе. Дать двум независимым серверам один LUN и одновременно смонтировать обычную локальную файловую систему для записи — не способ построить безопасный файловый кластер.
Когда подходит многоузловая Supermicro GrandTwin?
GrandTwin помогает разместить несколько независимых вычислительных узлов компактно и обслуживать их в составе общей платформы. Например, AS-2115GT-HNTF можно рассматривать как аппаратный кандидат для многоузлового проекта. Пригодность конкретной комплектации для SDS подтверждают требования выбранного решения и испытания; семейство сервера само по себе не является сертификатом совместимости.
Размещение нескольких шасси позволяет распределить узлы по физическим доменам. Но число корпусов, количество storage-ролей и схема защиты должны сойтись одновременно. Восемь серверных узлов в двух корпусах не превращаются в восемь независимых доменов уровня «шасси».
Отдельные стоечные серверы могут быть удобнее, когда проекту нужны независимое обслуживание корпусов, разный состав дисков или постепенная закупка узлов. Плотная компоновка выгодна при дефиците места, но решение принимают вместе с оценкой питания, охлаждения, кабелей и общего риска.
Пример проекта: 40 ТБ данных и работа при отказе одного узла
Пусть требуется файловое хранилище с ростом до 40 ТБ, сохранением подтверждённых записей при отказе одного storage-узла и восстановлением доступа клиента не дольше минуты. Требования к рабочим операциям: заданный набор чтений/записей, одновременные пользователи и предельная p99 задержка. Последние показатели сначала измеряют или моделируют, а не заменяют средним числом сотрудников.
- Зафиксировать защищаемое событие: потеря одного узла. Отдельно решить, входит ли отказ всего шасси или стойки.
- Выбрать стек и тип доступа, затем допустимую политику защиты и количество ролей.
- Рассчитать ёмкость в штатном и деградированном состоянии. В приведённой шестиюзловой модели проверить как минимум 120 ТБ реплик плюс служебные расходы после потери узла.
- Разнести управляющие роли, сеть и питание в соответствии с защищаемыми событиями.
- Измерить нагрузку одновременно с восстановлением защиты и с одним недоступным сетевым путём.
- Проверить независимую копию и восстановление выбранного каталога или набора объектов.
Если требование расширяют до потери корпуса, расчёт повторяют с количеством узлов, исчезающих вместе с ним. Нельзя сохранить старый расчёт одного host и добавить в ТЗ фразу «защита от отказа шасси»: это другой проект.
Как проверить кластер перед вводом в эксплуатацию?
Испытания выполняют на подготовленном стенде или в согласованное окно с проверенной копией и планом возврата. Во время теста непрерывно создают, читают и проверяют контрольные суммы тестовых данных. Отказ фиксируют по внешним часам и журналам клиента, а не только по панели SDS.
| Сценарий | Что измерить | Условие завершения проверки |
|---|---|---|
| Остановка одного storage-узла | Ошибки, пауза, задержка, сохранность подтверждённых записей | Клиент работает в оговорённых пределах |
| Потеря одного сетевого пути | Переключение маршрута и доступная полоса | Нет скрытой зависимости от одного коммутатора |
| Изоляция части кластера | Кворум, доступность по сторонам, запрет конфликтующих записей | Нет неподдерживаемого split-brain |
| Замена накопителя или узла | Время перестроения и нагрузка на исправные компоненты | Восстановлена заданная защита |
| Обслуживание узла | Перенос ролей, drain, возврат и повторная синхронизация | Регламент воспроизводим другим инженером |
| Восстановление резервной копии | Время, полнота, права доступа, открытие приложением | Восстановленные данные реально пригодны к работе |
Для тестов производительности сохраняют профиль операций, размер данных, блоки, глубину очереди, долю чтения/записи и длительность. Нагрузка должна выходить за пределы удобного попадания всего набора в RAM. Сравнивают штатное состояние, отказ и recovery. Высокая скорость на пустой системе не доказывает пригодность заполненного хранилища.
Как учесть общий отказ, обслуживание и стоимость защиты?
Как связать запас ёмкости с самым крупным доменом отказа
Проверяйте не средний сервер, а самое крупное событие, включённое в требования. Если в одном корпусе находятся четыре из восьми storage-узлов, потеря корпуса убирает половину ресурсов сразу. Запас, достаточный для одного диска или host, для такого случая может оказаться бессмысленным. Это относится и к управляющим ролям: при распределении трёх голосов как «два в первом корпусе, один во втором» потеря первого корпуса убирает большинство.
Для предварительной проверки можно посчитать физические ресурсы после события и сравнить их с объёмом всех защищённых данных. Но этого недостаточно: необходимо также проверить возможность заново разложить защиту по оставшимся независимым доменам. Пространство может оставаться свободным, а правило размещения — невыполнимым.
Условные 60 ТБ свободного места в одном сохранившем работоспособность шасси не заменяют три независимых корпуса для трёх копий с размещением по шасси. Такая проверка особенно важна для плотных многоузловых систем, где арифметическое число серверных плат выглядит большим, чем количество независимых корпусов.
Как оценить производительность при обслуживании, а не только при аварии
Плановое обслуживание создаёт похожее сокращение ресурсов, но может длиться дольше переключения. Для проекта полезны два отдельных режима: внезапная потеря узла и управляемый вывод. В первом проверяют обнаружение и согласованность; во втором — перенос ролей, освобождение ресурсов и допустимое окно работ.
Если кластер проектировали на один отказ, во время обслуживания один запас уже занят. Второе событие может вывести систему за пределы согласованной защиты. Прежде чем обновлять firmware следующего узла, нужно закончить синхронизацию предыдущего, вернуть служебные роли и проверить отсутствие иных деградаций.
Для масштаба представим шесть одинаковых узлов, каждый из которых в данном профиле способен обслуживать 100 условных единиц нагрузки. При рабочей нагрузке 400 единиц средняя загрузка — 66,7%. После потери узла на пяти остаётся 80% расчётной способности. Если recovery дополнительно занимает эквивалент 80 единиц, свободный запас уменьшается до 20. Это учебная линейная модель: настоящий storage-стек масштабируется иначе, а узким местом может стать сеть. Её смысл — включить восстановление в бюджет нагрузки.
Какие расходы сравнивать с ценой простоя
В стоимости кластера есть минимум четыре части: оборудование, ПО и сопровождение, работы по внедрению, регулярная эксплуатация. Добавьте вторую сеть, запасные SSD, место и питание, если они требуются выбранной схемой. Сравнение «один сервер против двух» пропускает значительную часть проекта.
Цена часа простоя тоже должна иметь состав: недоступные сотрудники, задержанные операции, восстановительные работы и возможные договорные последствия. Допустим, дополнительная стоимость защиты составляет 500 000 ₽, а оценка последствий простоя — 50 000 ₽ в час. Эквивалент — десять часов предотвращённой недоступности. Это не расчёт срока окупаемости: для него ещё нужны вероятность событий, горизонт эксплуатации и проверка того, какие именно простои кластер действительно предотвращает.
Покупка HA не устраняет ошибки релиза, утрату доступа к каталогу пользователей или повреждение приложения автоматически. Раздельный список предотвращаемых и непредотвращаемых событий делает сравнение бюджета предметным и помогает выбрать уровень защиты без избыточной сложности.
Что контролировать после запуска
Нужны оповещения о деградации защиты, росте очередей и задержек, исчерпании свободного места, ошибках носителей, состоянии сетевых путей и служебных ролей. Для SSD дополнительно отслеживают ресурс записи, температуру и предсказуемость задержки. Доставка уведомления и реакция ответственного человека — часть проверки, а не необязательное дополнение.
Обновления выполняют в поддерживаемом порядке с проверкой совместимости версий. Перед выводом следующего узла убеждаются, что предыдущий вернулся и защита восстановилась. Длительное существование кластера в состоянии «одна копия временно отсутствует» превращает очередное обслуживание в риск второго события.
Резервная копия должна переживать иной набор событий, чем кластер: ошибку удаления, шифрование, компрометацию учётной записи и потерю площадки в пределах требований проекта. Репликация быстро распространяет корректно принятые, но ошибочные изменения; сама по себе она не даёт нужной глубины истории.
Частые вопросы об отказоустойчивом хранении
Можно ли собрать кластер из двух Supermicro?
Да, если выбранный программный продукт поддерживает такую схему, а данные, арбитраж, fencing и сетевые пути спроектированы согласованно. Для произвольного распределённого хранилища два сервера не являются универсальным минимумом. Свидетель также не заменяет третью копию данных.
Достаточно ли RAID в каждом сервере?
RAID защищает от предусмотренных отказов накопителей внутри своей системы. Он не обеспечивает доступ к данным при потере всего сервера и не организует согласованное переключение сервиса. В SDS локальный RAID может быть не нужен или не рекомендован — это определяется стеком.
Можно ли смешивать узлы разных поколений?
Иногда можно, но нужно подтвердить поддержку, баланс ёмкости, число процессов и влияние медленного узла на запись и recovery. Номинальная совместимость серверов не доказывает, что смешанная конфигурация выдержит необходимый профиль нагрузки.
Будет ли переключение совершенно незаметным?
Это зависит от протокола, клиента, приложения и тайм-аутов. Требование «без ошибки пользовательской операции» проверяют отдельно от факта сохранности данных. Приёмка должна содержать измеримый предел паузы и правила повторного запроса.
Когда кластер избыточен?
Когда согласованные RPO/RTO выполняются более простой системой с проверенным восстановлением, а стоимость и сложность HA не оправданы. Сравнивают полный состав оборудования, ПО, сети, сопровождения и регулярных испытаний, а не только цену двух дополнительных серверов.
Что передать для расчёта конфигурации Supermicro
Подготовьте текущий объём и прогноз роста, тип доступа, размеры файлов или блоков, профиль нагрузки, требования к p95/p99, RPO/RTO и перечень защищаемых событий. Добавьте схему стоек, питания и сети, сведения о действующих серверах, ограничения по размещению и выбранный программный стек либо список допустимых вариантов.
В спецификацию проекта включают не только узлы и SSD, но и NIC, коммутаторы, оптику или DAC, лицензии, поддержку, запасные компоненты и процедуру приёмки. Для проработки аппаратной части можно запросить конфигурацию и коммерческое предложение. Критерием готовности станет подтверждённая работа при согласованных отказах, а не количество серверов в перечне поставки.