Кейс: как Lambda запустила GPU-кластеры на Supermicro HGX B200
Получить доступ к 16 GPU и запустить на них распределённое обучение — разные задачи. Между ними находятся межсерверная сеть, общие данные, программное окружение, планировщик и возможность продолжить работу после сбоя. В проекте Lambda аппаратные системы Supermicro с NVIDIA HGX B200 превращены в облачный продукт 1-Click Clusters с доступом к взаимосвязанным ускорителям.
В ноябре 2026 года Robert Brooks IV, участник команды основателей и коммерческий директор Lambda, рассказал о развёртывании B200 в Колумбусе и диапазоне кластеров от 16 до 2000 GPU. Это инженерный разбор публичного проекта Lambda. Расчёты ниже помогают оценить собственную инфраструктуру; они не являются замерами её дата-центра.
Что Lambda построила в Колумбусе и почему выбрала Supermicro
Lambda предоставляет вычислительные мощности для задач искусственного интеллекта. В проекте в Колумбусе, штат Огайо, серверы Supermicro с NVIDIA Blackwell стали частью инфраструктуры на площадке Cologix. Пользователь получает вычислительный ресурс через облачный сервис, а не собирает серверы и сеть самостоятельно.
В интервью Andrew из Supermicro спросил: «Почему Lambda выбрала Supermicro?» Robert ответил: «Мы выбираем Supermicro уже десять лет» (перевод с английского). Для этого проекта партнёрство было способом быстрее вывести B200 в доступный клиентам сервис. Это объясняет выбор поставщика, но не заменяет сравнение конфигураций или испытание конкретной нагрузки.
В Колумбусе развернули тысячи B200, соединённых InfiniBand. В 1-Click Clusters можно получить группу взаимосвязанных GPU. Удобство подключения к сервису Lambda считает самостоятельной частью продукта, наряду с аппаратной производительностью. Указанный в интервью диапазон 16–2000 GPU относится к описанию сервиса на тот момент; размер доступной группы, регион и условия выделения проверяют перед заказом.
Переносить этот кейс на собственный проект стоит через требования: сколько GPU должны работать совместно, как быстро запускается среда, где лежат данные и кто отвечает за восстановление. Число ускорителей само по себе не отвечает ни на один из этих вопросов.
Чем кластер HGX B200 отличается от нескольких отдельных GPU-серверов
NVIDIA HGX B200 — платформа с восемью SXM-ускорителями, связанными внутри узла через NVLink и NVSwitch. Для совместной работы нескольких таких узлов требуется отдельная сеть. InfiniBand в проекте Lambda решает межсерверный обмен; локальный NVLink остаётся внутри соответствующего вычислительного домена. Подмена одного другим даёт неверное представление о производительности.
B200 не следует путать с GB200 NVL72. Совпадение поколения Blackwell не делает восьмиускорительный HGX-сервер и стойку NVL72 одним изделием. Различаются процессорная платформа, масштаб связности, компоновка и требования к инженерной инфраструктуре.
| Уровень | Что объединяет | Что проверять заказчику |
|---|---|---|
| GPU | Вычисления и локальную HBM | Объём памяти, поддерживаемые форматы, ошибки и ограничения мощности |
| Восьмиускорительный HGX-узел | GPU, CPU, RAM, внутреннюю связность и ввод-вывод | Топологию, обмен между GPU, версии драйверов и прошивок |
| Межузловая фабрика | Несколько HGX-серверов | Коллективные операции, перегрузку, маршруты и деградацию отдельных соединений |
| Облачный кластер | Выделенный ресурс и пользовательскую среду | Очередь, доступ к данным, права, учёт потребления и восстановление |
Для сравнения актуальных аппаратных классов подходит раздел GPU-серверов Supermicro. Выбирать конкретную платформу нужно после определения межузловой нагрузки: восемь независимых сервисов и одно распределённое обучение предъявляют разные требования к сети.
Сколько серверов потребуется для 16, 64, 256 или 2000 GPU
Если каждый вычислительный узел содержит восемь GPU, число узлов равно NGPU / 8. Для конфигурации с B200 по 180 ГБ можно отдельно посчитать суммарную физическую HBM. Это арифметика выбранного исполнения, а не обещание выделить приложению единый непрерывный объём памяти.
| Ускорители | Узлы по 8 GPU | Суммарная HBM при 180 ГБ на GPU | Главный вопрос масштаба |
|---|---|---|---|
| 16 | 2 | 2,88 ТБ | Что меняется при выходе за пределы одного узла |
| 64 | 8 | 11,52 ТБ | Как совместить загрузку данных и коллективные операции |
| 256 | 32 | 46,08 ТБ | Как ведут себя несколько групп и одновременные checkpoint |
| 2000 | 250 | 360 ТБ | Как организованы резерв, обслуживание и размещение заданий |
Здесь ТБ — десятичная единица: 1000 ГБ. В планировщике и ОС объёмы могут отображаться в GiB/TiB. Складывать эти значения без пересчёта нельзя. Также сумма HBM ничего не говорит о том, поместится ли конкретная модель: память занята весами, рабочими буферами, активациями и состоянием исполнения, а распределение зависит от выбранного параллелизма.
Восемь GPU на узел — допущение этой таблицы. В инфраструктуре дополнительно нужны управляющие и storage-узлы, сетевые устройства и инженерные системы. Их количество из числа GPU не выводится. Для коммерческого предложения нужен полный перечень оборудования и отдельно перечень оплачиваемых программных компонентов.
Как понять, что модели действительно нужен многоузловой кластер
Начинают с задачи, которая не укладывается в один сервер либо не выполняется за допустимое время. Для модели на 70 млрд параметров веса в BF16 занимают около 140 ГБ до служебных расходов: 70 × 109 × 2 байта. Обучение требует значительно больше памяти. Например, условная схема с 16 байтами на параметр для совокупности весов, градиентов и состояния оптимизатора даёт 1,12 ТБ; состав этих 16 байт зависит от реализации и точности.
Этот расчёт нельзя превращать в готовую конфигурацию. Активации, длина последовательности, batch size, резерв памяти, активационный checkpointing и шардирование изменят потребление. Поэтому сначала измеряют короткий воспроизводимый запуск на подходящем узле, затем проверяют масштабирование.
Если один сервер уже укладывается в память и время, второй должен дать измеримый результат: сократить длительность задания, увеличить число одновременных запросов либо обеспечить отдельную очередь. Для независимых инференс-сервисов часто полезнее несколько автономных узлов. Сложная общая фабрика оправдана, когда приложение действительно использует обмен между ними.
Почему InfiniBand не гарантирует линейного ускорения
В распределённом обучении часть времени уходит на обмен градиентами, сбор тензоров и синхронизацию. Добавление GPU сокращает вычислительную часть, но может увеличить долю коммуникаций. Значение имеют алгоритм, размеры сообщений, соответствие GPU сетевым адаптерам и маршрут между выбранными узлами.
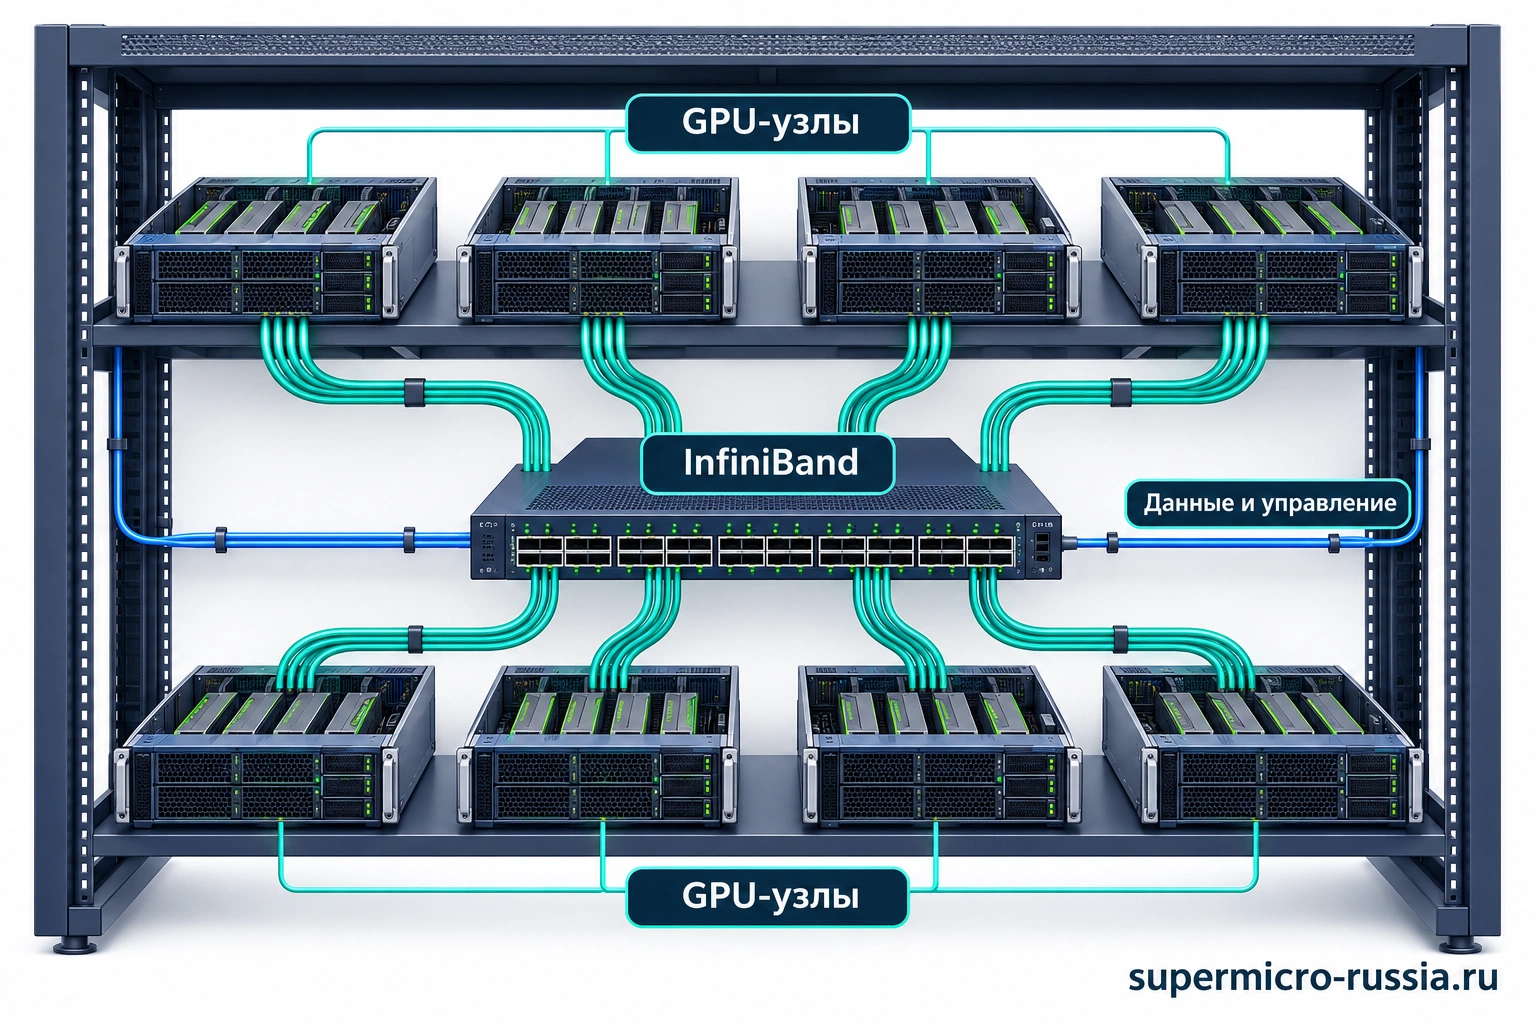
Проверять нужно как минимум один узел, пару узлов и целевую группу. Для NCCL полезны AllReduce, AllGather и All-to-All: они создают разный трафик. В журнале сохраняют число процессов, объём сообщений, точность результата и используемый транспорт. Колонка busbw в nccl-tests не равна фактической скорости одного физического порта, а хорошие результаты только на больших сообщениях не подтверждают эффективность коротких обменов.
Отдельный тест проводят при одновременной работе соседних заданий. Без этого хорошо выглядящий изолированный замер может скрыть перегруженный uplink, неудачное размещение ресурсов или конкуренцию за общий путь к хранилищу. Подробное разделение сетей уже разобрано в материале об архитектуре AI Factory и сетевой фабрике. Для выбранной группы GPU дополнительно проверяют, как размещение узлов влияет на полезную скорость задания.
Как посчитать эффективность масштабирования и стоимость задания
Пусть одна и та же работа на восьми GPU занимает 600 секунд. На 16 GPU она выполняется за 380 секунд, а на 32 — за 210. Это условный пример, не результат тестирования B200. Полезная работа, объём данных и критерий качества во всех трёх запусках одинаковы.
| GPU | Время | Ускорение относительно 8 GPU | Эффективность масштабирования | Расход GPU·ч |
|---|---|---|---|---|
| 8 | 600 с | 1,00 | 100% | 1,33 |
| 16 | 380 с | 1,58 | 78,9% | 1,69 |
| 32 | 210 с | 2,86 | 71,4% | 1,87 |
Формулы просты: ускорение S = T8 / TN; эффективность E = S / (N / 8); расход GPU·ч = N × TN / 3600. Более крупная конфигурация завершила работу быстрее, но потребовала больше оплачиваемых GPU-часов. Это может быть выгодно при жёстком сроке, однако экономию следует доказывать отдельно.
Для обучения сравнивают время до одинакового качества модели, а не только число шагов в секунду. Изменение глобального batch size, learning rate или состава данных способно испортить сравнение. Для инференса фиксируют длину входа и выхода, долю повторяющегося контекста, ограничения TTFT и задержки последующих токенов.
При оценке собственного кластера добавляют стоимость сети, хранения, электроэнергии, лицензий и инженерного сопровождения. Для облака — минимальный оплачиваемый срок, простой зарезервированного ресурса, хранение данных и условия возврата мощности после аварии. Сравнение по цене одного GPU в час без этих условий неполно.
Как рассчитать данные и контрольные точки, чтобы GPU не простаивали
Входной поток оценивают по фактическому dataloader. Если восемь узлов должны получать по 3 ГБ/с, суммарно требуется 24 ГБ/с полезного чтения. Но такая средняя величина ещё не учитывает одновременное открытие множества файлов, холодный кэш и распределение выборки. Тест крупного последовательного файла здесь может оказаться бесполезным.
Для checkpoint важна длительность остановки или фоновой записи. Условная контрольная точка объёмом 1 ТБ при устойчивой полезной скорости 40 ГБ/с записывается минимум за 25 секунд. Если восемь заданий одновременно сохраняют по 1 ТБ в общее хранилище с общей скоростью 200 ГБ/с, одна только передача займёт не меньше 40 секунд. Сериализация, метаданные и синхронизация добавят время.
400 Гбит/с соответствуют 50 ГБ/с до накладных расходов. Это не гарантия 50 ГБ/с записи: ограничение может находиться в клиенте, сети, сервере хранения или самих накопителях. В спецификации полезно разделить полосу порта и измеренную скорость операции приложения.
Аппаратные варианты для этого слоя находятся в категории серверов хранения. Для небольшого теста допустим локальный набор данных, но перед промышленным запуском отдельно проверяют его распространение на все узлы и восстановление после потери локального диска.
Какие требования предъявляет охлаждение GPU-кластера
В инфраструктуре Lambda используются решения жидкостного охлаждения Supermicro. Однако переносить тип охлаждения одной системы на каждую машину всего проекта нельзя: портфель включает разные исполнения. Выбранная платформа, её GPU, CPU и комплект охлаждения должны составлять согласованную конфигурацию.
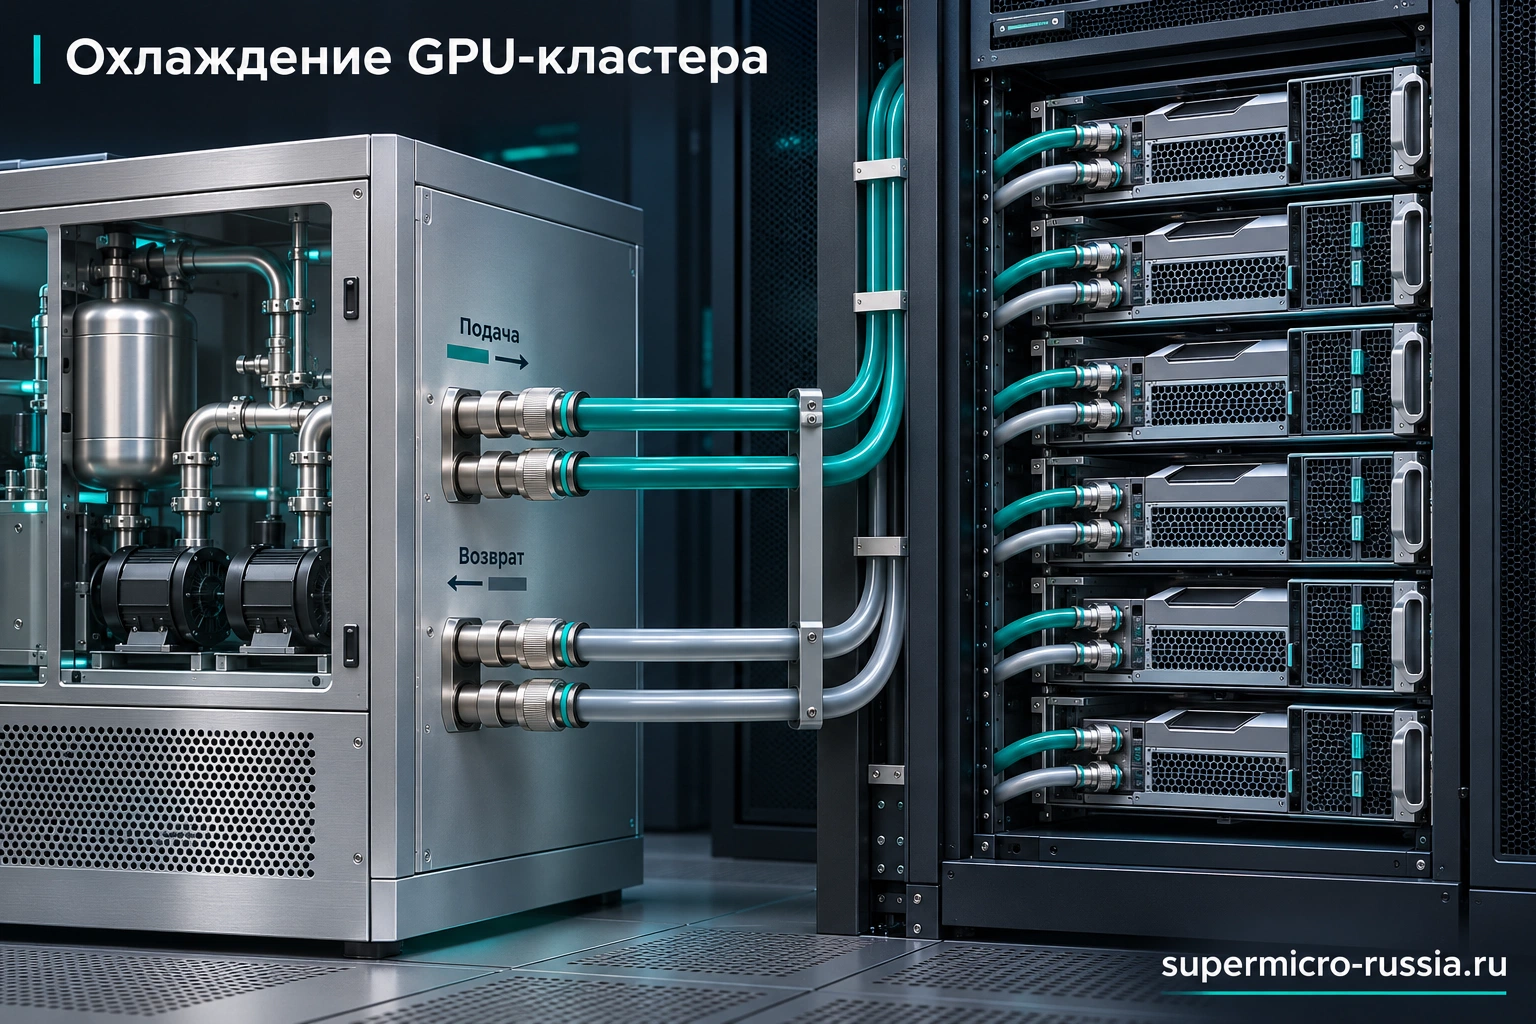
Для предварительной оценки расхода воды можно использовать Q = P / (ρ × c × ΔT). Если в жидкость отводится 100 кВт, перепад температуры составляет 10 °C, а теплоноситель по свойствам близок к воде, расход получится около 2,39 л/с, или 143 л/мин. Это расчёт идеализированного теплового баланса, а не настройка контура: состав жидкости, давление, сопротивление, допустимые температуры и запас задаются проектом.
Проверяют также воздушное тепло от оставшихся компонентов, мощность CDU и насосов, питание сетевых устройств и поведение системы при потере одного элемента охлаждения. Установленная мощность блоков питания не равна потреблению. Энергобюджет строят по рабочему и пиковому режимам согласованной конфигурации, а испытания отказов проводят по безопасной программе.
Что означает быстрый запуск облачного кластера на практике
Пользовательская ценность 1-Click Clusters — сокращение пути от запроса ресурса к доступной рабочей среде. За этой простотой должны стоять заранее подготовленные образы, распределение узлов, проверенная сеть и правила доступа. Кнопка запуска не загружает автоматически частный датасет и не исправляет несовместимый контейнер.
Для своей команды имеет смысл измерить весь путь: время ожидания мощности, выдачу доступа, перенос данных, загрузку контейнера, первый успешный шаг и сохранение результата. Именно этот интервал определяет, насколько инфраструктура удобна исследователю или прикладному разработчику.
На момент интервью Lambda уже обслуживала тысячи пользователей из Европы. Robert описал подключение через создание учётной записи и добавление платёжного средства. Для корпоративного заказчика к этому добавляются договорные условия, проверка региона и политики данных; простота интерфейса не отменяет их.
Облачный сервис с пользователями из Европы не обязательно означает хранение их данных в европейском регионе. Адрес площадки, юрисдикцию, договор, доступность услуги и правила передачи данных проверяют отдельно. Интервью о простом подключении не является гарантией доступа из любой страны.
Как принять GPU-кластер до начала оплачиваемой эксплуатации
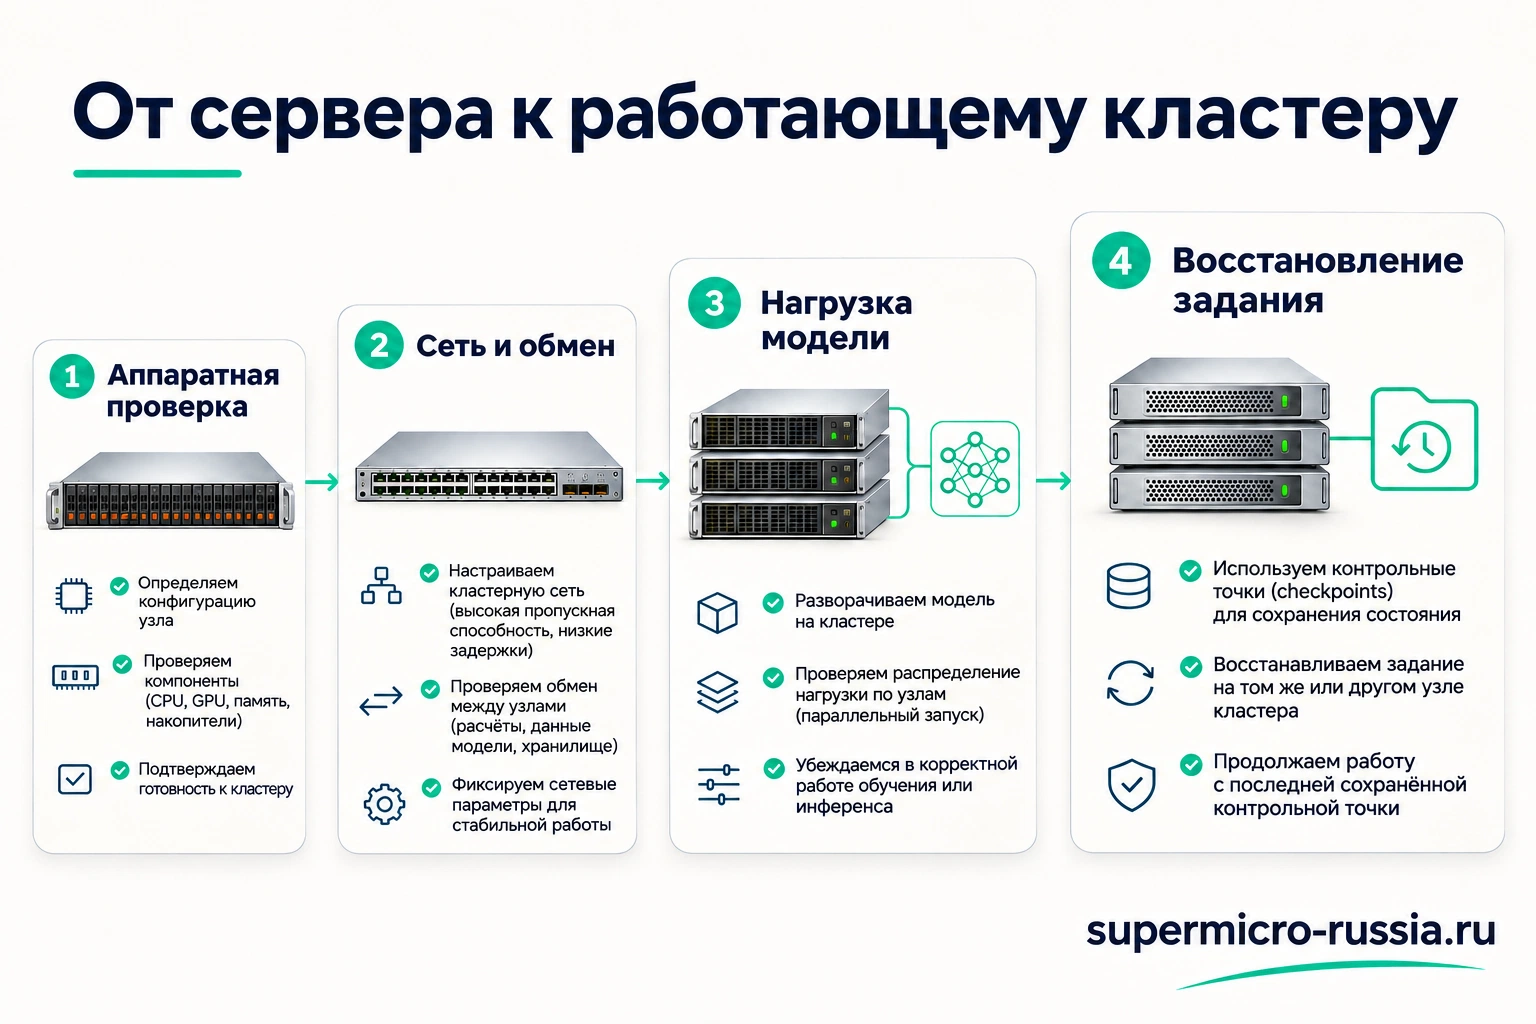
- Сверить инвентаризацию: GPU, HBM, RAM, сетевые адаптеры, накопители, версии BIOS/BMC, драйверов и CUDA. Зафиксировать ограничения мощности.
- Проверить каждый узел отдельно: устойчивую нагрузку, ошибки памяти и GPU, температуры, частоты и внутренний обмен.
- Проверить межузловой транспорт и коллективные операции в нескольких размерах группы. Сохранить версии тестов и полные журналы.
- Запустить реальный датасет и выбранную модель. Измерить полезный результат, очередь, чтение и запись checkpoint.
- Повторить запуск рядом с другой нагрузкой, затем проверить восстановление задания из сохранённого состояния.
- Передать владельцу инструкции доступа, обновления и восстановления, а также границы ответственности за сервер, сеть, охлаждение и ПО.
Порог «годен» задают до испытаний: одинаковый тест, допустимое время, предел ошибок и условия деградации. Универсальное требование «GPU загружен на 100%» не подходит. Ускоритель может быть занят неэффективной работой, а корректный сервис — намеренно держать запас под пиковые обращения.
Дополнительные вопросы о кластерах на HGX B200
Можно ли смешать H100, H200 и B200 в одном задании?
Техническая возможность зависит от фреймворка, образа и способа распределения. Для синхронного обучения медленный участник может определять темп всей группы; различия памяти дополнительно усложняют размещение. Гетерогенный парк разумно сначала разделить на однородные пулы. Их совместное использование проверяют конкретным тестом, а не фактом наличия CUDA.
Заменяет ли Kubernetes Slurm?
Это разные подходы к организации работы. Выбор зависит от существующей платформы, пакетных заданий, требований к совместному выделению GPU и эксплуатации сервисов. Для приёмки важно проверить, что планировщик действительно выделяет всю группу одновременно и очищает ресурсы после завершения. Название оркестратора само по себе это не подтверждает.
Нужна ли резервная копия, если есть checkpoint?
Checkpoint позволяет продолжить вычисление с определённого шага. Он не заменяет защищённую копию исходных данных, конфигурации, кода и необходимых результатов. Нужно знать, где лежит контрольная точка, кто может её удалить и что останется после отказа хранилища.
Можно ли заказать запасные GPU и считать это отказоустойчивостью?
Запас оборудования сокращает ожидание замены, но не гарантирует автоматическое продолжение приложения. Требуются доступные данные, совместимое окружение и проверенный сценарий повторного запуска. Время восстановления считают до возобновления полезной работы.
Достаточно ли одного теста в день установки?
Он даёт исходную точку. После обновления драйвера, изменения сетевой топологии или контейнера сравнение повторяют. Постоянно сохраняют телеметрию ошибок, падений заданий и времени ожидания, чтобы отличить неисправность оборудования от изменения нагрузки.
Какие модели Supermicro стоит рассматривать рядом с этим кейсом?
Для проекта на B200 нужна соответствующая HGX-платформа и полная спецификация. Например, SYS-A21GE-NBRT относится к 10U-системам HGX B200. Доступная в каталоге SYS-821GE-TNHR относится к HGX H100/H200; это другой вариант для отдельного сравнения, а не замена B200 без пересчёта. Точные SKU, состав и сервис согласуют до покупки.
Что подготовить для расчёта собственного проекта
Практичный запрос содержит модель и режим работы, длину контекста, объём данных, допустимое время задания, требуемую параллельность и результаты пилота на одном узле. К нему добавляют ограничения площадки: доступную мощность, охлаждение, сеть, размеры стойки, требования к данным и программу приёмки. С этим набором можно предметно выбирать оборудование Supermicro и сравнивать собственный кластер с облачным ресурсом.