Cisco и Supermicro: как устроена AI Factory с NVIDIA
У сервера с восемью GPU может быть достаточно памяти для модели и недостаточно сетевой пропускной способности для совместной работы с соседними узлами. У готовой стойки может быть проверенная внутренняя разводка и неподготовленный водяной контур здания. Именно на этих границах решается, получится ли из дорогостоящего оборудования работающая AI Factory.
Cisco и Supermicro связаны совместным предложением в составе Cisco Secure AI Factory with NVIDIA. Supermicro выпускает вычислительные системы, NVIDIA предоставляет ускорители и технологии их взаимодействия, Cisco объединяет сетевую инфраструктуру, средства защиты, наблюдаемость и сервисную модель. Покупателю предстоит согласовать конкретную конфигурацию, версии ПО, условия площадки и поддержку. Совпадение трёх брендов в спецификации само по себе такую интеграцию не подтверждает.
Разберём архитектуру по состоянию на 26 октября 2026 года: какие системы входят в предложение, зачем нужны отдельные сети, как проверить расчёты поставщика и что должно оказаться в акте приёмки. Числа в расчётных примерах ниже являются исходными условиями проектирования, а не результатами наших испытаний или обещанием производительности конкретного приложения. В кейсе использовано оборудование из каталога Супермикро.
Как связаны Cisco и Supermicro и что изменилось в 2026 году?
25 августа 2026 года Cisco объявила о расширении Secure AI Factory with NVIDIA за счёт систем Supermicro с воздушным и жидкостным охлаждением. В предложение входят плотные GPU-серверы и системы масштаба стойки. Начало приёма заказов через авторизованную партнёрскую экосистему Cisco назначено на октябрь 2026 года. Это глобальные сроки появления предложения; они не определяют наличие конкретной комплектации на российском складе, условия её ввоза или доступность всех сервисов для любого заказчика.
Для инженера изменение заметнее всего в составе проекта. Раньше сервер Supermicro и сеть Cisco часто закупали как отдельные части инфраструктуры, после чего заказчик или интегратор самостоятельно согласовывал совместимость и обращения в поддержку. В совместном предложении появляется заданная архитектура и процедура проверки её реализации. При этом роли изготовителей сохраняются: корпус, GPU-плата, охлаждение и встроенные контроллеры имеют своих разработчиков, прошивки и условия обслуживания.
Программа охватывает несколько классов заказчиков. Корпоративному ЦОД может требоваться управляемый контур для внутреннего инференса. Облачному оператору, специализирующемуся на GPU, нужна повторяемая конфигурация для многих арендаторов. Крупной исследовательской площадке важна масштабируемая сеть для распределённых расчётов. У этих проектов разные ограничения по передаче данных, времени простоя и обслуживанию. Поэтому одно название AI Factory не заменяет проектную документацию.
На практике стоит различать три уровня связи Cisco и Supermicro: обычную сетевую совместимость, интеграционный проект на выбранных компонентах и поставку в рамках конкретного совместного предложения. На первом уровне достаточно корректно поднятого Ethernet-соединения. На втором проверяют весь тракт приложения. На третьем дополнительно определяют эталонную конфигурацию, сервисы валидации, лицензии и ответственность участников. Переход с одного уровня на другой требует проверок; автоматически он не происходит.
| Вариант проекта | Что фактически приобретают | Что проверить до заказа |
|---|---|---|
| Сервер Supermicro и отдельный коммутатор Cisco | Два совместимых по интерфейсам изделия | Скорость, кабель, ПО, топологию и условия поддержки каждого устройства |
| Интегрированный GPU-кластер | Подобранный комплект оборудования и работы интегратора | Испытания приложения, проект сети, пределы масштабирования, границы ответственности |
| Secure AI Factory в согласованной конфигурации | Архитектуру с определёнными компонентами, версиями и сервисами | Точный состав предложения, доступность функций, программу валидации и договоры обслуживания |
Заменяет ли Supermicro серверы Cisco UCS?
Cisco UCS остаётся частью вычислительного портфеля Cisco. Совместное предложение с Supermicro расширяет выбор плотных GPU-систем и систем масштаба стойки. Из этого не следует, что обычный сервер UCS больше не подходит для корпоративных приложений или что любую его задачу следует переносить на HGX. Платформа для баз данных, сервер управления Kubernetes и узел с восемью связанными ускорителями выполняют разные функции.
В одном ЦОД они могут работать рядом. Например, управляющие сервисы, каталоги пользователей и часть прикладных компонентов размещают на корпоративной вычислительной платформе, а крупную модель запускают на GPU-узлах. Такая компоновка требует ясного разделения отказов: остановка одной лабораторной задачи не должна лишать администратора доступа ко всему комплексу. Поэтому архитектуру обсуждают вместе со схемой управления и восстановления, а не только с таблицей GPU.
Что в этой архитектуре называется AI Factory?
AI Factory — инфраструктура, которая принимает данные и вычислительные задания, выполняет обучение или инференс и выдаёт результат с измеримыми характеристиками. Для сервиса языковой модели это могут быть задержка первого токена и скорость генерации. Для обучения — длительность шага, время сохранения контрольной точки и возможность продолжить расчёт после сбоя. Количество GPU характеризует установленный ресурс, но ещё не описывает качество услуги.
У комплекса есть несколько самостоятельных трактов. Данные поступают из хранилища, обрабатываются CPU, размещаются в памяти GPU и передаются между ускорителями. Пользовательский запрос проходит через средства доступа и API. Администратор собирает телеметрию и меняет конфигурацию. Электропитание и охлаждение обеспечивают допустимый режим оборудования. Отказ или ограничение любого из этих трактов может повлиять на итоговое время задания.
Полезно сразу договориться о границах измерения. «Сервер выдаёт 800GbE» описывает интерфейс. «Модель отвечает за две секунды» требует указать длину входного текста, модель, точность, количество одновременных запросов и наличие очереди. «Вся стойка охлаждается» требует температур и расхода на границе подключения, а также допустимого режима при отказе насоса. В техническом задании эти формулировки должны превратиться в воспроизводимые условия.
Отдельный вопрос — готовность данных. Быстрая сеть не исправляет повреждённый датасет, а платформа безопасности не определяет за заказчика, кому разрешено читать документы. До закупки согласуют владельца данных, правила обновления и состав тестовой выборки. Иначе приёмка сведётся к аппаратному тесту, после которого прикладная команда обнаружит, что эксплуатационные требования ещё не сформулированы.
Кто отвечает за вычисления, сеть и прикладной результат?
Supermicro отвечает за изготовление серверных систем в своей зоне. NVIDIA обеспечивает GPU, соответствующие библиотеки и компоненты ускоренного стека. Cisco связывает предложение с сетевой архитектурой и средствами эксплуатации. Хранилище и Kubernetes-платформа могут поставляться участниками экосистемы. В конкретном контракте отдельно фиксируют, кто собирает комплект, кто устанавливает ПО и кто проверяет приложение заказчика.
Здесь особенно полезен короткий перечень передаваемых результатов: спецификация с артикулами, схема соединений, перечень версий, протокол испытаний и контакты ответственных. Слова «под ключ» не определяют эти документы. Если контур здания заканчивается до CDU, а поставщик стойки начинает работу после CDU, границу между ними нужно описать до доставки оборудования. То же относится к сети хранения и доступу в сервисные системы.
Выбрать аппаратный класс можно в разделе GPU-серверов Supermicro. Для обсуждения сетевой части полезен поставщик оборудования Cisco ru-cisco.com. При запросе конфигурации передавайте обеим сторонам одну схему проекта: так несовпадающие предположения о портах, охлаждении и сопровождении обнаружатся до заказа.
MGX, HGX B300 и NVL72: какую единицу вычислений вы покупаете?
В одном предложении соседствуют платформы с разной внутренней связностью. PCIe-сервер может обслуживать много независимых задач. HGX объединяет ускорители высокоскоростными соединениями внутри узла. NVL72 расширяет NVLink-домен до масштаба стойки. Выбор определяется тем, какие части задачи должны постоянно обмениваться данными и сколько памяти требуется одной задаче, а не престижностью названия платформы.
| Класс | Пример системы Supermicro | Определяющее отличие | Первый инженерный вопрос |
|---|---|---|---|
| MGX PCIe GPU | SYS-422GL-FNR2, 4U | До восьми PCIe GPU; связность зависит от ускорителей и дополнительных мостов | Нужна ли общая задача на нескольких GPU или независимые реплики? |
| HGX B300, воздушное охлаждение | SYS-822GS-NB3RT, 8U | Восемь B300 в одном NVLink-домене | Справится ли площадка с тепловой нагрузкой воздушного узла? |
| HGX B300, жидкостное охлаждение | SYS-422GS-NB3RT-LCC, 4U | Восьмиускорительный HGX-узел с прямым жидкостным охлаждением | Готовы ли контур, CDU и обслуживание жидкостной части? |
| GB300 NVL72 | Семейство SRS-GB300-NVL72 | 72 GPU и 36 CPU Grace, связность NVLink масштаба стойки | Оправдан ли такой домен задачами и инфраструктурой заказчика? |
Для чего нужен PCIe-сервер MGX?
Supermicro SYS-422GL-FNR2 относится к двухпроцессорным 4U-платформам с восемью местами для двухслотовых GPU. В варианте Cisco с восемью H200 NVL каждый ускоритель имеет 141 ГБ HBM3e. Арифметическая сумма составляет 1 128 ГБ. Этот ресурс распределён по устройствам: приложение должно явно использовать несколько GPU, если модель не помещается на одном.
Платформа удобна для сценария с несколькими сервисами. На одном GPU можно обслуживать компактную модель, на другом выполнять пакетную обработку, ещё несколько выделить под другие реплики. При этом остаются общими питание, часть PCIe-тракта, CPU и инфраструктура хранения. Восемь задач способны одновременно обратиться к одному датасету и создать нагрузку, которой не видно в тесте одиночной модели.
У H200 NVL доступны варианты межсоединения с NVLink-мостами, включая группы из четырёх GPU. Четыре устройства по 141 ГБ дают 564 ГБ совокупной памяти группы. Наличие мостов и их физическая совместимость входят в конфигурацию заказа. Превращать это число в обещание единого прозрачного массива памяти для любого ПО нельзя: способ распределения весов, кеша и вычислений выбирает программный стек.
Универсальность PCIe-компоновки также имеет пределы. Поддержка определённого ускорителя корпусом не означает, что все GPU используют одинаковые межсоединения. Переход на другой тип карты меняет питание, охлаждение, объём памяти и возможности библиотек. Поэтому конфигурацию под независимый инференс не стоит автоматически переносить в проект распределённого обучения, даже если число ускорителей совпадает.
Что даёт восьмиускорительный HGX B300?
В SYS-822GS-NB3RT установлена платформа HGX B300 с восемью GPU по 288 ГБ HBM3e. Сумма составляет 2 304 ГБ, обычно округляемые до 2,3 ТБ. Между ускорителями работает NVLink пятого поколения с NVSwitch. Для каждого GPU доступен внешний тракт ConnectX-8 со скоростью до 800 Гбит/с. Внутреннее соединение GPU и внешний Ethernet решают разные задачи.
Такую систему рассматривают, когда одна задача регулярно использует несколько ускорителей и чувствительна к их обменам. Крупная модель может распределять веса по GPU; обучение — синхронизировать промежуточные результаты; длинный контекст — требовать значительной памяти под кеш. Эти сценарии не гарантируют одинаковую загрузку всех восьми устройств. Для реального приложения проверяют соответствие числа параллельных частей числу GPU и баланс работы между ними.
Воздушная версия занимает 8U. Корпус имеет глубину около 950 мм и массу системы порядка 119 кг в указанном базовом исполнении. Масса фактической поставки и транспортная масса зависят от комплектности. Это уже оборудование для подготовленного ЦОД: нужны подходящие направляющие, монтажные средства, доступ к обслуживаемым узлам и расчёт воздушного потока. Фраза «помещается в 19-дюймовую стойку» описывает только часть механической совместимости.
SYS-422GS-NB3RT-LCC размещает HGX B300 в 4U с жидкостным охлаждением. Сокращение занимаемой высоты не означает автоматического удвоения полезной мощности в любой стойке. Ограничивающими факторами могут стать электрический ввод, нагрузка на пол, теплопередача через CDU, пространство для коллекторов или число сетевых портов. Сначала рассчитывают эти ресурсы, затем определяют допустимое количество узлов.
Когда имеет смысл GB300 NVL72?
Система Supermicro GB300 NVL72 строится как интегрированная стойка. В одном NVLink-домене работают 72 GPU Blackwell Ultra и 36 процессоров Grace. В Cisco-предложении предусмотрены варианты с разным объёмом поставки охлаждения: исполнение M0 без CDU и M1 с включённым в предложение внутристоечным CDU. Сходный базовый артикул в другом канале поставки не доказывает одинаковый комплект.
Смысл большого домена появляется, когда одна задача извлекает пользу из такого масштаба связности. Если сервис состоит из десятков независимых небольших моделей, плотная стойка сама по себе не обеспечит лучшую экономику. Понадобятся планировщик, изоляция арендаторов и достаточный поток запросов. Если модель требует большого совместно используемого ресурса, сравнивают размещение внутри NVLink-домена и распределение по обычным узлам с внешней сетью.
На этом уровне стойка становится единицей планирования доставки, установки и обслуживания. Проверяют транспортный маршрут, подъём, допустимую нагрузку в зонах перемещения, соединения охлаждения и процедуру первого включения. Замена одного компонента может требовать специальной последовательности остановки и проверки контура. Это следует учитывать в договоре так же подробно, как состав GPU и сетевых адаптеров.
Почему память GPU, RAM и NVLink нельзя складывать в одну характеристику?
В спецификации рядом встречаются терабайты HBM, терабайты системной памяти, терабайты в секунду NVLink и гигабиты в секунду Ethernet. Первые два значения описывают ёмкость, следующие — скорость передачи. Из них нельзя получить один универсальный показатель мощности. Большой объём RAM на CPU помогает подготовке данных и кешированию, но не превращается в локальную HBM ускорителя с той же задержкой доступа.
Для распределённой модели нужна карта размещения. Какие тензоры находятся на каждом GPU? Где живёт KV-кеш? Что выгружается в RAM? Какие обмены происходят каждый шаг и какие — лишь при загрузке модели? В одной задаче доступ к CPU-памяти может быть приемлемым компромиссом, в другой он нарушит требование по задержке. Ответ проверяют на конкретном движке и размере контекста.
Аналогично NVLink-домен не снимает все ограничения программирования. Для эффективной работы приложение использует подходящую схему параллелизма и поддерживаемые библиотеки. Наличие физического соединения не заставит однопроцессную программу автоматически распределить расчёт. В техническом задании следует фиксировать одновременно объём ресурсов и способ, которым выбранное ПО ими пользуется.
Отдельно согласуют систему единиц. В этой статье сетевые Гбит/с и расчётные ГБ используются в десятичной системе: 1 ГБ = 109 байт. Программы могут показывать GiB, где 1 GiB = 230 байт. Сумма 2 304 ГБ соответствует примерно 2 146 GiB до учёта служебных резервов. Разное отображение ёмкости не означает исчезновения памяти, но сравнивать результаты надо в одинаковых единицах.
Как описать нагрузку, чтобы архитектура соответствовала задаче?
Список «LLM, обучение, RAG, агенты» слишком широк для выбора сети и вычислительной платформы. Два сервиса на одной модели могут отличаться по длине контекста в десятки раз. Обучение небольшой модели на множестве независимых экспериментов предъявляет другие требования, чем один большой распределённый запуск. Поэтому первый документ проекта должен описывать несколько измеримых режимов работы и допустимые отклонения в каждом из них.
Для инференса фиксируют модель и её редакцию, формат весов, входную и выходную длину, распределение размеров запросов, одновременность, поток новых запросов и требования к задержке. Для обучения добавляют состав датасета, глобальный batch, способ параллелизма, продолжительность запуска, частоту контрольных точек и допустимое время восстановления. Если эти условия меняются после приёмки, нагрузку нужно пересчитать, даже когда аппаратная конфигурация остаётся прежней.
Сколько памяти требуется модели: расчёт нижней границы
Начальную оценку памяти под веса получают умножением числа параметров на количество байт на параметр. Для условной плотной модели на 70 млрд параметров при двухбайтовом хранении весов это 140 ГБ. При одном байте — 70 ГБ. Четырёхбитное представление даёт арифметическую основу 35 ГБ, однако реальные форматы содержат дополнительные масштабы, метаданные и выравнивание. Эти значения описывают веса, а не весь работающий сервис.
Кроме весов нужны кеш, временные буферы, рабочая память библиотек и ресурс на одновременные запросы. Для обучения могут потребоваться градиенты и состояния оптимизатора, причём их распределение зависит от выбранного метода. Поэтому формула «модель весит 140 ГБ, значит один GPU на 141 ГБ подходит» оставляет практически весь эксплуатационный вопрос без ответа. Разница в один гигабайт не является достаточным резервом.
| Расчёт для условной модели 70 млрд параметров | Только веса | Что считать дополнительно |
|---|---|---|
| 2 байта на параметр | 140 ГБ | KV-кеш, буферы, служебную память, выбранный параллелизм |
| 1 байт на параметр | 70 ГБ | Накладные расходы формата и поддержку вычислений в движке |
| 4 бита на параметр | 35 ГБ до накладных расходов | Метаданные квантования, качество результата и память исполнения |
| Обучение или дообучение | Зависит от метода | Градиенты, оптимизатор, активации, контрольные точки и рабочие буферы |
Для оценки KV-кеша обычного трансформера можно использовать приближение: 2 × число слоёв × число KV-голов × размер головы × байт на элемент × число хранимых токенов. Множитель 2 учитывает ключи и значения. Это модель для заданной структуры attention; другие архитектуры и способы сжатия требуют своей формулы. Из оценки нельзя автоматически выводить расход памяти у любого семейства LLM.
Возьмём расчётный пример: 80 слоёв, 8 KV-голов, размер головы 128, два байта на элемент. На один токен получается 327 680 байт. Для последовательности из 32 768 токенов это ровно 10 GiB кеша, если все перечисленные элементы хранятся в таком виде. Для восьми одновременно заполненных последовательностей получается 80 GiB. Здесь ещё не учтены веса модели и служебные расходы движка.
Этот пример объясняет, почему одинаковая модель помещается в память на коротком демонстрационном запросе и не выдерживает производственную одновременность. Можно уменьшить контекст, изменить формат кеша, распределить модель или добавить реплики. Каждое решение влияет на качество, задержку, сеть и эксплуатацию. Его следует проверять вместе с прикладной командой, а не принимать только ради красивого числа пользователей в коммерческом предложении.
Почему инференс и обучение по-разному нагружают сеть?
При независимых репликах модели основная работа может оставаться внутри одного узла. Внешняя сеть обеспечивает запросы, загрузку весов и доступ к данным. При распределении одной модели между узлами межсерверные обмены становятся частью пути каждого запроса или шага. Тогда задержка и равномерность соединений влияют на результат гораздо сильнее, чем при пакетной обработке независимых документов.
У параллелизма по данным каждый участник обрабатывает свою часть batch, после чего согласует результаты. При тензорном параллелизме вычисления одного слоя распределены между устройствами. Конвейерное разделение передаёт активации между стадиями. У моделей с экспертами возможны интенсивные обмены между выбранными экспертными блоками. На одной и той же сети эти схемы создают разные размеры сообщений и разную чувствительность к задержке.
Поэтому в проекте фиксируют, какие обмены остаются внутри HGX-узла или NVL72-домена, а какие выходят в Ethernet. Если платформа позволяет разместить наиболее частые взаимодействия внутри быстрого домена, сеть между узлами получает другой профиль нагрузки. Это проверяемое свойство размещения задачи. Оно полезнее общего утверждения, что «чем больше гигабит, тем быстрее нейросеть».
Какими метриками измерять полезную работу AI Factory?
Для интерактивной модели недостаточно суммарных токенов в секунду. Пользователь замечает ожидание первого ответа и паузы при продолжении генерации. TTFT измеряет время до первого токена, включая согласованные этапы пути запроса. Межтокенная задержка характеризует продолжение ответа. Полное время запроса зависит также от длины результата. Сравнивать системы следует при совпадающих определениях метрик и одинаковом наборе запросов.
Среднее значение скрывает длинный хвост задержек. Если из ста запросов девяносто пять завершаются быстро, а пять регулярно ждут в очереди, средний показатель может выглядеть приемлемо. Поэтому для производственного сервиса обычно обсуждают несколько перцентилей и долю ошибок. Конкретные пороги задаёт бизнес: требование к внутренней пакетной аналитике отличается от требования к интерактивному помощнику.
Рассмотрим условный поток из 20 новых запросов в секунду со средним временем нахождения запроса в системе 15 секунд. В устойчивом режиме среднее число запросов внутри контура приблизительно равно 20 × 15 = 300. Это оценка на основе баланса потока, а не число одновременно выполняющихся GPU-операций. Часть запросов может ждать в очереди или обращаться к внешним инструментам. Резерв на всплески рассчитывается отдельно.
Для обучения полезно измерять длительность шага после прогрева, скорость обработки данных, время сохранения и чтения checkpoint, а также устойчивость длительного запуска. Добавление узлов оценивают по ускорению относительно базовой конфигурации при одинаковой методике. Если вместе с количеством GPU изменились batch или точность, результат отражает сразу несколько изменений. Такой тест нельзя читать как чистое сравнение сети.
Самостоятельный разбор общей экономии ресурсов вынесен в материал о подборе инфраструктуры Supermicro без лишних мощностей. Для проекта Cisco–Supermicro здесь важнее зафиксировать единый набор нагрузок: на нём проверяют серверы, сеть, хранение и работу всего комплекса после интеграции. Это позволяет связать аппаратные решения с наблюдаемым результатом.
Зачем AI Factory четыре сети: front-end, back-end, storage и OOB?
Разделение сетей помогает задать разные требования к трафику. Пользовательский API должен оставаться доступным при интенсивном сохранении модели. Обмены между GPU требуют предсказуемой работы без конфликтов с массовой загрузкой данных. Контроллеры управления нужны именно тогда, когда основная ОС или вычислительная сеть работает неправильно. Смешивание этих задач в одном неописанном сетевом контуре делает поведение комплекса труднее проверяемым.
В референсной архитектуре конкретные функции могут использовать отдельные физические устройства, логические сегменты или согласованное сочетание обоих подходов. Решение зависит от масштаба и требований валидации. Четыре названия в схеме не означают обязательную покупку четырёх одинаковых комплектов коммутаторов. Но у каждого тракта должны быть определены пропускная способность, изоляция, резервирование и владелец конфигурации.
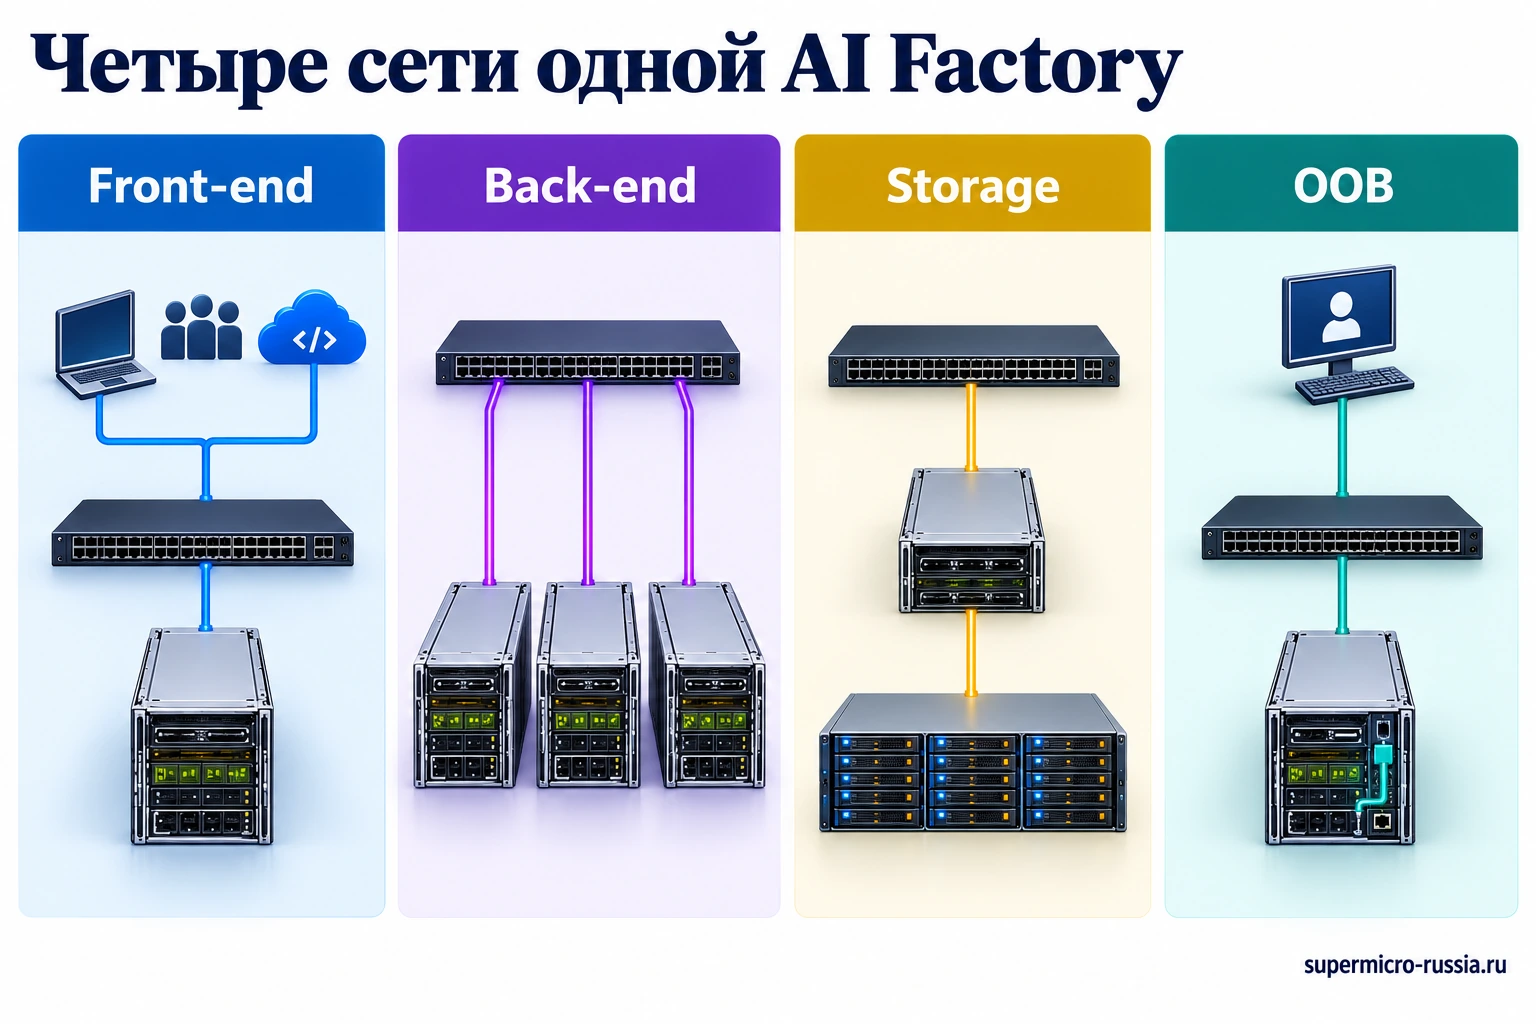
| Контур | Характерный трафик | Что может пойти не так | Что измерять |
|---|---|---|---|
| Front-end | API, пользовательские запросы, связь с бизнес-системами | Очереди, недоступность сервиса, влияние постороннего трафика | Задержку пути запроса, ошибки, нагрузку балансировщиков |
| Back-end | Обмены между GPU-узлами | Перегрузку очередей, неравномерность путей, медленного участника | Коллективные операции, задержку, счётчики портов и перегрузки |
| Storage | Датасеты, веса, checkpoint, кеши | Долгий запуск модели, паузы обучения, конкуренцию чтения и записи | ГБ/с, время операций, задержку метаданных, длительность восстановления |
| OOB | BMC, консоли, служебный доступ, аварийное управление | Потерю возможности диагностики при отказе основных сетей | Доступность управления, аудит доступа, сохранность конфигураций |
Front-end: вход пользователей и связь с прикладными системами
Фронтальная сеть связывает AI-сервис с остальной организацией. По ней могут проходить обращения к API, загрузка документов, ответы модели, запросы к каталогам и внешним приложениям. На этом участке определяют политики доступа, балансировку, ограничения потока и необходимые средства защиты. Даже если сам ответ модели занимает мало байт, массовая загрузка файлов и длинные входные данные способны изменить профиль трафика.
Например, расчётный сервис принимает 50 файлов в секунду по 20 МБ. Только входной поток составляет 1 000 МБ/с, то есть 8 Гбит/с без накладных расходов. Если вместо файлов приходит короткий текст, сеть при той же частоте запросов будет загружена иначе. Следовательно, скорость пользовательского сегмента выбирают по фактическому составу запросов. Производительность GPU не даёт этого ответа.
Отдельно рассматривают доступ к внешним инструментам агентной системы. Модель может быстро подготовить следующий шаг и затем ждать базу данных или корпоративный поиск. В этот момент рост числа ускорителей не уменьшит задержку зависимого сервиса. В протоколе теста следует разделить время GPU-вычислений, ожидание прикладных компонентов и передачу данных через фронтальную сеть.
Back-end: сеть совместной работы GPU
Back-end обеспечивает обмены вычислительных участников. Здесь особенно важны согласованность сетевых параметров и отсутствие неожиданных узких мест. Результат распределённой операции часто зависит от медленного участника: один проблемный линк может увеличить время общего шага. При этом средняя загрузка всей фабрики останется умеренной, и неисправность не будет очевидна на сводном графике трафика.
Для HGX B300 с восемью 800-гигабитными подключениями сумма скоростей портов узла составляет 6,4 Тбит/с в одном направлении. После перевода из бит в байты получается теоретический предел 800 ГБ/с. Это сумма независимых интерфейсов. Один поток, один GPU или одна операция не обязаны использовать их все. Протоколы, топология, PCIe-тракт и алгоритм взаимодействия дополнительно ограничивают полезную скорость.
Поэтому на схеме нужно показать соответствие GPU и NIC, распределение портов по сетевым плоскостям и пути при отказе. Когда к адаптерам применяются разные настройки или часть кабелей подключена в другую плоскость, физическое наличие восьми интерфейсов мало говорит о результате. Сначала проверяют правильность соединений, затем запускают нагрузку, которая действительно использует предусмотренные пути.
Storage: доставка данных и сохранение состояния
Сеть хранения обслуживает операции с разной частотой и длительностью. Чтение обучающих примеров может идти непрерывно. Загрузка весов происходит при старте реплики. Checkpoint создаёт периодический поток записи. Аварийное восстановление запускает чтение большого объёма данных тогда, когда система уже работает в неблагоприятном режиме. Эти события следует включать в один календарь нагрузки.
Выделенная сеть хранения упрощает контроль, но не отменяет ограничений самого массива и программного пути. Если серверы одновременно запрашивают множество небольших файлов, ограничением может оказаться работа с метаданными. Если идёт последовательная запись большого checkpoint, важнее суммарная скорость и задержка завершения записи. Протокол хранения и размер операций выбирают под фактическую задачу, а не по максимальной скорости одного порта.
OOB: независимый путь к управлению
OOB расшифровывается как out-of-band. Такой контур позволяет обращаться к контроллерам управления, сетевым консолям и другим служебным интерфейсам независимо от обычного прикладного пути. В продуманном проекте администратор сохраняет доступ к диагностике при отказе драйвера GPU, загрузки ОС или вычислительной фабрики. Для этого путь управления не должен скрыто зависеть от того самого компонента, который предстоит восстанавливать.
Изоляция OOB включает правила доступа и учётные записи. Служебный порт не подключают напрямую к пользовательскому сегменту только потому, что там нашёлся свободный разъём. В проекте определяют защищённую точку входа администратора, полномочия, аудит и порядок восстановления доступа. Для аварийного сценария проверяют также питание управляющих коммутаторов и доступность необходимых сервисов аутентификации.
Какие коммутаторы Cisco относятся к совместной архитектуре?
В облачной архитектуре Secure AI Factory используются фронтальная сеть на Cisco N9300 с Cisco Silicon One и back-end на Cisco N9100 с NVIDIA Spectrum-X. Архитектура Nexus One объединяет эксплуатационный подход к этим фабрикам. Конкретные платформы, режимы и выпуски ПО выбираются по составу валидированного решения. Название семейства не является универсальной матрицей совместимости всех его поколений.
Пример профильного back-end-коммутатора — Cisco N9164E-NS4-O. Это 2RU-система с 64 портами 800G OSFP и коммутационной ёмкостью 51,2 Тбит/с в соответствующем представлении ёмкости портов. Для режима 400G предусматриваются варианты разветвления. Количество соединений, доступность breakout и параметры оптики проверяют вместе с выбранной операционной системой и редакцией аппаратной платформы.
Наименования легко перепутать: Catalyst 9300, Nexus 9300 прежних поколений и новые N9300 для ЦОД не становятся одинаковыми устройствами из-за цифр 9300. Аналогично категория Cisco Nexus 9000 содержит разные платформы. Для проекта нужны точный PID, поддерживаемый режим работы и список интерфейсов. Подбор по одному названию серии здесь недостаточен.
Существующие коммутаторы Nexus с 400G-интерфейсами могут быть предметом отдельного сравнения для соответствующих трактов. Но замена предусмотренного 800G back-end на имеющийся 400G-коммутатор меняет проект. После такой замены заново проверяют топологию, производительность и применимость валидации. Сохранение бренда Cisco не сохраняет автоматически свойства исходной архитектуры.
Как рассчитать сеть для восьми или шестнадцати HGX-узлов?
Начинайте с количества вычислительных подключений, а не с числа корпусов серверов. В рассматриваемой конфигурации HGX B300 один узел имеет восемь 800G-интерфейсов. Восемь таких узлов дают 64 подключения GPU-сети, шестнадцать — 128. К ним добавляются отдельные подключения хранения, фронтального доступа и управления. Покупка коммутатора «на 64 порта» ещё не определяет, сколько серверов он сможет обслужить в многоуровневой фабрике.
У leaf-коммутатора часть портов направлена к конечным устройствам, часть — к spine. Если все 64 порта заняты серверами, для соединений верхнего уровня свободных портов уже нет. Если разделить их поровну, останется 32 порта вниз и 32 вверх. При одинаковой скорости 800G суммарная полоса с каждой стороны составит 25,6 Тбит/с. Это простой способ проверить арифметику спецификации до обсуждения более сложной топологии.
Следующий пример является расчётом портового бюджета, а не готовой валидированной схемой Cisco или NVIDIA. Для 64 конечных 800G-подключений возьмём два leaf по 32 подключения вниз. Каждый leaf имеет 32 соединения вверх. Если распределить их поровну на два spine, получится по 16 соединений от каждого leaf к каждому spine. Один spine будет занимать 32 порта для этих соединений.
| Позиция расчётного примера | На одно устройство | Всего |
|---|---|---|
| HGX-узлы | 8 портов 800G | 8 узлов, 64 конечных подключения |
| Leaf-коммутаторы | 32 порта к GPU-сети и 32 к spine | 2 устройства, 128 занятых портов |
| Spine-коммутаторы | 32 порта к двум leaf | 2 устройства, 64 занятых порта |
| Соединения сервер — leaf | Один линк на конечное подключение | 64 линка |
| Соединения leaf — spine | 32 линка от каждого leaf | 64 линка |
| Общее количество физических линков | Без хранения, front-end и OOB | 128 линков |
Такой расчёт сразу показывает скрытые статьи комплектации. Если каждый линк выполнен отдельной оптической парой, на 128 линков понадобятся 256 трансиверов, плюс оптические линии и согласованный резерв. При DAC, AOC, twin-port-модулях или breakout состав будет другим. Число из таблицы нельзя механически переносить в заказ оптики: сначала выбирают физическую реализацию каждого типа соединения.
При переходе к 128 конечным подключениям можно рассматривать четыре leaf с тем же делением портов. Два 64-портовых spine в таком примере получат по 64 соединения вниз и исчерпают портовый бюджет. Это демонстрирует границу выбранного шага роста. Дальнейшее расширение потребует другого решения по числу устройств, уровней или портов. Свободное место в стойке не является свободной ёмкостью сетевой фабрики.
Что означает oversubscription 1:1 и 2:1?
Переподписка сравнивает суммарную полосу нижних подключений с полосой верхних. Для 32 портов вниз по 800G и 32 вверх по 800G отношение равно 1:1. Если оставить 16 верхних портов, получится 25,6 против 12,8 Тбит/с, то есть 2:1. В момент, когда все нижние подключения хотят передавать данные через верхний уровень, полоса этого уровня ограничивает суммарную передачу.
Это отношение само по себе не описывает все условия неблокирующей работы. Значение имеют внутренние возможности устройств, распределение трафика по путям, характер сообщений и размещение участников задачи. При локальных обменах верхние соединения могут почти не использоваться. При неблагоприятном распределении потоков отдельный путь может перегружаться раньше, чем достигнута сумма скоростей всех uplink.
Поэтому число 1:1 в коммерческом предложении следует сопровождать схемой и нагрузочным тестом. Нужно знать, для какого направления и уровня сети оно посчитано, сохраняется ли оно после отказа и какие порты реально работают на заявленной скорости. При расчёте только исправного режима отказ одного spine уменьшит доступную верхнюю полосу. Это обстоятельство должно быть отражено в критериях работы при деградации.
Чем NVLink отличается от 800GbE в практическом проекте?
NVLink обеспечивает специализированный высокоскоростной обмен GPU внутри предусмотренного аппаратного домена. Ethernet связывает системы через сетевые адаптеры и коммутаторы. У HGX B300 внутренний домен охватывает восемь GPU; у NVL72 — 72 GPU. Внешняя фабрика используется, когда расчёт или сервис выходит за границу этого домена. Ни число портов Ethernet, ни общий бренд сети не изменяют физический размер NVLink-домена.
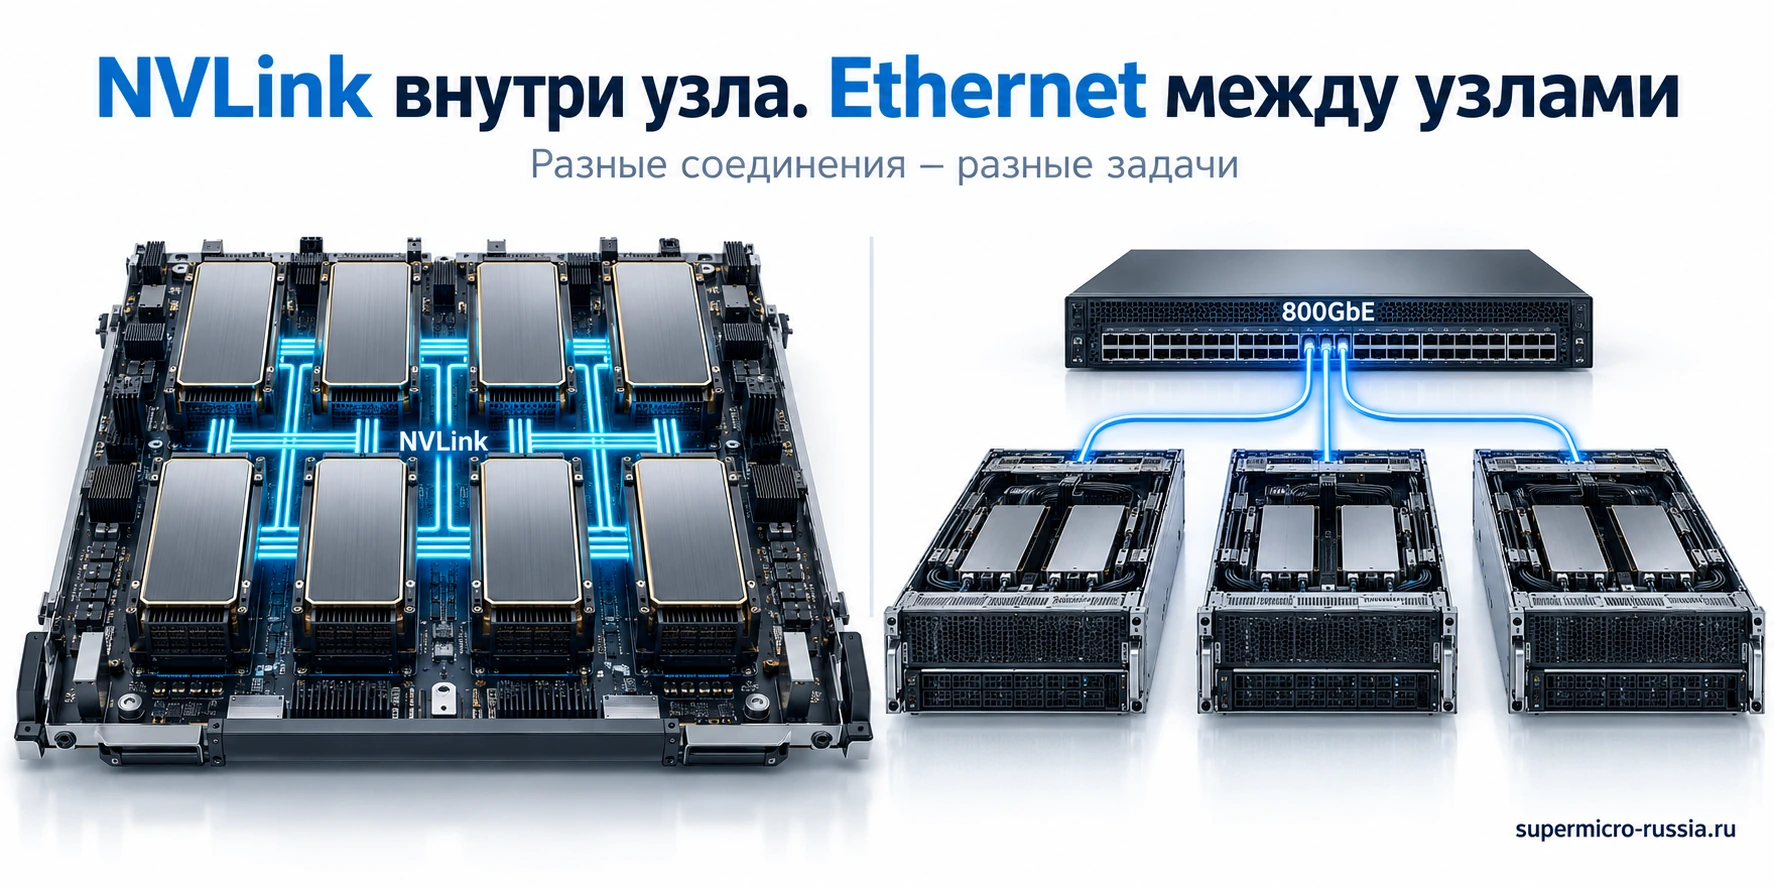
Число 1,8 ТБ/с для NVLink у B300 и 800 Гбит/с для сетевого порта нельзя сравнивать прямым делением без уточнения методики. Различаются единицы, направление суммирования и измеряемый участок. Показатель производителя для GPU-соединения не является скоростью одной прикладной операции между двумя произвольными устройствами. Для выбора архитектуры полезнее измерить конкретные коллективные обмены на целевом наборе GPU.
Есть и принципиальная разница в поведении приложения. Соединение Ethernet обслуживает пакеты и сетевые протоколы. Путь GPU-коммуникаций включает библиотеки, драйверы и размещение устройств. Даже очень быстрый физический линк не устраняет лишние копирования или неудачное распределение процессов. Поэтому диагностика начинается с карты полного пути данных, а не с замены коммутатора на более быстрый.
Как использовать AllReduce для проверки расчёта?
AllReduce объединяет данные всех участников операции и возвращает итог каждому из них. В распределённом обучении такая операция часто используется для согласования результатов. В простом кольцевом приближении объём передачи на участника составляет примерно 2 × (N − 1) / N × S, где N — число участников, S — объём исходных данных участника. Это модель алгоритма; реальные библиотеки выбирают различные способы обмена.
Для восьми участников и массива 8 ГБ коэффициент равен 1,75, а расчётный объём передачи на участника — 14 ГБ. Если предположить эффективную скорость 70 ГБ/с на ограничивающем участке, нижняя оценка времени передачи составит 0,2 секунды. Здесь 70 ГБ/с является заданным условием примера, а не замером 800GbE. Задержки, синхронизация и особенности реализации могут увеличить итоговое время.
В многоузловой системе сначала выясняют, кто именно является участником и какой участок ограничивает обмен. Сравнение восьми GPU внутри одного HGX и восьми узлов с локальной агрегацией — разные испытания. Библиотека может выполнять часть операции внутри узла и другую часть через сеть. Без описания этого процесса формула даёт учебную оценку, но не прогноз времени шага реального обучения.
Полезный протокол испытания содержит размеры сообщений, число узлов и процессов, соответствие процесса GPU, разогрев, длительность, версии библиотек и два представления результата: время операции и используемый тестом показатель полосы. В NCCL Tests различаются algorithm bandwidth и bus bandwidth. Они описывают разные способы нормирования результата. Их нельзя без пояснения приравнивать к скорости одного физического порта.
При росте кластера смотрят на худшие и типичные значения, повторяемость и зависимость от размещения. Если несколько запусков одного теста резко отличаются, сначала проверяют соседнюю нагрузку, маршруты и состояние устройств. Покупка дополнительных GPU до объяснения этой нестабильности способна увеличить стоимость проблемы. В совместной AI Factory такая проверка должна входить в согласованную методику валидации.
Что нужно для RoCE и почему одного Ethernet-соединения мало?
RDMA позволяет устройствам обмениваться данными с меньшим участием обычного процессорного пути. RoCE переносит такой обмен в Ethernet-среду. В AI-кластере это помогает организовать передачу между вычислительными участниками, однако требует согласованной работы сетевых адаптеров, коммутаторов, драйверов и библиотек. Наличие линка нужной скорости подтверждает физическое соединение, но ещё не подтверждает корректность RDMA-пути.
RoCEv2 использует IP-маршрутизируемый транспорт. Поведение при перегрузке зависит от настроек и поддерживаемых механизмов. ECN позволяет обозначать возникновение перегрузки, а PFC приостанавливает передачу определённого класса трафика на соответствующем участке. Эти инструменты имеют разные роли. Настройка очередей и порогов должна соответствовать выбранному дизайну, скоростям и параметрам тракта.
Универсального набора порогов для любой Cisco–Supermicro-системы нет. Различаются глубина очередей, задержка линии, число переходов и алгоритмы адаптера. Поэтому значения из чужого примера не следует переносить в рабочую сеть без проверки. Для валидированного решения используют согласованный профиль, а изменения профиля рассматривают как изменение конфигурации, которое нуждается в повторном испытании.
Чем Spectrum-X отличается от обычного набора Ethernet-компонентов?
Spectrum-X использует совместную работу соответствующих коммутаторов и SuperNIC: управление перегрузкой, распределение передачи и телеметрию. Адаптивная маршрутизация помогает выбирать менее загруженные пути, но не устраняет ситуацию, когда много отправителей одновременно передают одному получателю. У такого получателя остаётся конечная пропускная способность. Для этого случая необходимы механизмы регулирования потока и корректная организация нагрузки.
Следовательно, заменить одну часть набора на похожее устройство и сохранить все свойства Spectrum-X по умолчанию нельзя. Конфигурация должна учитывать совместимость функций на обоих концах и в коммутаторах. Отдельно проверяют, какие режимы относятся к промышленно валидированной комбинации, а какие пока доступны для оценки. Это особенно существенно при переходе на новое поколение SuperNIC или новый выпуск оператора.
В качестве примера зависимости от версии: Network Operator 26.7.0 использует отдельные профили Spectrum-X, передаваемые через ConfigMap. Ранее поддерживаемая форма указания версии профиля не гарантирует автоматическое применение тех же настроек после обновления. В проекте поэтому фиксируют не только номер оператора, но и сам профиль, его происхождение и применённые параметры. Слово «актуальный» в колонке версии не позволяет воспроизвести конфигурацию.
Как обнаружить перегрузку, которую скрывает средняя загрузка?
Предположим, четыре отправителя передают по 200 Гбит/с одному получателю с портом 400 Гбит/с. Суммарный входящий поток составляет 800 Гбит/с, а выходящий ограничен 400. При сохранении такого режима возникает очередь, даже если остальные порты коммутатора свободны. Добавление новых uplink в другом месте сети не увеличит скорость этого конечного порта. Нужно исследовать размещение задачи, распределение приёмников и регулирование потока.
Для проверки запускают несколько режимов: равномерный обмен, много отправителей к одному получателю, одновременно работающие задания и сохранение checkpoint во время вычислений. В каждом режиме сопоставляют время прикладного шага со счётчиками очередей и перегрузки. Если смотреть только на суммарные терабиты в секунду, локальное узкое место может остаться незамеченным.
Отклонения PFC и ECN также читают в контексте нагрузки. Само наличие счётчика не является доказательством неисправности, а его отсутствие не доказывает оптимальную настройку. Полезно сравнивать временные ряды до и после изменения, одинаковые порты и одинаковые режимы теста. Так можно отделить ожидаемую реакцию управления потоком от устойчивого ограничения, которое увеличивает время задания.
Как проверить совместимость оптики между Cisco и Supermicro?
В спецификации линии нужны два конца, а не один артикул трансивера. Со стороны сервера указывают модель адаптера, тип порта, поддерживаемый режим и прошивку. Со стороны коммутатора — PID, порт, ОС и её выпуск. Между ними определяют оптический стандарт, тип волокна, длину, разъёмы и способ разводки. Одинаковое число «800G» на двух коробках не закрывает эти вопросы.
OSFP и QSFP-DD описывают разные физические форм-факторы. На противоположных концах линии они могут сочетаться при совместимом оптическом стандарте, но модуль нельзя произвольно переставить в механически другой порт. Варианты исполнения также отличаются теплоотводом. Совместимость конкретного трансивера с устройством и допустимой температурой проверяется отдельно от совместимости оптических сигналов между двумя модулями.
| Проверка линии | Что записать в спецификацию | Типичная ошибка |
|---|---|---|
| Физический порт | Форм-фактор и допустимую мощность модуля на обоих концах | Выбор по скорости без проверки посадочного места |
| Оптический режим | Точный стандарт передачи и число линий | Предположение, что любые два 800G-модуля совместимы |
| Волоконная линия | Тип волокна, разъёмы, полярность, число соединений | Учёт только длины патч-корда |
| Breakout | Схему разделения порта и поддерживаемые дочерние скорости | Покупка разветвителя без поддержки нужного режима |
| FEC и ПО | Совместимые настройки и минимальные выпуски | Разные предположения о коррекции ошибок на концах |
| Эксплуатация | Маркировку, резерв, доступность диагностики и замены | Невозможность быстро определить назначение кабеля |
Для коротких соединений внутри стойки рассматривают поддерживаемые медные или активные кабельные сборки. Межстоечные линии могут потребовать оптики. Решение зависит от длины, радиуса изгиба, удобства обслуживания, тепловой мощности модулей и состава валидированной архитектуры. Экономия на одном типе соединений должна оцениваться вместе с эксплуатацией всего кабельного хозяйства.
При расчёте длины учитывают реальный маршрут через кабельные организаторы, сервисные петли и расположение портов. Длина по прямой между двумя стойками не равна длине трассы. Избыточно длинная сборка тоже создаёт проблемы: занимает место, затрудняет обслуживание и увеличивает риск неправильной укладки. План соединений полезно проверить до заказа, когда исправление ещё не требует замены большой партии кабелей.
Для предварительного подбора доступны трансиверы и сетевые модули Cisco. Согласовывать их следует под конкретную линию «адаптер — модуль — трасса — модуль — коммутатор». В проектной таблице сохраняют именно эту цепочку. Тогда при изменении одного артикула понятно, какие соседние параметры требуют повторной проверки.
После подключения проверяют фактическую скорость, стабильность, счётчики ошибок и доступную диагностику оптического уровня. Исправляемые ошибки и неисправляемые ошибки имеют разный смысл; их оценивают с учётом режима FEC и длительности наблюдения. Успешный одиночный ping подтверждает совсем небольшой участок требований. Он не заменяет длительную проверку передачи на целевой скорости.
В протоколе полезно сохранить исходные счётчики, длительность теста и значения после нагрузки. Если линк несколько раз переустанавливался, усреднённая скорость может скрыть кратковременные обрывы. Для распределённого задания такие обрывы способны оказаться критичнее умеренного снижения средней полосы. Поэтому критерий стабильности линии должен быть самостоятельным пунктом приёмки.
Как проверить путь GPU — PCIe — NIC до запуска приложения?
Высокая скорость Ethernet не гарантирует, что данные дойдут до GPU без дополнительного ограничения внутри сервера. Нужно учитывать расположение адаптеров относительно процессоров и PCIe-коммутаторов. У двухпроцессорной платформы доступ к устройствам может проходить через разные корневые комплексы. Неудачное назначение процессов способно добавить межпроцессорные переходы и лишние копирования. Исправная сеть при этом будет ждать данные со стороны узла.
GPUDirect RDMA создаёт прямой путь обмена между памятью GPU и совместимым устройством через PCIe. Работоспособность зависит от аппаратной топологии, драйверов и условий платформы. Проверка включает карту устройств, параметры прошивки и фактический путь используемой библиотеки. Само наличие поддерживаемых GPU и NIC в спецификации ещё не доказывает, что приложение действительно использует этот режим.
До испытаний составляют таблицу соответствий: серийный номер сервера, GPU, его PCIe-адрес, ближайший сетевой интерфейс, NUMA-узел и принадлежность сетевой плоскости. Для устройств с заводской интеграцией часть связей задана конструкцией, но их всё равно нужно корректно отразить в программной конфигурации. Таблица помогает обнаружить перестановку портов и объяснить разницу между одинаковыми с виду узлами.
Диагностику проводят последовательно. Сначала проверяют наличие всех устройств и ожидаемую ширину соединений. Затем сравнивают локальные GPU-обмены, обмены через адаптеры и работу нескольких узлов. Только после этого переходят к приложению. Если сразу запускать большую модель, её журнал может сообщать об общем тайм-ауте, не показывая, на каком участке возникло ограничение.
Почему нельзя обещать сумму полосы всех портов одному процессу?
Предположим, узел имеет несколько сетевых интерфейсов, но программа выбирает только один. Добавление остальных портов в кабельный план не увеличит скорость этого процесса. Для их использования нужен подходящий механизм распределения обменов, корректная топология и поддержка программного стека. По этой причине в тестовом задании указывают не только число подключённых портов, но и способ их использования.
На уровне PCIe также следует различать физическое место, поколение соединения и фактически согласованный режим устройства. Современный слот может обслуживать GPU предыдущего поколения PCIe. Это нормально, если такой вариант предусмотрен проектом. Ошибкой будет приписать всей цепочке пропускную способность самого нового элемента. Ограничивающий участок определяется по полному пути передачи.
Какие версии ПО должны быть зафиксированы в спецификации AI Factory?
Вместо требования «поставить последнюю версию» нужен согласованный набор выпусков. В него входят ОС и ядро, GPU-драйвер, CUDA-совместимый стек, прошивки GPU и NIC, сетевое ПО, библиотеки коллективных операций и прикладной контейнер. Для оркестрации добавляют Kubernetes-платформу и операторы. Такой набор образует проверяемую конфигурацию. По отдельности новые компоненты могут работать, а их сочетание потребует дополнительной проверки.
NX-OS или SONiC: что означает выбор сетевой ОС?
Совместная архитектура предусматривает выбор сетевой ОС на поддерживаемых платформах, включая NX-OS и SONiC. Применимость определяется конкретным устройством, выпуском и референсной конфигурацией. Из этого не следует, что любое ранее установленное устройство Nexus можно перевести на другую ОС или что настройки двух ОС взаимозаменяемы. В заказе нужно зафиксировать фактический вариант, на котором будут выполнены испытания.
Выбор влияет на эксплуатационные инструменты, модель конфигурации, автоматизацию и компетенции дежурной команды. Если инфраструктура уже управляется определённым набором средств, проверьте нужные операции на пилоте: применение политики, сбор телеметрии, резервное копирование и восстановление. Список поддерживаемых функций полезнее общего обещания единого интерфейса. Одинаковый внешний вид панели не доказывает одинаковую глубину управления устройствами.
При изменении ОС или её ветки повторно проверяют сетевые профили, оптику, поведение при перегрузке и прикладные обмены. Сохранённый эталонный тест позволяет оценить последствия без догадок. Результат миграции должен включать новую конфигурацию и обновлённый комплект восстановления. Иначе следующая аварийная замена может вернуть оборудование к несовместимым настройкам, хотя штатный режим после миграции выглядел исправным.
| Уровень | Что фиксировать | Зачем это нужно |
|---|---|---|
| Серверная прошивка | BIOS, BMC, параметры платформы и GPU | Повторяемая и поддерживаемая аппаратная конфигурация |
| ОС | Дистрибутив, редакцию, ядро, установленные пакеты | Совместимость драйверов и воспроизводимость восстановления |
| Ускоренный стек | GPU-драйвер, CUDA-компоненты, NCCL, runtime контейнеров | Работа GPU и коллективных обменов |
| Сеть | Прошивки NIC, сетевой драйвер, ОС коммутаторов, профиль фабрики | Согласованное поведение полного RDMA-тракта |
| Оркестрация | Kubernetes, GPU Operator, Network Operator, CNI и настройки | Корректное выделение ресурсов и подключение заданий |
| Приложение | Контейнер по digest, модель, параметры запуска, тестовые данные | Повторение измерений после поставки и обновлений |
NVIDIA GPU Operator автоматизирует управление компонентами GPU-стека в Kubernetes, включая драйверы, средства выдачи GPU контейнерам и мониторинг. Network Operator относится к сетевой части. Это разные зоны управления. Наличие одного оператора не означает, что другой установлен, применил правильный профиль или настроил внешние коммутаторы. У каждого уровня остаются предварительные условия.
Есть также различие между подготовкой узла до установки Kubernetes и дальнейшим управлением внутри кластера. Настройки BIOS, часть прошивок, базовая сеть и некоторые host-компоненты подготавливаются отдельно. Если этот этап пропущен, оператор не обязан исправить всё автоматически. В проекте полезно явно указать, кто отвечает за подготовку хоста и по какому документу подтверждает её завершение.
Как делить GPU между несколькими командами?
Вариантов несколько: выделять целые GPU, использовать поддерживаемые аппаратные разделы MIG или применять другие режимы совместного использования. У каждого варианта свои свойства изоляции и планирования. MIG разделяет ресурсы поддерживаемого ускорителя на заданные аппаратные профили; допустимые профили зависят от модели GPU и ПО. Число возможных разделов не равно обещанному числу одновременно обслуживаемых пользователей.
Например, если одна команда требует 60 ГБ памяти на задачу, нельзя без расчёта назначить ей минимальный раздел только ради увеличения количества арендаторов. Если приложение чувствительно к внешним обменам, потребуется проверить доступность нужной сетевой конфигурации внутри выделенного режима. Общий лимит памяти и рабочая производительность остаются разными требованиями.
Для независимых команд согласуют также квоты, приоритеты и допустимые сроки ожидания. Один пользователь не должен случайно занять все доступные устройства бессрочной задачей, если сервис рассчитан на несколько подразделений. Эти правила относятся к управлению ресурсом. Сетевая сегментация и разграничение доступа к данным решаются отдельными средствами и не появляются автоматически после разделения GPU.
Что делать с закрытым контуром без доступа в интернет?
Для изолированной площадки заранее готовят локальные репозитории пакетов и контейнеров, образы установки, необходимые лицензии и процедуру обновления. Проверяют, какие компоненты требуют внешнего подключения и какие варианты локального развёртывания доступны в выбранной редакции. «Работает on-premises» не означает, что каждый сервис управления и каждая подписка имеют одинаковую автономность.
Практический тест закрытого контура — повторная установка одного узла из сохранённого комплекта материалов. Если установка останавливается на отсутствующем контейнере или проверке внешнего сервиса, проект ещё зависит от неописанной инфраструктуры. Такой тест полезно выполнить до массового развёртывания. Он также показывает, сколько времени займёт восстановление после замены системного накопителя или полного пересоздания узла.
Политика обновлений должна включать пробную группу, повторные тесты и способ возврата к совместимой версии. Возврат не всегда означает простое понижение номера прошивки: отдельные компоненты имеют ограничения на downgrade. Поэтому план отката проверяют заранее на конкретном стеке. Окно обслуживания согласуют вместе с владельцами приложений и с учётом времени чтения моделей из хранилища.
Как рассчитать хранилище, чтобы GPU не ждали данные?
У AI Factory есть как минимум три разных требования к данным: ёмкость, скорость и время доступа. Большой архив не обязательно способен быстро подать обучающие примеры. Быстрый массив на крупноблочной записи не обязательно хорошо обслуживает миллионы маленьких файлов. Локальные NVMe помогают кешированию, но их содержимое нельзя считать единственной сохраняемой копией важных данных, если проект предусматривает замену узла.
Начните с карты жизненного цикла данных. Где лежит исходный набор? Где подготовленная версия? Какие данные копируются на узлы, а какие читаются удалённо? Где сохраняются веса, контрольные точки и результаты? Для каждого объекта укажите объём, частоту обновления, требования к сохранности и время восстановления. После этого можно обоснованно разделить быстрый рабочий слой и долговременное хранение.
Расчёт подачи данных на восемь узлов
Возьмём условную задачу: каждый узел обрабатывает 2 000 объектов в секунду, средний передаваемый объект занимает 0,5 МБ. Получается 1 000 МБ/с, или 1 ГБ/с на узел. Восемь узлов требуют 8 ГБ/с полезного потока. Это исходная оценка чтения данных до поправок на повторное использование, компрессию, предварительную обработку и накладные расходы протокола.
При хорошей локальности фактическая нагрузка общего хранилища может уменьшиться. При неудачном устройстве датасета она может вырасти из-за лишних чтений и множества операций с метаданными. Поэтому тестировать нужно тот формат, который будет использоваться в работе. Результат последовательного чтения одного большого файла не описывает поведение каталога с миллионами отдельных объектов.
Сжатие также не является бесплатным ускорением. Оно уменьшает объём передачи, но требует вычислений для распаковки. Если распаковку выполняет перегруженный CPU, GPU будет ждать подготовленных данных при свободной сети. В протоколе полезно фиксировать загрузку CPU, время подготовки batch и фактическое ожидание со стороны ускорителя. Тогда понятно, где именно нужно добавлять ресурс.
Почему средняя скорость checkpoint вводит в заблуждение?
Предположим, 64 участника распределённого задания сохраняют по 50 ГБ уникальных частей состояния. Общий размер checkpoint составляет 3 200 ГБ, или 3,2 ТБ. Если сохранение происходит раз в 30 минут, средний поток за весь интервал равен примерно 1,78 ГБ/с. Но при требовании завершать запись за 60 секунд нужно уже около 53,3 ГБ/с полезной скорости во время сохранения.
| Параметр расчётного примера | Значение | Как читать |
|---|---|---|
| Число сохраняющих участников | 64 | Размеры частей считаются уникальными, без дополнительных копий |
| Объём на участника | 50 ГБ | Исходное условие примера |
| Общий checkpoint | 3 200 ГБ | 64 × 50 ГБ |
| Средний поток за 30 минут | 1,78 ГБ/с | 3 200 / 1 800, не требуемая пиковая скорость |
| Поток при записи за 60 секунд | 53,3 ГБ/с | 3 200 / 60, до накладных расходов |
| Идеальное чтение при 40 ГБ/с | 80 секунд | 3 200 / 40, без запуска процессов и проверки состояния |
Такая разница объясняет ситуацию, когда массив выглядит недогруженным на суточном графике, но регулярно останавливает обучение на записи. Нужно согласовать допустимое окно сохранения и возможность перекрывать его с вычислениями. Для асинхронной записи дополнительно выясняют, в какой момент checkpoint действительно считается сохранённым и что произойдёт, если узел откажет до завершения передачи в устойчивое хранилище.
Восстановление тоже проверяют на полном состоянии. Читать только файл весов недостаточно, если для продолжения обучения нужны дополнительные данные оптимизатора и позиция в датасете. Успешное открытие checkpoint ещё не доказывает, что расчёт корректно продолжился. В испытании должны быть возобновление, несколько рабочих шагов и проверка ожидаемой целостности состояния.
Что происходит при одновременном старте моделей?
Пусть восемь реплик независимо загружают по 140 ГБ весов из общего источника. Совокупный объём чтения равен 1 120 ГБ. При эффективной общей скорости 20 ГБ/с идеальная нижняя оценка передачи — 56 секунд. Если по отдельности каждая реплика стартует быстро, это не гарантирует такого же времени массового запуска. Все они конкурируют за общий ресурс.
Локальный кеш, предварительное размещение весов и поэтапный старт помогают изменить этот режим. Но кеш требует правил актуализации. Нужно убедиться, что разные узлы не обслуживают разные редакции модели под одним именем. Для запуска фиксируют контрольные суммы или версии артефактов, а не только путь к каталогу. Это одновременно помогает воспроизводимости и расследованию непредвиденных изменений результата.
Отдельно проверяют работу при недоступности части хранилища. Должен ли уже запущенный сервис продолжать отвечать? Может ли система создать новую реплику? Где находятся критичные конфигурации и учётные данные? Ответы зависят от того, какие объекты уже размещены в памяти и на локальных накопителях. Отказоустойчивость вычислений и отказоустойчивость данных нужно согласовывать как взаимосвязанные требования.
Какую ёмкость и запас хранения включить в спецификацию?
Полезная ёмкость складывается из исходных данных, подготовленных наборов, нескольких редакций моделей, сохраняемых checkpoint и результатов. К ней добавляют накладные расходы выбранной схемы защиты, резерв свободного места и ожидаемый рост. Сумма паспортных ёмкостей SSD не равна доступному объёму для приложения. Значение нужно получить после выбора конкретной схемы хранения.
Для расчётного проекта можно, например, отдельно отвести 80 ТБ под датасеты, 20 ТБ под модели и 32 ТБ под десять checkpoint размером 3,2 ТБ каждый. Основа составит 132 ТБ до защиты и резерва. Если политика хранения требует сохранять двадцать checkpoint, соответствующая часть удвоится. Гораздо проще согласовать такую политику заранее, чем искать дополнительную ёмкость после начала длительного обучения.
Для интенсивной записи проверяют ресурс SSD и характер нагрузки. При расчёте учитывают фактическое число полных перезаписей, коэффициент усиления записи и срок эксплуатации. Средняя скорость чтения ничего не говорит о допустимом ресурсе записи. Если рабочие наборы временно размещаются на локальных SSD, их износ также входит в эксплуатационный план.
В разделе систем хранения Supermicro можно подобрать аппаратную основу, но для AI Factory потребуется конфигурация под заданный профиль. Запрос поставщику должен включать одновременно рабочую ёмкость, скорость параллельного чтения, окно checkpoint и время восстановления. В таком виде хранилище становится проверяемой частью комплекса, а не остаточной строкой после выбора GPU.
Как согласовать питание серверов Supermicro и сетевой фабрики Cisco?
В плотной AI-системе питание рассчитывают для всего комплекса: GPU-узлов, коммутаторов, модулей связи, хранения и оборудования охлаждения в соответствующей зоне учёта. Нельзя ограничиться суммой TDP GPU. Этот показатель не включает все компоненты сервера и не описывает потребление на входе стойки. Для проекта нужны максимальный согласованный режим, рабочий профиль и поведение при отказе элемента питания.
У SYS-822GS-NB3RT предусмотрены шесть блоков питания по 6,6 кВт в схеме 3+3. Сумма их паспортных мощностей равна 39,6 кВт, но это не означает постоянного потребления сервера 39,6 кВт. Часть мощности обеспечивает резервирование. Доступная мощность и допустимые подключения зависят от режима и входных условий. Поэтому строку о блоках питания нельзя использовать вместо электрического задания на площадку.
Для двух независимых вводов проверяют весь путь: источник, распределительный щит, кабель, PDU, разъёмы и блоки питания. При потере одного ввода оставшийся путь должен выдержать предусмотренную нагрузку, если такой режим заявлен в проекте. Два кабеля, подключённые к одному незащищённому распределителю, не образуют независимые вводы. Избыточность на уровне сервера не устраняет общую точку отказа выше него.
Пример расчёта мощности стойки
Предположим, четыре узла в расчётном проекте потребляют на входе по 16 кВт в согласованном пиковом режиме. Получается 64 кВт. Добавим 6 кВт на сетевое и сопутствующее оборудование в той же зоне измерения: итого 70 кВт. Здесь 16 и 6 кВт — условия примера, а не паспортные характеристики выбранных моделей. Резерв, переходные процессы и оборудование вне этой зоны учитываются отдельно.
Если для предварительной оценки принять симметричную трёхфазную нагрузку 70 кВт, линейное напряжение 400 В и коэффициент мощности 0,95, ток составит примерно 106 А: 70 000 / (√3 × 400 × 0,95). Реальная разводка имеет распределение по фазам, ограничения аппаратов и требования проекта электроснабжения. Такой расчёт проверяет порядок величины, но не определяет номиналы автоматов и кабелей.
В задании на подключение полезно разделить установленную мощность, допустимый длительный режим и лимит, применённый программно. Ограничение GPU power cap может снизить потребление, однако одновременно меняет производительность. Если поставщик использовал power cap для прохождения электрического теста, это значение должно сохраниться в протоколе. Испытания с разными лимитами нельзя считать одинаковыми условиями приёмки.
Где заканчивается охлаждение сервера и начинается инфраструктура здания?
Прямое жидкостное охлаждение передаёт тепло от компонентов в контур через холодные пластины. Затем тепло проходит через коллекторы и оборудование распределения теплоносителя. CDU может разделять контур ИТ-оборудования и контур площадки, поддерживая необходимые параметры. Дальше тепло нужно отвести за пределы обслуживаемой зоны. Наличие CDU в поставке не подтверждает готовность всей этой цепочки.
У разных решений используются разные границы ответственности. Один комплект включает только серверные соединения, другой — коллекторы и CDU, третий — дополнительные компоненты отвода тепла. В варианте с передачей тепла в воздух помещения нагрузка остаётся у системы кондиционирования помещения. Поэтому слово «жидкостный» не следует воспринимать как обещание отсутствия требований к охлаждению здания.
«Я спросил Cisco о компонентах за пределами стойки — например, чиллерах и межрядных CDU», — Патрик Кеннеди, главный редактор ServeTheHome, в обсуждении совместного предложения.
Эта постановка вопроса полезна для закупки: где физически находится точка передачи тепла и кто обеспечивает её параметры? В проекте указывают температуру подачи и возврата, допустимый перепад давления, расход, состав теплоносителя, требования к фильтрации и качеству среды. Значения берут для выбранной системы и площадки. Подменять их средними цифрами для «любого водяного сервера» нельзя.
Сколько тепла остаётся в воздухе?
Даже при охлаждении CPU и GPU жидкостью часть тепла может уходить в воздух от накопителей, источников питания, сетевых компонентов и других элементов. Долю определяют для конкретной системы. Если принять для расчётного примера 20 кВт на узел и 70% отвода в жидкость, получатся 14 кВт в контуре и 6 кВт в помещении. Для шестнадцати узлов остаточная воздушная нагрузка составит уже 96 кВт.
Этот пример показывает, почему подготовку помещения нельзя завершать фразой «всё будет на воде». Нужно учитывать также тепло коммутаторов и хранения, направление воздушных потоков и расположение воздухозаборов. При смешении устройств с разными направлениями потока возможна рециркуляция нагретого воздуха. Она способна вызвать локальное ограничение частот при приемлемой средней температуре зала.
Для грубой теплотехнической оценки воды используют зависимость Q = ṁ × c × ΔT. При 14 кВт, теплоёмкости воды около 4,18 кДж/(кг·К) и разнице температур 10 К получается примерно 0,335 кг/с, или около 20 л/мин при принятой плотности. Это учебная оценка теплопереноса водой. Реальный теплоноситель, гидравлическое сопротивление и требования оборудования изменяют проектный расход.
| Граница | Какие данные передают | Кто должен подтвердить |
|---|---|---|
| Сервер — коллектор | Тип соединений, требуемые параметры контура, допустимую нагрузку | Поставщик системы и интегратор |
| Контур ИТ — CDU | Расход, перепад давления, теплоноситель, режим резервирования | Ответственный за жидкостную часть |
| CDU — площадка | Тепловую мощность и параметры внешней среды | Эксплуатация ЦОД и проектировщик инженерной инфраструктуры |
| Остаточное тепло — помещение | Воздушную нагрузку и направления потоков | Проектировщик охлаждения и эксплуатация зала |
| Аварийный режим | Сигналы, задержки, допустимые действия и условия остановки | Все участники согласованной процедуры |
Как испытывать отказ охлаждения без риска для оборудования?
Сценарии проверки определяет поставщик системы вместе с эксплуатацией площадки. Вместо произвольного отключения насоса используют предусмотренные методикой проверки сигналов, резервирования и реакции управления. У каждой операции должны быть границы допустимого режима и критерии прекращения теста. Нельзя переносить процедуру с другого класса серверов только потому, что оба используют жидкость.
Полезно заранее проверить путь аварийного сообщения: датчик обнаружил событие, система мониторинга приняла его, дежурный получил уведомление и понимает дальнейшие действия. Задержки на каждом этапе влияют на результат. Сигнал на локальном экране CDU мало помогает, если в нерабочее время его никто не видит. Порядок действий и контакты входят в эксплуатационный комплект.
Механические стандарты стоек и их различия подробно разобраны в материале MGX, OCP ORv3 и EIA для ИИ-ЦОД. В проекте Cisco–Supermicro достаточно перенести из него правильный принцип: проверять весь комплект размещения. Поддержка формата стойки не подтверждает совместимость электропитания, охлаждения, направляющих и сервисных проходов.
Почему CDU, задняя дверь и sidecar решают разные задачи
В мартовском обзоре ServeTheHome на площадке Supermicro показаны сразу три разных устройства. CDU передаёт тепло из серверного контура в контур здания через теплообменник и обеспечивает циркуляцию. Задняя дверь RDHx забирает тепло из выходящего из стойки воздуха в жидкость. Liquid-to-air sidecar действует в обратном направлении: принимает тепло серверной жидкости и отдаёт его воздуху помещения.
У показанных задних дверей названы варианты на 50 и 80 кВт; эти числа относятся к конкретным исполнениям и условиям расчёта. Они не являются допустимой мощностью любой стойки и не означают, что всё тепло GPU-системы идёт через дверь. При прямом охлаждении чипов жидкостью дверь может обслуживать остаточную воздушную нагрузку. Нельзя дважды учесть один и тот же тепловой поток при суммировании возможностей CDU и RDHx.
Sidecar позволяет подключить жидкостный сервер там, где нужного водяного контура здания пока нет. Но помещение должно принять выделенное тепло. Если условный сервер отдаёт в sidecar 100 кВт, близкая тепловая нагрузка окажется в воздухе зала плюс затраты самого устройства. Это перенос границы теплообмена, а не исчезновение нагрузки на охлаждение площадки.
Для проекта Cisco–Supermicro из этого следует конкретная проверка: на общей схеме отмечают, куда уходят тепло вычислений и тепло сетевой фабрики, кто контролирует расход и температуры, где находятся датчики течи и как передаются аварии. Наличие отдельной панели Supermicro для жидкостного контура не доказывает, что все эти сигналы уже доступны через выбранную систему Cisco. Для каждой интеграции нужны версия, способ получения телеметрии и проверенная реакция оператора.
Как управлять комплексом и какие функции нужно проверить отдельно?
Единая эксплуатационная модель — одна из причин рассматривать совместное предложение. Cisco связывает управление сетью с Nexus One, вычислительной частью — с поддерживаемыми возможностями Intersight, а междоменное представление — с Cisco Cloud Control. Для конкретного заказа необходимо проверить поддержку каждой платформы и функции. Умение отобразить устройство в инвентаре не равно возможности автоматически обновить его прошивку или восстановить конфигурацию.
В материалах совместного предложения интеграция управления вычислительными системами через Intersight и Nexus One привязана к четвёртому календарному кварталу 2026 года. По состоянию на дату этого разбора нельзя считать весь перечень интеграций доступным для любого сервера и любой редакции ПО. В технической спецификации указывают фактически доступную функцию, требуемую лицензию, поддерживаемую модель и процедуру проверки.
Удобно разделить операции по этапам. До развёртывания готовят инвентарь, адресный план и политики. При запуске применяют согласованные настройки и проверяют соответствие проекту. В эксплуатации отслеживают состояние, обновления и отклонения. Для аварии нужен отдельный путь восстановления. Если одна панель пока охватывает лишь часть этапов, оставшиеся операции должны иметь понятный инструмент и ответственного.
Что должна показывать телеметрия всей AI Factory?
Начинайте с возможности связать прикладное задание с оборудованием. Нужны идентификатор задания, время, узлы, GPU, сетевые интерфейсы и версия модели. Затем добавляются показатели вычислений, памяти, сетевых очередей, хранения, мощности и охлаждения. Без такой связи график «GPU загружен на 40%» остаётся наблюдением, которому можно придумать много разных объяснений.
Например, время шага выросло с одной до полутора секунд. В тот же интервал мог начаться checkpoint, появиться поток другого арендатора, снизиться частота GPU или вырасти время подготовки данных. Для различения этих причин нужны сопоставимые временные ряды. Использование DCGM для GPU-метрик и сетевой телеметрии имеет смысл тогда, когда данные можно привязать к одному событию, а не только вывести на соседние экраны.
| Наблюдаемое изменение | Какие данные сопоставить | Первое направление проверки |
|---|---|---|
| GPU часто ждёт, сеть почти свободна | CPU, время подготовки batch, чтение и локальные копирования | Подача данных и внутренний путь узла |
| Межузловые операции замедлились | Время коллективов, очереди, ошибки, состояние NIC и путей | Фабрика и соответствие адаптеров |
| Периодические длинные паузы | Checkpoint, журнал хранилища, очередь записи | Пиковый поток сохранения состояния |
| Падает скорость после прогрева | Частоты, мощность, температуры, параметры охлаждения | Тепловые и электрические ограничения |
| Ухудшается задержка API | Очередь, длина запросов, число реплик, внешние зависимости | Весь путь запроса и политика обслуживания |
Частоту опроса выбирают по характеру события. Десятиминутное усреднение не покажет секундную перегрузку так же подробно, как секундный ряд. При этом более частый сбор увеличивает объём данных. В расчётном примере 64 GPU, 100 значений на GPU каждую секунду и 16 байт на значение дают около 8,85 ГБ в сутки только на значения. Индексы, метки, дублирование и журналы увеличат полный объём.
Поэтому вместе с перечнем метрик задают хранение: какие данные остаются детальными, какие агрегируются и сколько времени их можно сопоставлять с инцидентом. Если обращение в поддержку приходит через неделю, а нужные детальные показатели уже удалены, доказать причину будет труднее. Требования к телеметрии относятся к готовности сервиса так же непосредственно, как требования к сетевым портам.
Что защищать: сеть, модель, данные или доступ администратора?
У AI Factory несколько поверхностей риска. Сетевая сегментация ограничивает допустимые соединения. Разграничение доступа определяет, кто читает данные и запускает задания. Защита AI-приложения рассматривает содержимое взаимодействия и поведение модели. Контроль программной цепочки касается контейнеров и артефактов. Эти функции дополняют друг друга, но не становятся взаимозаменяемыми после появления общей панели управления.
Cisco AI Defense включает средства обнаружения AI-активов, проверки моделей и защиты взаимодействия с AI-приложениями. Hypershield относится к распределённому применению сетевых политик и сегментации. Конкретные точки применения, лицензии и поддерживаемые режимы определяются проектом. Наличие логотипа продукта в общей схеме не доказывает, что соответствующая политика уже включена и проверена на трафике заказчика.
Практическая матрица доступа начинается с простых вопросов: может ли команда А прочитать датасет команды Б; может ли контейнер задания обращаться к BMC; разрешено ли модели вызывать произвольный внешний адрес; кто может заменить артефакт модели? Для каждого разрешённого действия нужен владелец и основание. Для запрещённого — воспроизводимый тест, который подтверждает ограничение на нужном уровне.
Почему namespace и разделение GPU не закрывают всю изоляцию?
Namespace помогает организовать ресурсы Kubernetes, но сама по себе эта логическая граница не определяет полную модель безопасности разных арендаторов. Нужны соответствующие права, сетевые политики, ограничения ресурсов, доступ к хранилищу и правила запуска контейнеров. Если арендаторы недоверенные, требования к разделению могут оказаться существенно строже, чем у нескольких команд одной организации.
Аппаратное разделение GPU также не выдаёт права на документы и не ограничивает сетевые обращения приложения. Эти свойства должны обеспечиваться другими уровнями. Поэтому приёмка многопользовательского сервиса включает как нагрузку соседней команды, так и проверку доступа к её данным. Хорошая производительность одного арендатора не доказывает достаточную изоляцию в общем контуре.
Отдельно согласуют обработку журналов запросов. Они могут содержать фрагменты документов, персональные данные или секреты приложений. Полный журнал удобен для отладки, но его состав, срок хранения и круг доступа должны соответствовать правилам заказчика. Защищённая AI Factory не должна незаметно создавать менее контролируемую копию данных в системе наблюдаемости.
Как выпускать обновления без потери воспроизводимости?
Для каждой конфигурации полезно хранить эталон: версии, параметры запуска, контрольные суммы образов, профили сети и результаты базовых тестов. Обновление сначала проходит на выделенной группе с репрезентативной задачей. Затем сравнивают корректность результата, задержки, обмены и потребление. Одной проверки, что контейнер запускается, недостаточно для обновления всей фабрики.
Особое внимание уделяют изменению модели или квантования. Оно способно улучшить скорость и одновременно изменить качество ответа. Если приёмка включала конкретный набор данных и редакцию модели, после замены нужно проверить прикладные критерии снова. Такое изменение относится к сервису целиком, даже если серверы и сеть остались прежними.
Автоматизация полезна там, где её действия ограничены понятными правилами и оставляют журнал. Перед передачей системе права менять конфигурацию определяют допустимые операции, контроль результата и возврат. Это относится и к AI-помощникам эксплуатации: предложенная диагностика должна быть проверяема инженером, а автоматическое действие — соответствовать согласованному уровню полномочий.
Что дают CVIS и валидация архитектуры?
Cisco Validated Infrastructure Services, или CVIS, предназначены для проверки реализации относительно выбранной референсной архитектуры. Подход согласован с методикой NVIDIA Infrastructure Services. Полезный результат для заказчика — подтверждение того, что поставленная конфигурация соответствует согласованному дизайну и прошла определённую программу испытаний. Объём работ и состав итогового отчёта должны быть зафиксированы в заказе.
Валидация относится к конкретному составу системы. Если заменены адаптер, коммутатор, версия прошивки или профиль сети, необходимо выяснить, сохраняется ли применимость исходной проверки. Совпадение общего названия платформы не отвечает на этот вопрос. Поэтому отчёт следует читать вместе с ведомостью компонентов и версий, а исключения выносить в отдельный список.
Также нужно различать соответствие архитектуре и выполнение прикладного SLA. Корректно собранная фабрика может не обеспечить нужный TTFT для выбранной модели при заданной одновременности. Это не противоречие: аппаратная проверка и тест приложения измеряют разные свойства. Чтобы избежать спора после поставки, оба вида требований описывают до заказа и заранее выбирают нагрузку для проверки.
Рекомендуемая программа приёмки всего комплекса
Приведённая ниже программа — инженерный шаблон для согласования, а не универсальный обязательный перечень CVIS. Она помогает связать аппаратный результат с эксплуатацией заказчика. Пороговые значения, длительность и допустимые операции определяют для конкретной конфигурации. Нагрузочные и аварийные проверки выполняют по согласованной методике с ответственными специалистами.
| Этап | Содержание проверки | Сохраняемый результат |
|---|---|---|
| 1. Инвентаризация | Модели, серийные номера, количество GPU/NIC/накопителей, комплектация | Фактическая ведомость поставки и перечень отклонений |
| 2. Локальная диагностика | Память, GPU, соединения, накопители и работа охлаждения | Отчёты с версиями средств проверки и условиями |
| 3. Сетевая фабрика | Скорости, топология, обмены, стабильность и предусмотренные сценарии перегрузки | Карта соединений, счётчики и результаты нагрузок |
| 4. Тракт данных | Параллельное чтение, массовый старт, checkpoint и восстановление | Время операций и достигнутые показатели на рабочем формате данных |
| 5. Приложение | Согласованные модели, точность, контекст, одновременность, длительный режим | Задержки, производительность, ошибки и результаты проверки корректности |
| 6. Эксплуатация | Мониторинг, доступ, резервирование, обновление и обращение в поддержку | Инструкции, назначенные ответственные и доказательство проверенных процедур |
Сначала проходят локальные проверки, затем межузловые, после этого прикладные. Такая последовательность сокращает пространство причин при неисправности. Если один GPU не проходит локальную диагностику, масштабный тест распределённого обучения не должен использоваться как способ «посмотреть, заработает ли всё вместе». Иначе результаты будут содержать известную проблему, которую потом трудно отделить от сетевых ограничений.
Для длительного режима проверяют не только максимальное значение в первые секунды. Нужны выход на рабочую температуру, сохранение частот и повторяемость. Продолжительность испытания выбирают по рискам и требованиям проекта; одинаковое число часов не является универсальным стандартом для всех задач. В отчёте сохраняют временной ряд, чтобы кратковременные события не растворились в итоговой средней цифре.
Как проверить восстановление и деградацию?
Список сценариев зависит от проекта: недоступность одного узла, потеря части сетевых путей, недоступность источника данных, сбой управляющего компонента. Для каждого сценария заранее задают ожидаемое поведение. Где-то допустим перезапуск задания, где-то сервис должен продолжать отвечать с меньшей мощностью. Название «отказоустойчивый» без описания этих условий допускает слишком много разных толкований.
Наличие резервных путей не гарантирует прозрачного продолжения уже работающего распределённого задания. Сетевой стек может восстановить связность, а приложение — завершиться по тайм-ауту. Поэтому проверяют отдельно восстановление инфраструктуры и восстановление прикладной работы. Особенно полезно измерить полный путь: обнаружение, решение, перезапуск, чтение состояния и выход на нормальную скорость.
Частота checkpoint связана с таким сценарием. Если состояние сохраняется каждые 30 минут, один сбой может потребовать повторить часть вычислений после последнего успешного сохранения. К этому добавляется время восстановления. Более частое сохранение сокращает потенциально потерянную работу, но увеличивает нагрузку хранения. Решение выбирают по совместному расчёту, а не только по доступной ёмкости SSD.
Кто обслуживает сервер, сеть и жидкостный контур?
В совместном предложении Cisco принимает первичные обращения и координирует их направление соответствующему участнику. Каждый производитель поддерживает свою часть в рамках действующих условий. Для серверных платформ предусмотрены сервисы Cisco CX, а обслуживание жидкостных компонентов требует участия соответствующей сервисной стороны Supermicro. Конкретные действия, территории и сроки определяет договор на заказанную конфигурацию.
«Нам больше не приходится выбирать между производительностью, надёжностью и удобством управления», — Джеймс Мэннинг, сооснователь и генеральный директор Sharon AI, о Cisco Secure AI Factory with NVIDIA.
Эта оценка заказчика описывает ожидаемый смысл интегрированного предложения. Для собственного проекта её переводят в проверяемые условия: одна точка приёма обращения, согласованный маршрут эскалации и понятный порядок действий при аппаратном инциденте. Цитата не заменяет протокол испытаний и не задаёт время восстановления вашей системы.
Сервисное обещание нужно разложить на этапы. Время ответа инженера отличается от времени диагностики, доставки компонента, приезда специалиста и завершения восстановления приложения. Четыре часа на реакцию не равны четырём часам до полной работоспособности. Условия доступности запчастей, доступа на площадку и допустимых сервисных операций должны быть согласованы отдельно.
Для жидкостной системы уточняют, кто имеет право выполнять работы с соединениями, кто предоставляет расходные материалы и кто отвечает за повторную проверку после вмешательства. Для GPU-узла выясняют порядок замены ускорителя и возвращения в вычислительный пул. Для коммутатора — восстановление конфигурации и проверку фабрики. Эти процедуры связаны, но могут требовать разных специалистов.
Какие документы о поддержке запросить до покупки?
Нужны описание услуг с перечнем устройств и серийных номеров, сроком действия, территорией, каналом обращения и исключениями. Отдельно проверяют права на получение ПО, обновлений и лицензий. Для зарубежного или закрытого контура проверяют фактическую возможность использовать выбранную модель обслуживания. Глобальное объявление предложения не заменяет такую проверку для конкретного заказчика.
Хорошее дополнение — пробное непроизводственное обращение в согласованный сервисный канал до запуска критичной нагрузки. Оно подтверждает, что оборудование зарегистрировано, полномочия распознаются и контактная информация работает. Такой тест не измеряет качество решения сложного инцидента, но позволяет заранее найти организационные ошибки. Исправлять их во время аварии обычно значительно сложнее.
Два расчётных сценария: корпоративный инференс и распределённое обучение
Ниже приведены инженерные сценарии для сравнения решений. Они не описывают выполненные нами внедрения, не заменяют проект и не являются опубликованными результатами испытаний конкретных систем. Их задача — показать последовательность принятия решения: от нагрузки и режима отказа к вычислительной единице, сети, данным и составу поставки. Числа производительности в примерах заданы условно.
Сценарий 1. Несколько независимых сервисов на PCIe GPU
Предположим, организация разворачивает четыре внутренних сервиса. У каждого своя редакция модели, ограниченный набор пользователей и собственный график пакетной обработки. Распределённого обучения нет. В качестве исходного варианта рассматривается восьмиускорительный PCIe-сервер: по два GPU на сервис при условии поддержки такого размещения выбранным стеком. Здесь наиболее частые вычислительные взаимодействия предполагаются внутри выделенной группы устройств.
Для H200 NVL арифметическая ёмкость двух GPU составляет 282 ГБ HBM3e. Условные веса объёмом 140 ГБ оставляют часть ресурса на кеш и исполнение, но реальная допустимая одновременность требует испытания. Решение о NVLink-мостах и способе распределения принимает проектировщик с учётом поддерживаемой комплектации. Из расчёта ёмкости нельзя вывести универсальную скорость ответа.
В этом сценарии главный риск может находиться в совместном старте сервисов и доступе к документам. Если все четыре сервиса обновляют веса утром, хранилище должно выдержать одновременную загрузку. Если один сервис выполняет тяжёлую пакетную задачу, нужно проверить влияние на соседей через CPU, PCIe, накопители и питание. Разделение по двум GPU не изолирует эти общие ресурсы полностью.
Сетевая часть начинается с требований пользователей и источников данных. Сверхмощная back-end-фабрика не должна появляться в проекте только потому, что в сервере стоят дорогие GPU. С другой стороны, небольшой пользовательский поток не исключает большого потока при загрузке моделей. В спецификации разделяют постоянный сервисный режим, обновление и восстановление после отказа.
Один сервер остаётся одной общей точкой остановки для размещённых на нём сервисов. Если бизнес требует продолжать работу при его недоступности, рассматривают второй узел и политику размещения реплик. Дополнительные GPU тогда могут понадобиться ради доступности, а не ради скорости штатного режима. В приёмке проверяют, какие сервисы сохранятся и с какой допустимой производительностью после переключения.
Сценарий 2. Распределённая задача на HGX-узлах
Во втором проекте одна задача требует нескольких HGX-узлов. Здесь сеть становится частью вычислительного процесса, поэтому проверяют одновременно локальные обмены, межузловые коллективы и масштабирование приложения. Рост числа устройств имеет смысл оценивать по двум показателям: времени завершения задачи и суммарному занятому вычислительному ресурсу. Они могут изменяться в разные стороны.
Возьмём условные времена одной и той же работы: 800 секунд на одном восьмиускорительном узле, 240 секунд на четырёх и 150 секунд на восьми. В этом примере задача, модель, точность и общий объём работы сохраняются. Числа служат только для объяснения метода. При практическом тестировании их получают на конкретном приложении и проверяют повторяемость.
| Число HGX-узлов | Время условной работы | Ускорение относительно одного узла | Эффективность масштабирования | Занятый ресурс |
|---|---|---|---|---|
| 1, всего 8 GPU | 800 с | 1× | 100% | 6 400 GPU·с |
| 4, всего 32 GPU | 240 с | 3,33× | 83,3% | 7 680 GPU·с |
| 8, всего 64 GPU | 150 с | 5,33× | 66,7% | 9 600 GPU·с |
Восьмиузловая конфигурация завершает работу быстрее, но использует в полтора раза больше GPU-секунд, чем одиночный узел. Если обязательное окно составляет 200 секунд, она может быть оправдана. Если задачи независимые и допускают более длительное выполнение, другой способ распределения ресурсов может дать лучший общий результат. Это инженерный выбор по требованиям, а не соревнование максимальных чисел.
Ухудшение эффективности не следует сразу приписывать Cisco, Supermicro или сети вообще. Причиной может быть алгоритм приложения, малый объём работы на GPU, подготовка данных, число синхронизаций или неоднородность узлов. Сначала сравнивают локальные тесты, межузловой обмен и профиль приложения. Только после выделения ограничивающего участка появляется основание менять оборудование или конфигурацию.
Для этого сценария также требуется повторить проверку при сохранении состояния и при соседней нагрузке. Максимальная скорость в пустом кластере не описывает облачную эксплуатацию с несколькими арендаторами. Если проект рассчитан на одновременные задания, в критерии приёмки включают соответствующее размещение и допустимое влияние соседей. Масштабирование и изоляция производительности становятся отдельными проверяемыми свойствами.
Что включить в запрос поставщику Cisco и Supermicro?
Хороший запрос начинается с описания нагрузки и границ проекта. Далее указывают желаемый класс платформы и ограничения площадки. Поставщик должен получить достаточно информации, чтобы объяснить выбор, а заказчик — достаточно подробную спецификацию, чтобы сопоставить предложения. Две строки «восемь GPU» и «800G сеть» для такого сравнения недостаточны.
- Задача: модели, формат данных, точность, длины запросов, одновременность или параметры обучения.
- Критерии результата: время, задержки, допустимые ошибки, продолжительность и методика испытаний.
- Вычисления: точные системы, состав GPU, CPU, памяти, накопителей и дополнительных модулей.
- Топология: отдельные роли сетей, карта соединений, конечные порты, uplink и возможности расширения.
- Физические линии: кабели, трансиверы, breakout, длины, стандарты и матрицы совместимости.
- Программная конфигурация: версии, профили, контейнеры, лицензии и доступ к обновлениям.
- Площадка: мощность, вводы, охлаждение, размещение, маршрут доставки и сервисные проходы.
- Валидация: точный объём CVIS или другой согласованной проверки, итоговые отчёты и исключения.
- Эксплуатация: телеметрия, резервное копирование конфигурации, инструкции восстановления и обучение команды.
- Поддержка: договорные стороны, территория, сроки, запчасти, сервис жидкостной части и порядок эскалации.
Для аппаратной основы можно выбрать подходящий класс в каталоге GPU-систем, затем передать сетевую часть на согласование через сайт официального поставщика Cisco в России ru-cisco.com. В запросе следует прямо указать, рассматривается ли конкретное совместное предложение Secure AI Factory или отдельная интеграция на оборудовании двух производителей. Это влияет на состав работ, применимость валидации и сервисные условия.
Нужны ли отдельные лицензии на управление и AI-ПО?
Даже когда часть ПО включена в выбранную комплектацию, её состав, срок и права использования должны быть перечислены. Возможности Intersight зависят от лицензирования и поддерживаемой конфигурации. У NVIDIA AI Enterprise и сопутствующих сервисов также есть свои условия. Нельзя переносить комплект лицензий одной GPU-системы на другую только из-за одинакового производителя ускорителей.
В спецификации полезно разделять бессрочные аппаратные права, подписки, техническую поддержку и платные услуги развёртывания. Для продления нужно понимать дату окончания каждого компонента и влияние окончания на работу. Если управление требует определённого внешнего сервиса, его доступность проверяют для площадки заказчика. Этот вопрос закрывается до заказа, а не после первого входа в интерфейс.
Можно ли использовать уже установленные коммутаторы Cisco?
Это определяется их точными моделями, портами, версиями и назначением. Существующие устройства могут оказаться подходящими для отдельных ролей, но не соответствовать требованиям вычислительного back-end. При повторном использовании сравнивают фактические возможности с согласованным проектом и проводят нужные испытания. Экономический эффект оценивают вместе с ограничениями роста и условиями поддержки получившейся комбинации.
Какие признаки показывают, что предложение ещё не готово к заказу?
Критичные пробелы — неизвестный состав охлаждения, отсутствие карты портов, версии вида «latest», одинаковая гарантийная строка для всех участников и обещание производительности без тестовой нагрузки. Ещё один признак — подмена рабочего расхода мощности суммой мощностей резервных блоков питания. Каждый такой пробел можно устранить конкретным документом или проверкой; общая презентация проекта его не закрывает.
Перед подписанием спецификации запросите итоговый комплект: согласованную нагрузку, ведомость оборудования и ПО, схему границ подключения, методику приёмки и сервисную матрицу. После этого можно принять предметное решение о закупке. В работающей AI Factory вычисления, сеть и инженерная инфраструктура должны соответствовать одной задаче и одной проверяемой конфигурации.
Как сохранить возможность расширения и переноса конфигурации?
Расширение начинается с совместимости следующей партии с уже установленной. В закупочном документе полезно указать, какие части можно добавлять независимо, а какие должны оставаться однородными в пределах задания. Новые узлы могут иметь другой выпуск прошивки или другую ревизию адаптера. Даже если артикул корпуса не изменился, перед включением в общий пул требуется сверить фактическую комплектацию и программный набор.
Неоднородность не всегда мешает эксплуатации. Разные типы задач можно размещать в разных пулах. Например, один пул обслуживает независимые реплики, другой предназначен для распределённых заданий с согласованным составом устройств. Но планировщик должен знать ограничения размещения. Если он случайно объединит устройства с разными характеристиками, длительность общей операции может определяться более медленным участником.
Для перехода на новую конфигурацию сохраняют эталонную задачу и данные её запуска. В пакет входят описание входов, модель с контрольной суммой, параметры контейнера, версии библиотек и ожидаемые критерии корректности. При смене платформы этот пакет позволяет сравнивать результаты без восстановления исходных условий по памяти инженера. Он также помогает отделить аппаратное изменение от изменения алгоритма.
Отдельно сохраняют конфигурацию сети в пригодном для анализа виде: роли портов, адресацию, политики и применённые профили. Копия настроек полезна, но не заменяет описание их назначения. При замене устройства синтаксис команд может измениться, тогда как требование к маршруту или изоляции останется прежним. Документированный замысел позволяет проверить новую реализацию по тому же требованию.
С хранилищем проверяют обратимость данных: возможность выгрузить модели, наборы и состояние в согласованном формате, необходимые права и время операции. Быстрая работа внутри платформы не гарантирует быстрый перенос наружу. Если миграция потребует временно держать две копии, соответствующая ёмкость и сетевой поток должны быть доступны. Полезно проверить перенос на небольшой репрезентативной выборке до появления большого архива.
Наконец, договоритесь о моменте повторной валидации. Добавление узлов меняет количество участников, нагрузку uplink, объём checkpoint и время массового старта. Поэтому расширение полезно завершать тем же коротким набором проверок, который зафиксирован для первой очереди. История результатов покажет, сохранились ли нужные свойства комплекса и где появилась новая граница масштабирования. Подробную консультацию по оборудованию Циско можно получить на сайте поставщика Cisco в России и СНГ.