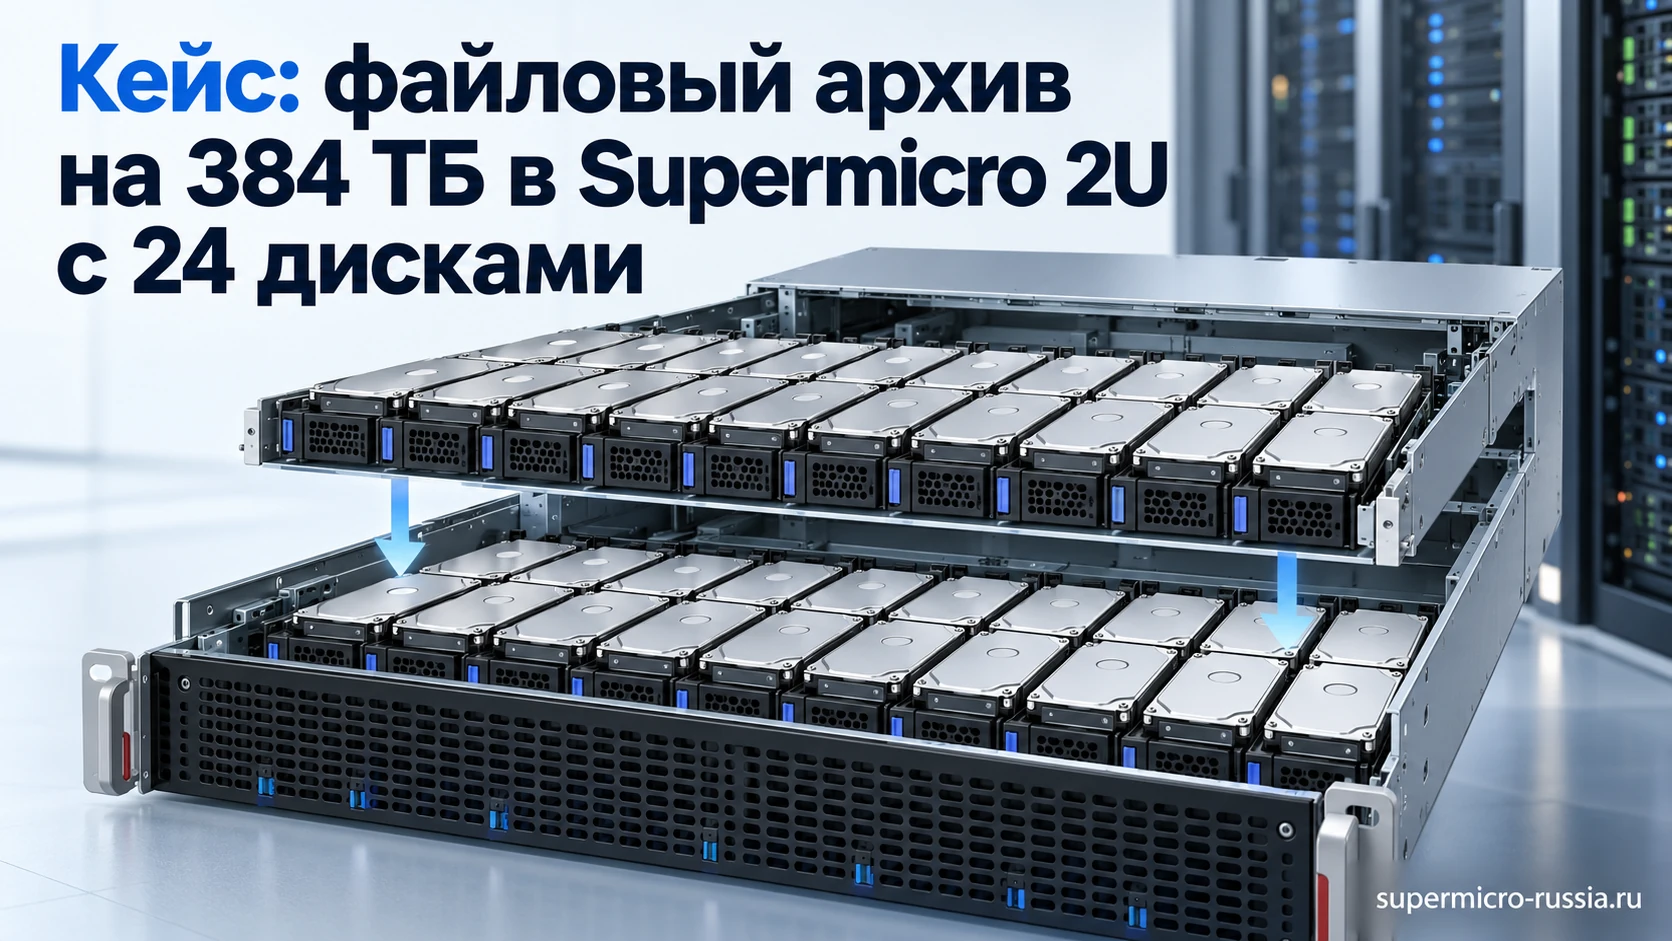
Кейс: файловый архив на 384 ТБ в Supermicro 2U с 24 дисками
Двадцать четыре HDD по 16 ТБ в корпусе 2U выглядят как простой способ получить 384 ТБ. Для рабочего архива это только начало расчёта. После избыточности, резерва места и сохранения версий полезный объём заметно уменьшается, а полная передача данных по сети может занять несколько суток. В этом кейсе разбираем Supermicro SSG-6029P-E1CR24H с платой X11DSC+ и выясняем, как превратить плотную дисковую платформу в обслуживаемый файловый архив.
Основа — показанная ServerFlow конфигурация на 24 HDD. Автор использовал JBOD и ZFS RAIDZ1; при копировании файла размером 83 ГБ сообщил скорость около 1 ГБ/с. Это результат конкретной передачи, а не гарантия производительности всех файловых операций. Ниже отдельно приведены наши расчётные варианты защиты и бюджета ёмкости для новой системы.
Для какого архива нужна такая плотность
Подходящий профиль — большие завершённые проекты, медиаматериалы, инженерные результаты, резервные наборы с последовательным доступом. Данные сохраняются долго, а стоимость терабайта важнее минимальной задержки отдельного запроса. Несколько монтажных рабочих мест могут читать крупные файлы, но система не должна без проверки превращаться в основное хранилище транзакционной базы или большого числа активных ВМ.
Назовём конкретную задачу для расчёта: 140 ТБ уже накопленных материалов, ежегодный прирост 35 ТБ, горизонт планирования три года. Только актуальные данные достигнут 245 ТБ. Если ещё 15 ТБ отвести под версии и временные выдачи, получится 260 ТБ. Вариант, в котором «после RAID остаётся около 320 ТБ», уже не выглядит избыточным, если запланировать 20% свободного места.
Для архива нужно знать частоту возврата старых проектов. Если 95% обращений приходится на последние 10 ТБ, быстрый рабочий слой и большой HDD-архив могут быть рациональнее единственного универсального пула. Если старые файлы непрерывно читают десятки клиентов, требования к сети и случайным операциям будут другими.
Что представляет собой SSG-6029P-E1CR24H
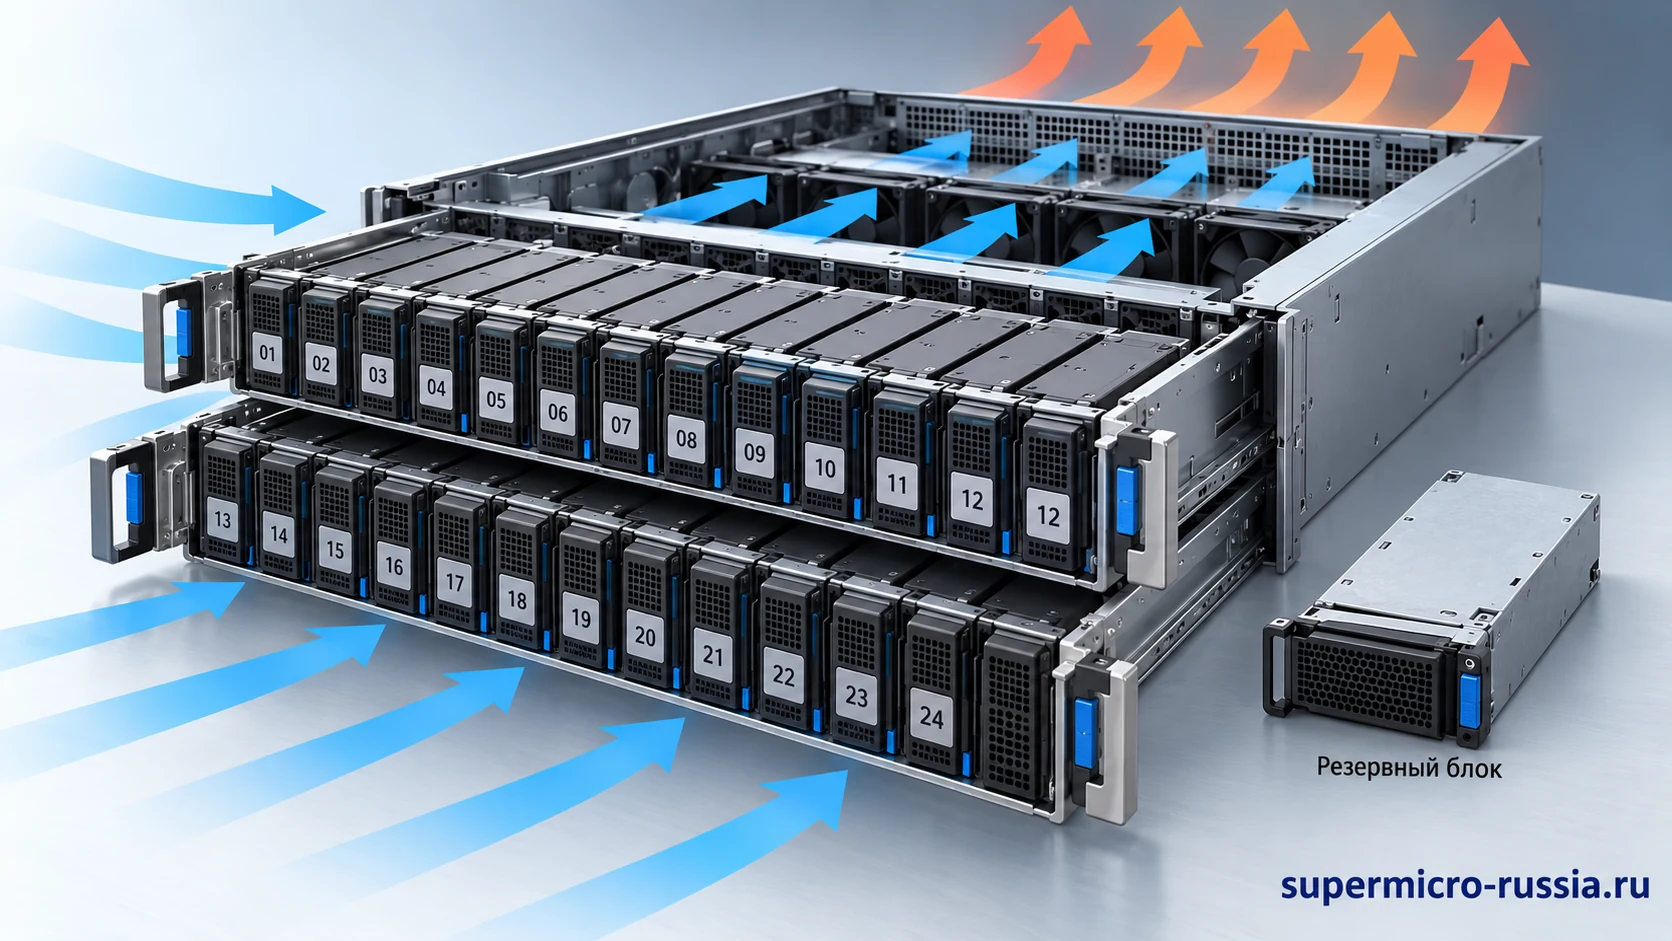
Это SuperStorage поколения Simply Double: 24 основных 3,5-дюймовых отсека SAS/SATA размещены в 2U с плотной двухуровневой компоновкой. Внутри используется материнская плата Supermicro X11DSC+. Плата предназначена для определённой серверной платформы; её нельзя оценивать как обычную ATX-модель для произвольного корпуса.
В архитектуре используются отдельные серверные модули, включая SIOM для сети и мезонинный контроллер хранения. Поэтому наименование шасси ещё не описывает готовую конфигурацию. В заказе фиксируются установленный сетевой модуль, контроллер, режим его работы, кабели и бэкплейн. Наличие посадочного места под модуль не означает наличие самого модуля в конкретной поставке.
| Элемент | Почему важен в этом кейсе | Что проверить до покупки |
|---|---|---|
| 24 отсека 3,5″ | Высокая ёмкость на единицу стойки | Доступ ко всем позициям, салазки и маркировку |
| X11DSC+ | Согласованная плата серверной платформы | Точный состав, CPU, память и версии прошивок |
| SIOM | Сетевой интерфейс под задачу | Модель, число портов, тип кабелей и совместимость коммутатора |
| Контроллер и бэкплейн | Доступ ОС к 24 HDD | Режим JBOD/HBA, видимость SMART и ошибок каждого диска |
| Резервируемое питание | Продолжение работы при допустимом отказе БП | Мощность на используемом входном напряжении и схема электропитания |
| Механика стойки | Безопасный доступ к плотному узлу | Глубина, рельсы, нагрузка и сервисный зазор |
Сколько полезного места дают 24 диска по 16 ТБ
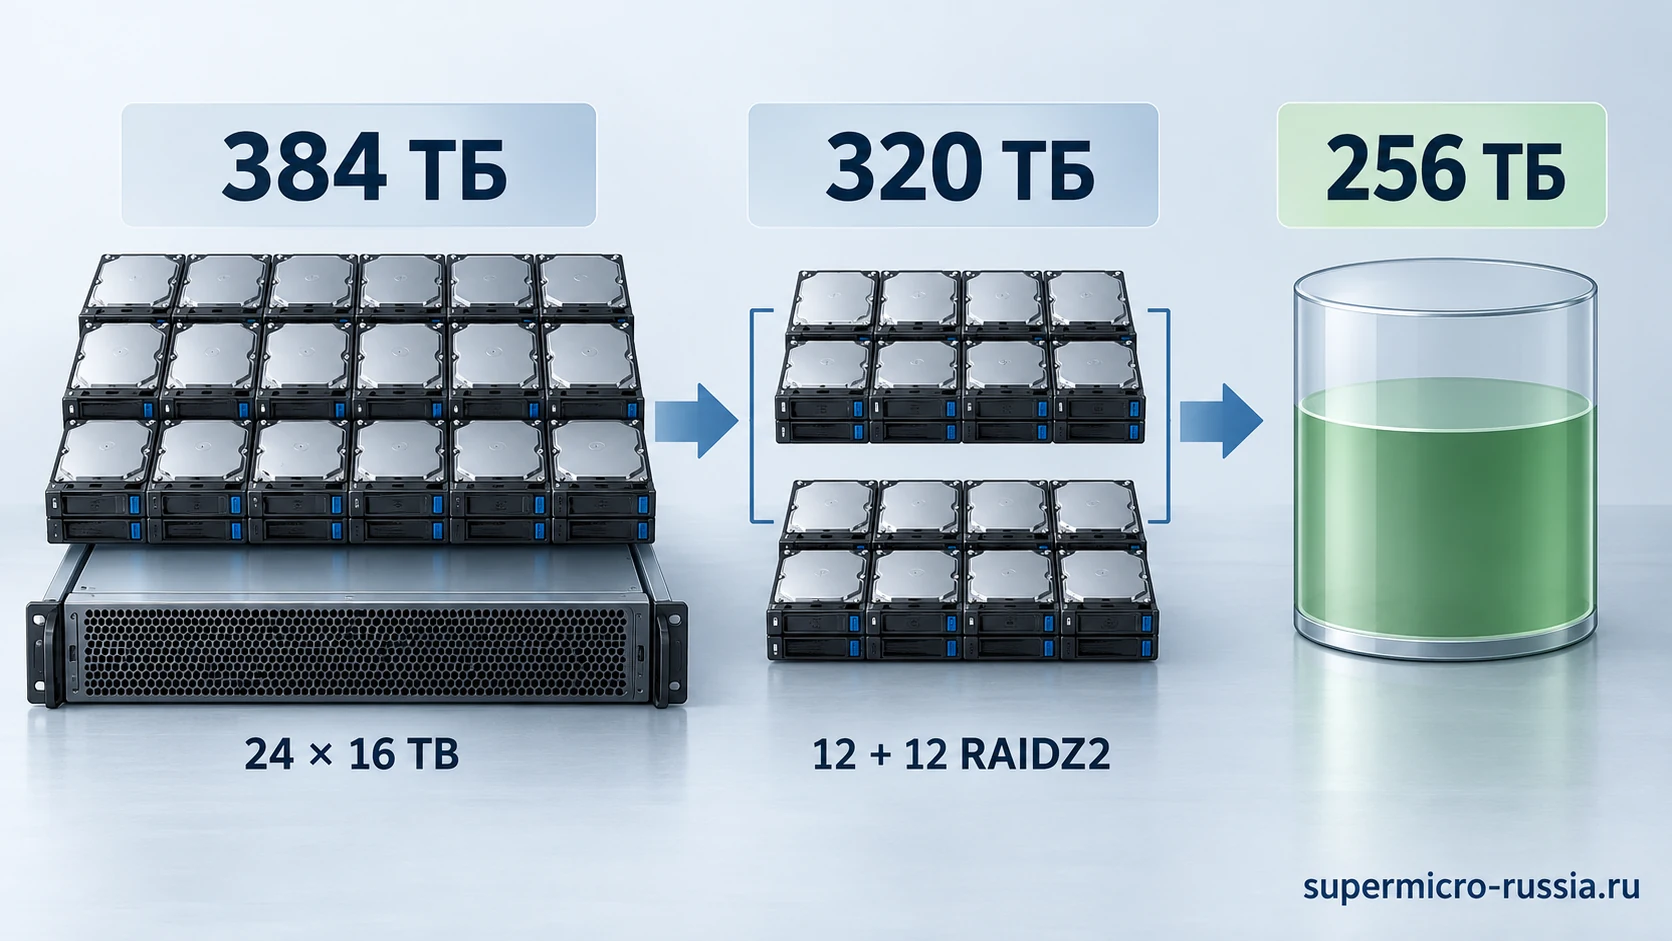
Сырая сумма составляет 384 ТБ, или около 349,25 ТиБ. Это ещё не объём файлового ресурса. Для предварительного сравнения можно вычесть количество дисковых эквивалентов паритета. Итог уточняется по реальной файловой системе, размеру блоков, метаданным и характеру файлов.
| Расчётная схема | Номинально до накладных расходов | После проектного резерва 20% | Главная особенность |
|---|---|---|---|
| Один vdev RAIDZ1, 24 HDD | Около 368 ТБ | Около 294,4 ТБ | Только одна дисковая избыточность на очень широкий vdev |
| Два vdev RAIDZ2 по 12 HDD | Около 320 ТБ | Около 256 ТБ | Два отказа в пределах каждого vdev |
| Три vdev RAIDZ2 по 8 HDD | Около 288 ТБ | Около 230,4 ТБ | Больше отдельных групп, меньше ёмкость |
| Два vdev RAIDZ3 по 12 HDD | Около 288 ТБ | Около 230,4 ТБ | Три дисковые избыточности в каждой группе |
| 12 зеркал по два HDD | 192 ТБ | 153,6 ТБ | Иной баланс случайных операций и ёмкости |
Это сравнение топологий, а не обещание точного значения в интерфейсе ZFS. Несколько vdev в одном пуле не являются независимыми резервными копиями: потеря одного data-vdev обычно означает потерю пула. Поэтому нельзя сложить допустимые отказы всех групп и объявить, что «массив гарантированно выдерживает любые четыре диска».
В примере с потребностью 260 ТБ через три года два RAIDZ2 по 12 дисков дают около 256 ТБ при выбранном резерве ещё до дополнительных расходов. Решение уже не проходит план. Нужно уменьшить горизонт, выделить холодный слой, увеличить номинал HDD в новой спецификации или выбрать другую платформу. Такой вывод полезнее, чем формальная надпись «384 ТБ».
Почему не стоит повторять широкий RAIDZ1 без пересчёта риска
В исходном эксперименте выбран RAIDZ1. Для демонстрации сборки это объясняет полученную конфигурацию, но для ценного производственного архива один уровень дисковой избыточности на 24 больших HDD — серьёзное ограничение. Восстановление после отказа нагружает остальные носители и длится намного дольше, чем замена салазок.
При таком масштабе сравнивают несколько более узких групп с двойным или тройным паритетом. У каждой схемы своя цена: часть ёмкости уходит на защиту, меняется доступная параллельность и сложность расширения. Выбор зависит от допустимости простоя, доступного бэкапа и времени его возврата. Одна диаграмма RAID не отвечает на эти вопросы.
Подробный разбор контроллеров и режимов вынесен в статью о настройке RAID. Здесь важно другое: ZFS должна предсказуемо видеть носители. JBOD на конкретном RAID-контроллере не следует автоматически считать полным эквивалентом любого HBA. Проверяют передачу ошибок, серийных номеров, flush-команд и поведение при отказах.
Сколько времени занимает восстановление диска 16 ТБ
Даже простое чтение 16 ТБ при постоянных 200 МБ/с занимает около 22,2 часа. При 100 МБ/с — около 44,4 часа, при 50 МБ/с — около 88,9 часа. Это идеализированный расчёт объёма и потока, не фактическое время resilver: ZFS может обрабатывать только размещённые данные, а рабочая нагрузка, фрагментация и ограничения тракта меняют скорость.
Узкое место может находиться не в одном HDD, а в контроллере, соединении с бэкплейном или оставшихся дисках группы. Если в период восстановления сотрудники продолжают читать архив, бюджет ресурсов делится между работой и восстановлением защиты. Удобно заранее определить, что важнее: сохранить обычную скорость сервиса или быстрее вернуть избыточность.
Резервный диск сокращает ожидание начала восстановления только при настроенной и проверенной процедуре. Лежащий на складе HDD и назначенный hot spare — разные варианты. Но ни один не увеличивает число паритетных дисков до завершения перестроения и не является внешней копией данных.
Что означает результат около 1 ГБ/с
ServerFlow сообщил около 1 ГБ/с при передаче файла 83 ГБ. По порядку величины это соответствует примерно 8 Гбит/с полезного потока. Но методика не даёт оснований объявить такой результат постоянной скоростью массива, случайными IOPS или пределом самой платформы. Влияют кэш, направление передачи, файловый протокол и накопитель второй стороны.
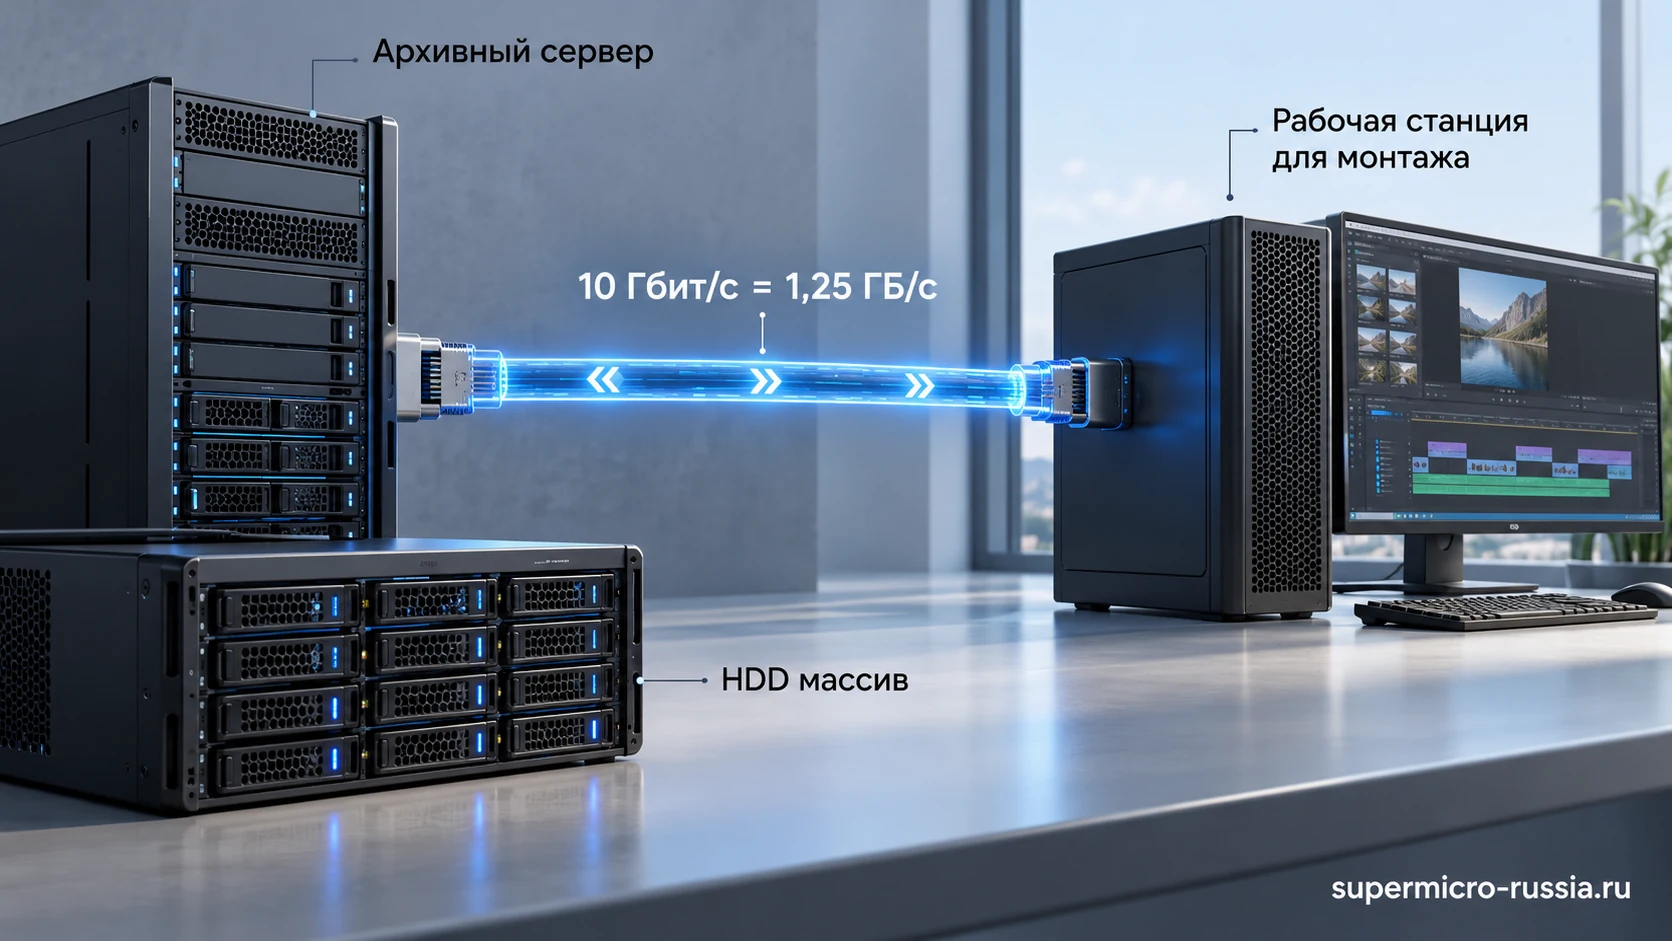
Линия 10GbE имеет арифметическую границу 1,25 ГБ/с до накладных расходов. Если архив способен выдать больше, одиночный десятигигабитный клиент всё равно ограничен своим трактом. При переходе на 25GbE граница линии вырастает до 3,125 ГБ/с, но дисковая часть не ускоряется от замены сетевого модуля сама по себе.
Для приёмки нужны разные профили: один большой файл, несколько параллельных клиентов, каталог с мелкими файлами и длительная запись объёмом больше RAM. Их нельзя сводить к одной цифре. Архив, который быстро отдаёт видео, способен заметно замедляться при обходе миллионов мелких документов.
Как рассчитать окно резервного копирования
Первичная передача 256 ТБ при устойчивых 1 ГБ/с займёт около 71,1 часа. При 500 МБ/с — около 142,2 часа, почти шесть суток. Это только движение полезных байтов без обхода каталогов, повторов и проверки. Поэтому план «полный бэкап за ночь» для такого массива физически не сходится даже при исправной сети.
Ежедневные изменения — другая задача. Если в сутки появляется 2 ТБ новых материалов, при 250 МБ/с их передача займёт около 2,2 часа. Прибавляются обнаружение изменений, обслуживание мелких файлов и контроль целостности. Первичное заполнение, ежедневная копия и полное восстановление должны иметь три отдельных расчёта.
RPO и RTO привязываются к бизнес-процессу. Для архива завершённых проектов допустим возврат за несколько суток, для текущего производства — часто нет. Активные проекты можно резервировать чаще и восстанавливать первыми, а старые материалы возвращать во второй очереди. Это должно быть согласованным порядком, а не импровизацией во время сбоя.
Как выбирать CPU, RAM и SSD для архивного узла
Большому HDD-архиву нужен достаточный процессор для протоколов, контрольных сумм, шифрования и параллельных задач. Но максимальное число ядер не компенсирует медленный клиентский линк. Сначала фиксируют нагрузку и нужные функции, затем проверяют загрузку CPU в длительном тесте с теми же настройками, что будут в эксплуатации.
Память полезна для кэширования часто читаемых метаданных и данных. Оценивать её только формулой «гигабайт на терабайт» неверно. В архиве из крупных последовательных файлов и в каталоге миллионов мелких объектов при одной ёмкости будут разные требования. Отдельно учитываются службы, агенты резервирования и выбранная дедупликация, если она вообще необходима.
SSD под систему, быстрый рабочий слой, L2ARC, SLOG и special-vdev решают разные задачи. Особенно осторожно нужно относиться к special-vdev: это часть структуры пула, её отказ при недостаточной избыточности может нарушить доступ ко всему хранилищу. Нельзя добавлять единственный SSD в критическую роль только ради ускорения интерфейса.
Как обслуживать 24 диска в 2U
Плотная компоновка повышает цену простой ошибки: вытащить не тот диск в деградированном массиве опаснее, чем неудачно подписать коробку. До загрузки данных составляют карту «серийный номер → физический отсек → ОС → vdev». Проверяют индикацию поиска накопителя и процедуру замены. Карта хранится отдельно от самого сервера.
Рельсы, глубина стойки и свободное место для обслуживания входят в проект. Нужно понимать, какие операции требуют выдвижения шасси и как при этом ведут себя сетевые и силовые кабели. Поднятие плотного сервера с HDD не должно превращаться в работу одного человека без подходящей оснастки.
Проверка температур охватывает все отсеки, в том числе второй уровень, при закрытом корпусе. Пустые позиции, заглушки и штатные воздуховоды влияют на поток. Уменьшение оборотов ради тишины без проверки дальних дисков способно скрыть перегрев именно в наиболее плотной зоне.
Резервные БП и общие точки отказа
Два блока питания помогают пережить отказ одного модуля в допустимом режиме нагрузки. Они не защищают от отключения единственной розетки или общего неисправного PDU. Если оба кабеля подключены к одному источнику, независимость питания не появилась.
При выборе БП учитывают входное напряжение: допустимая мощность конкретного серверного модуля может отличаться для разных диапазонов сети. Проверяется достаточность оставшегося БП при отказе второго, запуск всех HDD и нагрузка в период восстановления. Номинал на шильдике не заменяет такой расчёт.
Общими остаются шасси, системная плата, часть контроллеров и сетевой тракт. Чтобы пережить отказ сервера целиком, нужен независимый путь возврата данных или другая архитектура. Само слово SuperStorage не определяет доступность файлового сервиса.
Что измерено при запуске, простое и нагрузке 24-дискового сервера
ServerFlow приводит несколько режимов одной двухпроцессорной системы с 24 HDD. Они полезнее одного числа «потребление сервера», потому что запуск дисков, обычная работа и максимальные обороты вентиляторов создают разную нагрузку на питание и помещение.
| Режим в авторском испытании | Мощность системы | Уровень шума | Что означает результат |
|---|---|---|---|
| Одновременный запуск HDD | Краткий подъём примерно до 700 Вт | Отдельное значение не выделено | Пусковой режим отличается от последующего простоя |
| Инициализация компонентов | Около 350–450 Вт | До 66 дБ | Переходное состояние до загрузки системы |
| Простой после загрузки | Около 250 Вт | 56–58 дБ | Результат данного состава оборудования и профиля охлаждения |
| Стресс-тест всех ядер CPU | Около 550 Вт | Около 70 дБ | Нагрузка CPU; это не измерение производительности архива |
| Full Speed без стресс-теста | Около 520 Вт | Около 75 дБ | Мощность всей системы при максимальных оборотах |
Фоновый шум автор оценивает примерно в 33 дБ. Расстояние до микрофона и полный акустический протокол не восстановлены, поэтому сравнивать эти числа с паспортом другого сервера напрямую нельзя. В частности, 520 Вт в последней строке — потребление всего работающего сервера, а не отдельно измеренная мощность вентиляторов.
Для проектирования результат говорит о двух вещах. Во-первых, ИБП и цепь питания нужно проверять на запуск всех дисков, а не только на установившийся простой. Во-вторых, такой архив следует размещать в подходящем техническом помещении: 2U не означает тихую настольную систему. Даже условные постоянные 250 Вт за 8760 часов дали бы 2190 кВт·ч в год без учёта охлаждения. Это расчёт по выбранному режиму, не годовой замер автора.
Копирование файла объёмом 83 ГБ со скоростью около 1 ГБ/с относится к другому испытанию. Оно не показывает задержку мелких файлов, скорость после заполнения пула или поведение при восстановлении HDD. Эти нагрузки следует проверить отдельно на выбранной схеме ZFS. Замена HDD на SSD меняет предмет испытания, поэтому предполагаемые 5–6 ГБ/с для другой конфигурации нельзя приписывать этому 24-дисковому массиву.
Программа приёмки большого архива
- Проверить все HDD, серийные номера и отображение ошибок контроллером; сохранить состав оборудования.
- Согласовать топологию vdev, полезный бюджет, резерв и прогноз роста минимум на выбранный горизонт.
- Прогнать длительное чтение и запись с разными размерами файлов; записать режим кэша и сетевую конфигурацию.
- Проверить температурную карту всех 24 позиций в наиболее тяжёлом штатном режиме.
- Провести контролируемый сценарий отказа и восстановления на тестовых данных с безопасной процедурой замены.
- Восстановить выбранные папки из независимой копии и измерить время до первого пригодного к работе проекта.
- Проверить уведомления, возврат после перезагрузки и доступность инструкций другому администратору.
Как резервные диски меняют полезный объём
Вариант «два RAIDZ2 по 12 дисков» занимает все 24 основных отсека. Если требуются два установленных hot spare, их нельзя мысленно добавить к этой же конфигурации без дополнительных мест. Топологию приходится пересчитать либо держать запасные носители вне сервера с другим временем реакции.
Например, 22 активных HDD и два hot spare позволяют рассмотреть два vdev по 11 дисков с двойным паритетом. Номинальная ёмкость по упрощённой формуле составит 2 × (11 − 2) × 16 = 288 ТБ, а при резерве 20% плановая занятость — 230,4 ТБ до дополнительных расходов. Разница с двумя группами по 12 — 32 ТБ номинально и 25,6 ТБ в выбранном плановом бюджете.
Это реальная цена двух резервных позиций в рамках тех же 24 отсеков. Она может быть оправдана уменьшением времени до начала восстановления, но должна присутствовать в расчёте. Нельзя одновременно обещать максимальную ёмкость всех дисков и считать два из них свободным запасом.
Для критичного архива проверяют также доступность подходящего HDD после истечения первого года. Слишком маленький запасной диск может не подойти, даже если его номинальное название выглядит похожим. В спецификации фиксируют интерфейс, размер сектора и фактическую пригодность замены, а не только надпись «16 ТБ».
Какое RTO реально для всего массива
Предположим, нужно вернуть 256 ТБ за 48 часов. Только полезный поток должен составить 256 000 000 МБ / 172 800 с ≈ 1481 МБ/с. Это больше арифметической границы одной линии 10GbE в 1250 МБ/с ещё до протокольных расходов. Значит, такой RTO полного возврата не выполняется на одной десятигигабитной линии независимо от мощности CPU.
Для восстановления за 96 часов необходимый средний поток уменьшится примерно до 741 МБ/с, но реальная система должна обеспечить его на всём пути. Узел резервирования, носители, сеть и архивный сервер должны выдержать длительный режим, а обход каталогов и контроль содержимого отнимут дополнительное время.
Если ограничение жёсткое, выбирают несколько потоков по подходящему сетевому тракту, более быструю линию, готовую вторую копию для переключения либо поэтапное восстановление. Последний вариант часто реалистичнее: сначала активные проекты, затем исторические данные. Но пользователь должен заранее знать, какие материалы появятся в первую очередь.
Как контролировать целостность архива годами
Ценность архива раскрывается в день возврата старого проекта. Поэтому важно сохранить не только байты, но и структуру: названия, права, даты, связи между файлами и версии программ, которыми открываются результаты. Проверка контрольных сумм не выявит, что проект ссылается на отсутствующие внешние текстуры, если их никогда не включили в копию.
Для завершённых проектов полезен манифест содержимого и периодическая выборочная проверка открытия. Дисковая проверка ZFS и проверка прикладной полноты решают разные задачи. Первая обнаруживает определённые проблемы блоков, вторая показывает, пригоден ли комплект к использованию.
Scrub планируют с учётом размеров занятого пула и нагрузки. Он не заменяет резервное копирование и сам расходует дисковые ресурсы. Не стоит запускать тяжёлую проверку, полную копию и массовую выдачу старых проектов в одно и то же короткое окно без испытания совместного режима.
Если архив содержит уже сжатое видео и фотографии, не следует закладывать гарантированное двукратное сжатие. Расчёт ведут без неподтверждённого выигрыша, затем уточняют по реальной статистике. Ошибка в оптимистичном коэффициенте сжатия на сотнях терабайт превращается в необходимость срочной закупки.
Как перенести данные на новый архив
Первичная загрузка 100 ТБ и переключение действующего файлового сервиса — не одно действие. Во время первой передачи пользователи продолжают менять файлы. Поэтому нужны начальная копия, несколько инкрементальных проходов и короткое согласованное окно финального переключения.
До начала проверяют перенос ACL, имён и особенностей клиентов. Каталог, который корректно виден одному Linux-пользователю, может иначе работать с привычными Windows-группами и длинными путями. Тестовый проект с реальными правами помогает обнаружить проблему до массового копирования.
После первого прохода сверяют число файлов, объёмы и контрольные данные, затем выборочно открывают проекты. Старый источник сохраняют в согласованном состоянии на период проверки. Немедленная очистка исходной системы до подтверждения новой копии уничтожает самый удобный путь возврата.
Временное переключение имён ресурсов и адресов тоже планируют. Если часть клиентов использует старый путь, а часть новый, появляются расходящиеся версии. На время финальной синхронизации вводят понятный режим записи и сообщают команде, какой ресурс считается основным.
Что зафиксировать в спецификации архивного сервера
Кроме модели платформы указывают точный состав дисков, расположение по vdev, запасные позиции, RAM, контроллер, SIOM, кабели и комплект для стойки. Отдельно записывают полезную плановую занятость, а не только сырую сумму терабайт. Приёмка должна проверять именно согласованный состав.
Производительность описывают профилем: размер файлов, число клиентов, направление передачи и продолжительность. Требование «не менее нужного потока на данном рабочем наборе» проверяемо; «максимально быстрый сервер» — нет. Условия обслуживания включают доступ к накопителям, карту отсеков и ответственного за замену.
Наконец, в проекте должна быть независимая система резервирования с известным сроком возврата. Архивная платформа, подходящая по ёмкости, но не обеспеченная копией и регламентом, оставляет самую дорогую часть задачи нерешённой: что делать, когда данные понадобятся после общего отказа.
Частые вопросы о файловом архиве на 24 HDD
Получится ли 384 ТБ доступного места?
Нет, 384 ТБ — сумма номиналов 24 дисков. Из неё вычитаются избыточность, служебные расходы и свободный резерв. Для двух RAIDZ2 по 12 HDD предварительный бюджет — около 320 ТБ до накладных расходов и около 256 ТБ при выбранном резерве 20%.
Можно ли использовать этот сервер для монтажа прямо по сети?
Нужно проверить число потоков, битрейт, кодек, задержки и параллельную работу. Для последовательного чтения крупных файлов система может быть удобна; для монтажа с интенсивным случайным доступом понадобится иной рабочий слой. Результат одной передачи 83 ГБ не заменяет испытание проекта в монтажной программе.
Подойдёт ли один RAIDZ1 для ценных данных?
Решение нельзя принимать только по максимальной ёмкости. Для 24 больших HDD следует отдельно сравнить двойной и тройной паритет, более узкие группы и время возврата из копии. Исходный RAIDZ1 описывает эксперимент, но не задаёт обязательную топологию нового архива.
С чего начать подбор?
С текущей занятости, прироста, доли активных данных, окна копирования и RPO/RTO. Затем сравнивают серверы хранения Supermicro по полезной ёмкости и обслуживанию. Правильно подобранный архив должен не только вместить файлы, но и позволить вернуть их в согласованный срок.