Proxmox: проброс видеокарты — кейс Supermicro H11DSi
64 физических ядра, 128 потоков и одна видеокарта, которую нужно отдать отдельной виртуальной машине. С виду задача решается установкой Proxmox и нескольких ОС. На практике сначала приходится разобраться с ревизией материнской платы, локальностью памяти, слотами PCIe и возможностью повторно запустить GPU после остановки ВМ.
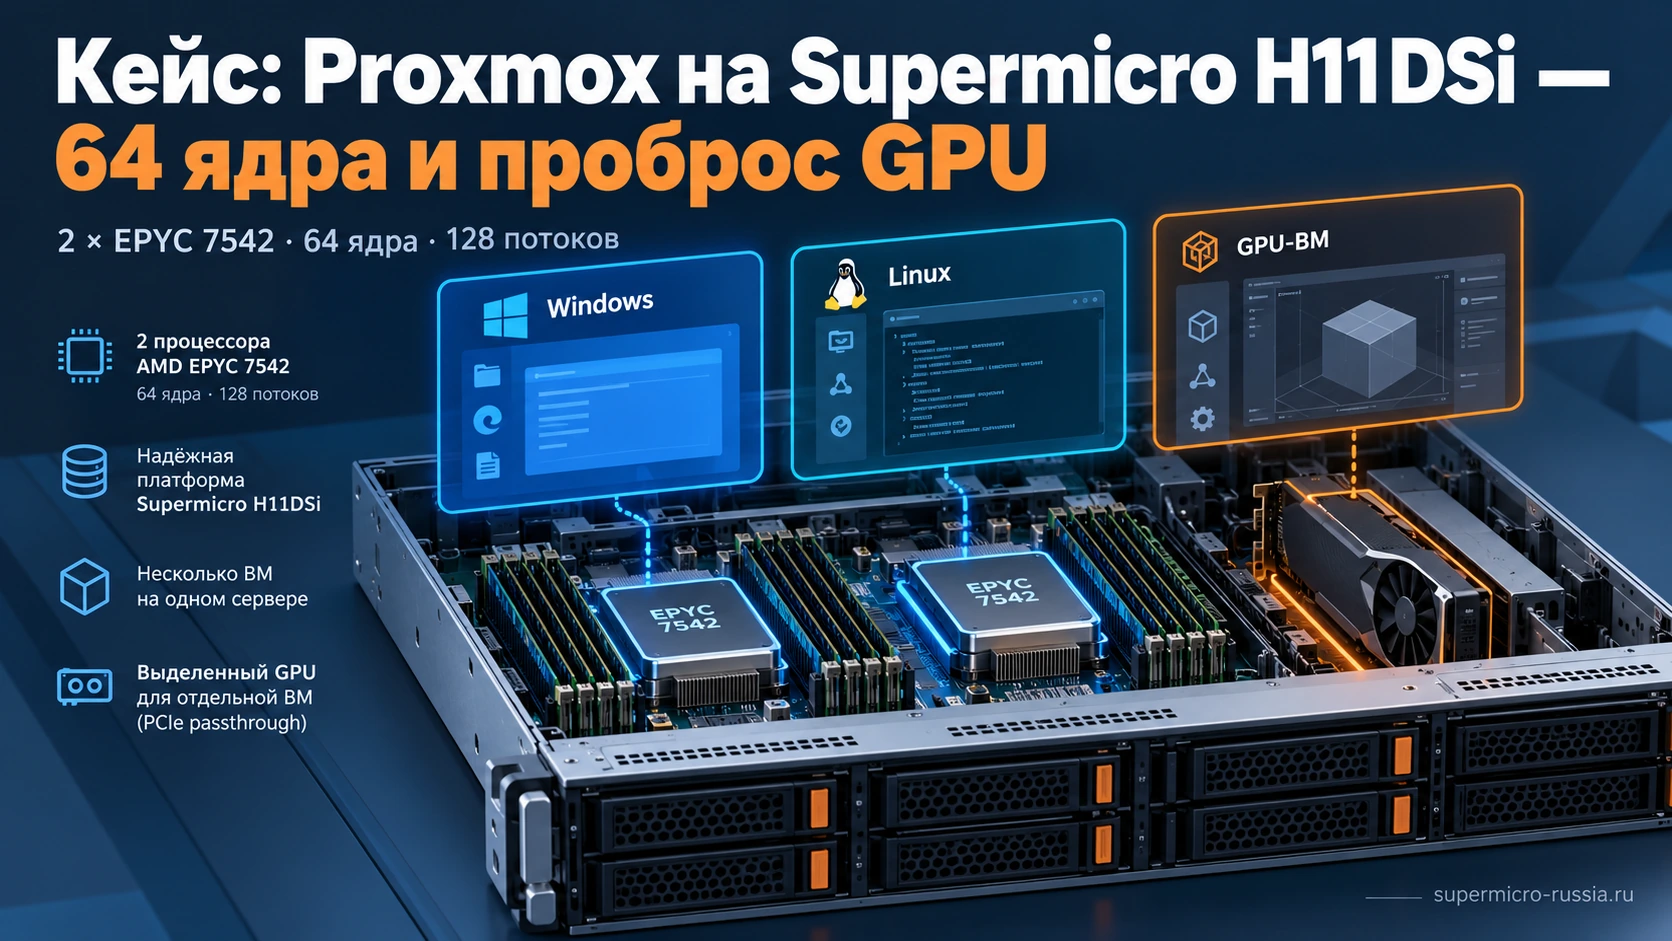
Основа этого инженерного кейса — реальная сборка Technically Unsure на Supermicro H11DSi с двумя AMD EPYC 7542. В ней использованы Proxmox, виртуальные машины Windows 10, Windows 11 и Ubuntu, а также проброс GPU. Разберём, почему такая архитектура полезна для испытательной лаборатории, какие ограничения у неё есть и как составить проверяемый план повторения. Распределение RAM, дисков и vCPU ниже — самостоятельный проектный пример, а не приписанные автору настройки.
Задача кейса: несколько рабочих сред вместо нескольких отдельных компьютеров
Инженерной команде могут одновременно понадобиться Linux для сборки ПО, Windows для прикладных тестов, отдельная среда с GPU и несколько небольших сервисов. Разносить всё по отдельным системным блокам удобно до первого серьёзного роста: начинают множиться блоки питания, системные SSD, кабели, резервные копии и ручные настройки.
Двухсокетный хост позволяет собрать эти среды в одном месте. Каждая получает собственную ОС, виртуальные диски, сеть и лимиты ресурсов. GPU можно передать одной ВМ для вычислений, рендера или испытания приложения. Смысл проекта — управляемая лаборатория с понятным распределением ресурсов, а не максимальное число пустых виртуальных машин на красивом скриншоте.
«Я покажу установку Proxmox, создание нескольких виртуальных машин — Windows 10, Windows 11, Ubuntu — и настройку проброса GPU», — так Technically Unsure формулирует замысел сборки. Перевод с английского.
Подтверждённый результат исходного проекта — сама работа с несколькими ОС и передача GPU гостевой системе. Число активных пользователей, гарантированная задержка приложений и запас под любую нагрузку этим не установлены. Эти параметры появляются только после прикладной приёмки, которую и нужно заложить в повторение.
Конфигурация H11DSi: что дают два EPYC 7542
| Компонент | Параметры | Значение для проекта |
|---|---|---|
| Материнская плата | Supermicro H11DSi, два сокета SP3 | Два CPU, раздельные банки RAM, несколько PCIe-устройств |
| Процессоры | 2 × AMD EPYC 7542, по 32 ядра / 64 потока | Суммарно 64 физических ядра и 128 логических потоков |
| Частоты CPU | 2,9 ГГц базовая; boost до 3,4 ГГц | Многопоточная ёмкость не равна высокой частоте каждого ядра под любой нагрузкой |
| Память | 16 DIMM, по 8 каналов на CPU | Нужно согласовать ёмкость и заполнение каналов обоих сокетов |
| Расширение | 2 × PCIe 3.0 x16 и 3 × PCIe 3.0 x8 | Проверяются линии, привязка к CPU, зазоры и IOMMU-группы |
| Сеть H11DSi | 2 × 1GbE, Intel I350 | Для тяжёлых копирований и удалённых рабочих данных может потребоваться отдельная NIC |
| Управление | BMC ASPEED AST2500, IPMI | Доступ к хосту сохраняется независимо от проброшенной дискретной GPU |
У каждого EPYC 7542 128 МБ L3 и паспортный TDP 225 Вт. Арифметически у пары 256 МБ L3, но это не один общий кэш с одинаковой задержкой для всех ядер. Суммарные 450 Вт TDP CPU тоже не являются измеренным потреблением сервера из розетки: отдельно учитываются GPU, память, накопители, вентиляторы и потери БП.
Материнская плата Supermicro H11DSi отличается от H11DSi-NT. У NT два порта 10GbE на Intel X550, а у базовой модели — два гигабитных. Покупка «почти такой же H11» без проверки суффикса меняет сетевой бюджет. В статье рассматривается именно H11DSi; дополнительные возможности NT не приписываются базовой плате.
Главная проверка до покупки: ревизия платы и поддержка EPYC 7002
Для EPYC 7002 на H11DSi требуется PCB revision 2.x. EPYC 7542 относится именно к этому поколению. Одного совпадения сокета SP3 недостаточно. Поддержка семейства CPU, физическая ревизия платы и подходящий BIOS должны совпасть одновременно.
Перед оплатой комплекта запрашивают фотографию маркировки ревизии на PCB, точный артикул CPU и подтверждение запуска этой пары. Скриншот объявления с общим названием платы не заменяет фото экземпляра. Для уже собранной системы полезны снимок BIOS с идентификацией CPU, список памяти и результаты базового теста. Серийные номера можно хранить в приёмочных документах, а не публиковать.
H11DSi нельзя автоматически расширять до поддержки EPYC 7003 только потому, что у поколения тоже встречается SP3. Также EPYC с суффиксом P предназначены для односокетных систем: два таких CPU не становятся заменой пары 7542. Совместимость процессоров AMD EPYC проверяют по точной модели и выбранной плате.
Ещё одна ловушка — ожидание PCIe 4.0. Сам EPYC 7002 поддерживает это поколение интерфейса, но рассматриваемая H11DSi предоставляет PCIe 3.0. Контроллер CPU не меняет разводку и сертификацию платы. GPU или NVMe нового поколения будут ограничены реально согласованной скоростью линка.
NUMA: почему 64 ядра нельзя считать одним одинаковым ресурсом
У двух CPU собственные контроллеры RAM и связанные с ними устройства. Виртуальная машина может исполняться на ядрах одного сокета, обращаться к памяти другого и использовать GPU, подключённую к первому. Такая схема способна работать, но межсокетный обмен добавляет задержки и трафик. Для вычислительной ВМ важно согласовать её CPU, память и PCIe-устройство.
При этом два сокета не всегда означают ровно два NUMA-узла. Настройка NPS и конфигурация прошивки меняют представление топологии EPYC. Реальную картину получают через lscpu, numactl --hardware и sysfs, а не рисуют по числу кулеров. Номера логических CPU тоже нельзя угадывать: соседние номера не обязаны быть разными физическими ядрами.
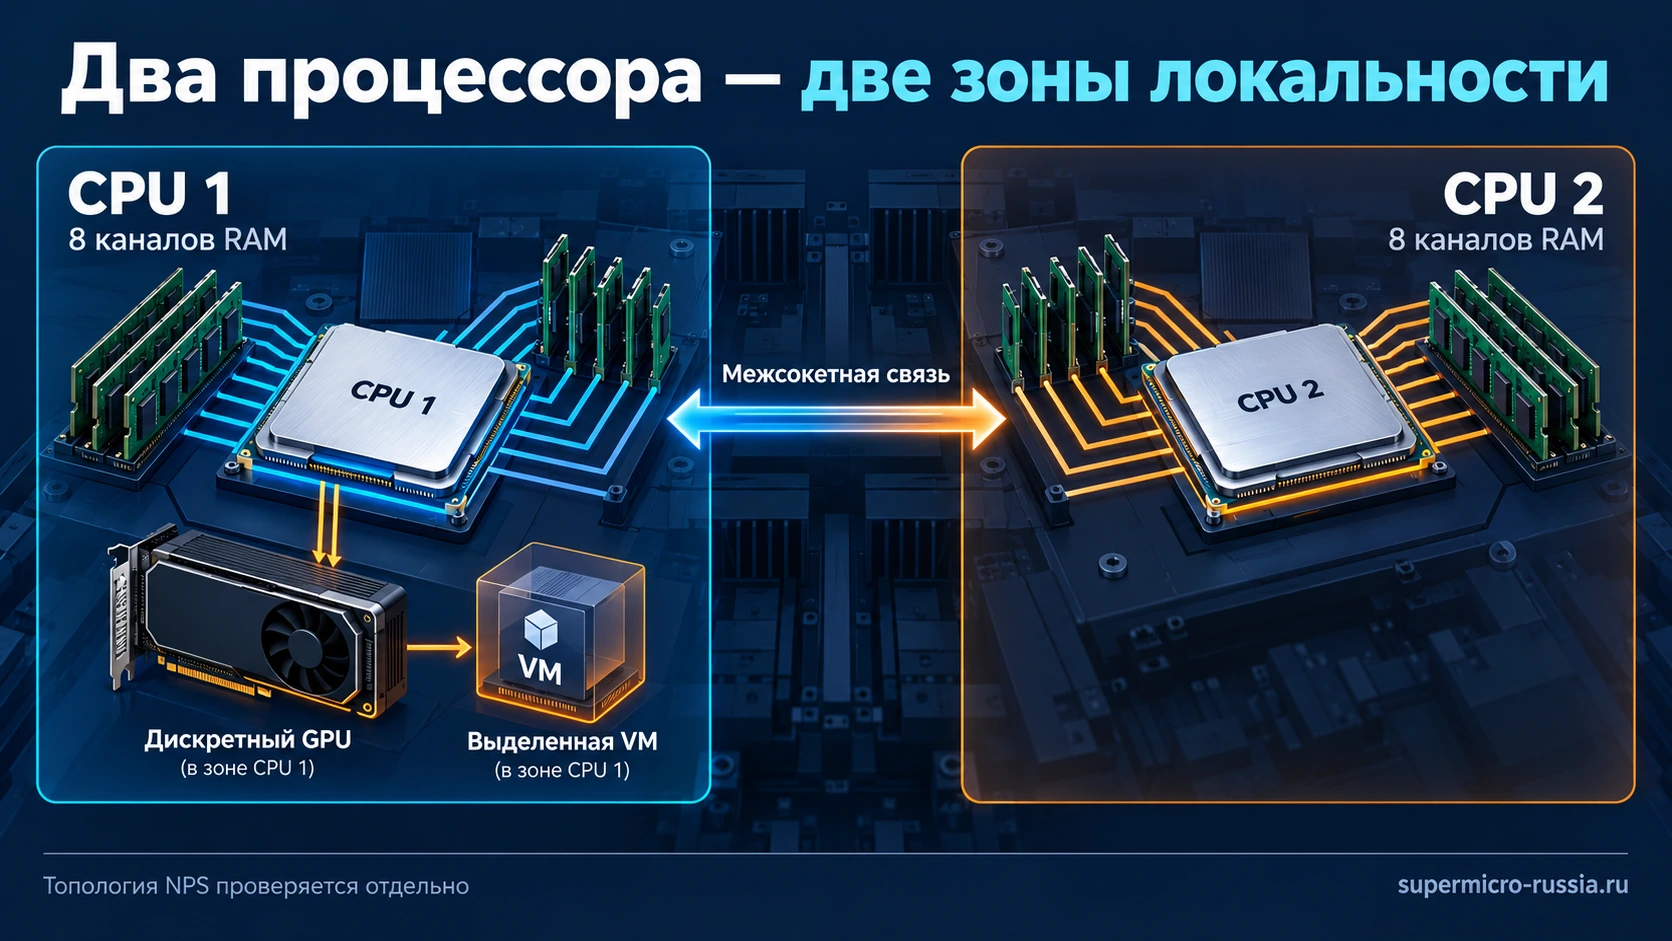
Для одной GPU-ВМ отправная точка — ядра и память в зоне CPU, к которому относится выбранный слот. Для тяжёлой Linux-сборки можно использовать другой сокет. Затем измеряют время реальной задачи и задержки при совместной работе. Эта рекомендация задаёт эксперимент, а не обещает, что любая ВМ всегда должна занимать ровно один узел.
Виртуальная NUMA-топология сообщает гостевой ОС структуру доступной памяти. CPU affinity ограничивает набор ядер, на которых могут исполняться потоки. Это разные механизмы: галочка NUMA сама по себе не закрепляет все vCPU на нужных физических ядрах и не обеспечивает исключительное владение ими. Для гарантированной изоляции нужно согласовать настройки размещения и использование тех же ядер остальными ВМ.
Как подобрать RAM: ёмкость, восемь каналов и резерв хоста
У пары EPYC 7542 шестнадцать каналов памяти, по восемь на CPU. Для расчётного проекта на 256 ГБ можно рассмотреть 16 одинаковых совместимых RDIMM по 16 ГБ: восемь модулей возле каждого процессора. Для 512 ГБ — 16 × 32 ГБ. Это варианты планирования; фактический объём исходной сборки здесь не установлен.
При одинаковой частоте один модуль в канале не создаёт пропускную способность восьми каналов. Теоретический предел одного EPYC с восемью каналами DDR4-3200 составляет 3200 × 8 × 8 = 204 800 МБ/с, или 204,8 ГБ/с. Для двух CPU номинально получается 409,6 ГБ/с. Приложение не обязано достигать этой суммы, особенно при неудачном размещении потоков или частых удалённых обращениях.
Частоту определяют CPU, модули, поддерживаемая конфигурация и настройки BIOS. Покупка более быстрых DIMM без проверки не гарантирует их работу на максимальном номинале. Для подбора используют список совместимых артикулов и схему заполнения. Смешивание случайных модулей ради общей суммы гигабайт усложняет диагностику и может ухудшить режим работы.
Пример бюджета памяти и vCPU для пяти сред
Предположим, после проверки хост располагает примерно 256 ГиБ для планирования; точное значение смотрят в ОС. Оставим 32 ГиБ под гипервизор, кэши и служебные нужды, ещё 16 ГиБ — нераспределённым резервом. Остальные 208 ГиБ можно заложить в пять гостевых систем. Это исходная модель распределения, не результат нагрузочного испытания.
| Среда | vCPU | RAM | Приоритет размещения |
|---|---|---|---|
| Windows или Linux с GPU | 16 | 64 ГиБ | Локальная зона сокета с видеокартой |
| Linux для сборки/вычислений | 16 | 64 ГиБ | Другой сокет, если это подтверждается тестом |
| Windows для прикладных испытаний | 8 | 32 ГиБ | По свободному бюджету памяти и профилю нагрузки |
| Linux для разработки | 8 | 32 ГиБ | Отдельно от основной тяжёлой ВМ при необходимости |
| Служебные сервисы | 4 | 16 ГиБ | Без конкуренции с критичным процессом |
| Сумма гостевых лимитов | 52 | 208 ГиБ | 32 ГиБ хосту + 16 ГиБ резерва = 256 ГиБ |
52 vCPU меньше 64 физических ядер, но это не означает автоматическое резервирование 52 ядер и гарантированные «12 свободных». Планировщик работает с логическими CPU, хосту тоже нужны вычисления, SMT-потоки делят ресурсы ядра. Если нагрузки чувствительны к задержкам, отдельно проектируют affinity и исключение конкурентов, а затем проверяют фактическое исполнение.
Число ВМ в этом примере выбрано по полезным ролям. Из той же RAM можно сделать больше лёгких машин или две очень большие, но это будет другая задача. Общая методика вынесена в материал о расчёте CPU и RAM для виртуальных машин; здесь важны конкретные ограничения двухсокетной H11DSi с выделенной GPU.
Проброс видеокарты в Proxmox: что получает ВМ
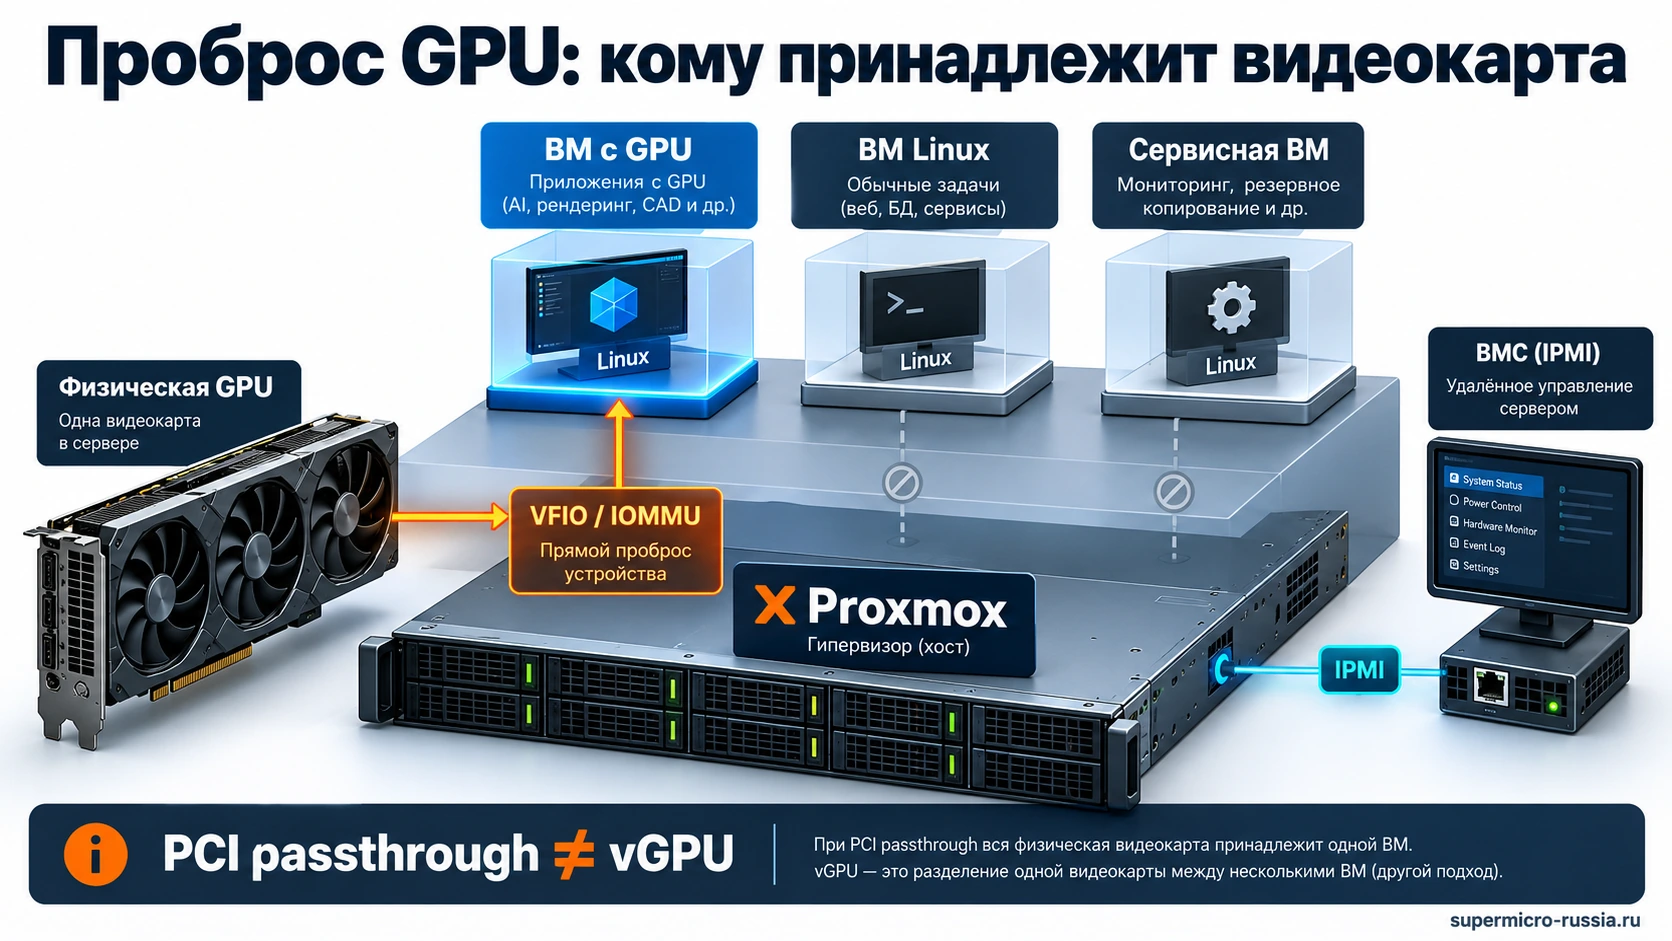
При обычном PCI passthrough физический GPU передаётся одной гостевой системе. Она использует драйвер устройства и выполняет собственные вычисления. Хост и другая ВМ не получают этот же GPU одновременно. Это отличается от vGPU, где разделение ускорителя требует отдельной технологии, совместимого оборудования, драйверов и, в соответствующих продуктах, лицензирования.
Поэтому в этом кейсе первая GPU-ВМ может быть Windows для испытаний графического приложения или Linux для вычислений. Ещё одна Linux-ВМ без проброшенной карты продолжит работать на CPU. Наличие одной видеокарты не означает несколько независимых GPU-рабочих мест для всех созданных ОС.
Что нужно проверить до настройки VFIO
Для AMD-платформы нужны аппаратная виртуализация SVM и работающая IOMMU/AMD-Vi с переназначением прерываний. Название переключателя и его расположение зависят от BIOS. После загрузки проверяют результат в журнале ядра, а не ограничиваются положением пункта меню. Затем определяют PCI-адрес GPU, её дополнительные функции и состав IOMMU-группы.
В одной группе могут находиться GPU и её HDMI-аудиофункция. Но если туда же попал нужный хосту контроллер дисков или сетевой интерфейс, нельзя бездумно передать всю группу гостю. Сначала проверяют другой слот и корректную конфигурацию. ACS override не стоит использовать как стандартный способ «исправить» изоляцию: изменение видимых групп само по себе не создаёт отсутствующую аппаратную границу.
Карта должна поддерживать нужный драйвер в гостевой ОС и корректно освобождаться после остановки ВМ. Успешный первый запуск — только половина проверки. Некоторые проблемы проявляются при повторном назначении устройства, перезапуске драйвера или после обновления ядра. До физической сборки необходимо согласовать GPU, БП, корпус, разъёмы и способ обслуживания.
Последовательность подготовки: от первого старта до рабочей GPU-ВМ
- Проверить комплект до установки в корпус. Сопоставить маркировку ревизии, CPU, память, кулеры и питание; осмотреть сокеты и разъёмы. Монтаж SP3 выполняется штатным механизмом и с указанным для него моментом затяжки.
- Выполнить минимальный запуск. Убедиться, что определяются оба CPU и ожидаемые модули памяти. Дождаться завершения POST и обучения RAM; длительность первого старта не следует оценивать по привычке к настольной плате.
- Зафиксировать BIOS/BMC и настройки. Не прошивать «на всякий случай» неподходящий пакет. Если обновление необходимо, предварительно проверить модель, ревизию, порядок действий и восстановление.
- Проверить железо без сложной виртуализации. Испытать RAM, CPU, сеть и накопители, посмотреть датчики и журнал BMC. Иначе ошибка памяти может выглядеть как проблема Proxmox.
- Установить поддерживаемую версию Proxmox. Записать версии ядра и пакетов. Сначала создать обычную ВМ, проверить сеть, диски и выключение, затем добавлять passthrough.
- Подготовить IOMMU и VFIO. Проверить группы и привязку нужных функций GPU. Способ применения загрузочных параметров выбирается по фактическому загрузчику хоста.
- Подготовить гостевую систему. Для современного PCIe-сценария обычно используют q35 и OVMF; выбор согласуют с GPU и ОС. Устанавливают драйверы диска, сети и самой видеокарты.
- Испытать повторные циклы. Корректное выключение гостя, остановка/запуск, перезагрузка ВМ, холодный запуск хоста и восстановление после штатного отключения питания проверяются отдельно.
Универсальный блок команд для редактирования GRUB здесь был бы плохой инструкцией: на разных установках загрузчик и способ управления его параметрами различаются. До правок полезно снять текущую конфигурацию и проверить консоль через IPMI. Общее руководство по совместимости Supermicro с гипервизорами помогает отделить выбор поддерживаемых устройств от настройки одного конкретного стенда.
Команды для чтения исходного состояния
pveversion -v

lscpu

numactl --hardware

lspci -nnk

lspci -tv

journalctl -k -b
Это команды диагностики, они не включают проброс автоматически и не меняют конфигурацию. Вывод numactl доступен после установки соответствующего пакета. Для выбранного PCI-устройства дополнительно проверяют путь /sys/bus/pci/devices/0000:BB:DD.F/numa_node, где адрес заменяют фактическим. Значение -1 означает, что ядро не сообщает принадлежность к NUMA-узлу, а не «устройство подключено ко всем CPU».
Как проверить, что проброс GPU переживает полный цикл эксплуатации
У двухсокетной H11DSi работоспособность гостевой системы стоит проверять в нескольких состояниях. ВМ, один раз показавшая рабочий стол, ещё не проверена после остановки, повторного запуска и восстановления из копии. Это особенно заметно, когда драйвер гостя должен заново инициализировать карту, а адрес устройства в настройках ВМ остался от прежней раскладки PCIe.
| Проверка | Что зафиксировать | Критерий результата |
|---|---|---|
| Холодный запуск хоста | Состав RAM, топология NUMA, IOMMU-группа и драйвер GPU на хосте | Загружается прежняя конфигурация, устройство получает нужный драйвер |
| Повторный запуск GPU-ВМ | Состояние карты после штатного завершения гостевой ОС | Приложение снова использует GPU без перезагрузки всего сервера |
| Совместная работа Windows и Linux | Память хоста, задержки дисков и размещение памяти ВМ | Фоновая нагрузка не делает основную среду непригодной для работы |
| Восстановление копии ВМ | Конфигурация гостя, дополнительные устройства и права доступа | Восстановлены приложение и его данные, а не только загрузочный диск |
Это программа испытаний для повторения архитектуры, а не дополнительные замеры автора. Перед ней сохраняют вывод lspci -nnk и конфигурацию ВМ; после неё сравнивают состав устройств. Перестановка GPU в другой слот требует заново проверить привязку к CPU и группу IOMMU. Резервная копия виртуального диска также не переносит физическую видеокарту на другой хост автоматически: принимающему серверу нужна подходящая аппаратная конфигурация.
Windows 11, Linux и CPU type: нюансы, которые лучше решить заранее
Для Windows 11 проверяются поддерживаемый CPU, UEFI, TPM 2.0 и требования Secure Boot. В виртуальной машине могут потребоваться OVMF, EFI-диск, виртуальное TPM-состояние и корректные ключи загрузки. Поддержку проверяют для выбранной версии Windows 11 заново: работа одной редакции в сборке 2025 года не доказывает поддержку всех последующих выпусков. Установка после обхода проверок не является доказательством официально поддерживаемой конфигурации.
Windows 10 присутствует в исторической исходной сборке. Для нового корпоративного проекта нельзя автоматически повторять её как долгосрочную ОС: основной срок поддержки обычных редакций завершился, а дальнейший режим зависит от конкретной редакции и программы обновлений. Выбирают поддерживаемую гостевую ОС и отдельно проверяют лицензионные права, особенно для удалённой работы.
Для Linux и вычислительных приложений важен CPU type ВМ. Режим host открывает гостю возможности текущего CPU, но влияет на переносимость между разными хостами. Унифицированная виртуальная модель CPU помогает совместимости, одновременно ограничивая набор доступных инструкций. Выбор делают исходя из того, будет ли машина оставаться на этом сервере или понадобится перенос на другое железо.
Гостевые системы получают свои сетевые настройки и политики доступа. Нельзя считать, что сама виртуализация отделила испытательный Windows от всех рабочих ресурсов: виртуальный мост может соединять их с одной сетью. Для лаборатории заранее определяют отдельные сегменты или VLAN и доступ администраторов, а BMC выводят в управляемую сеть администрирования.
Хранилище и сеть: где 64-ядерный сервер легко упирается в ожидание
Если несколько ВМ одновременно устанавливают обновления, компилируют проект и записывают временные файлы, важны задержка записи и смешанная нагрузка SSD. Большая линейная скорость одного пустого накопителя не описывает такой сценарий. Для повторения закладывают системные диски, рабочее хранилище ВМ и отдельное место резервных копий; выбор конкретной схемы зависит от допустимого простоя и бюджета.
H11DSi ограничивает расширение PCIe 3.0, а M.2-разъём имеет до двух линий этого поколения. Поэтому дорогой SSD PCIe 4.0 x4 в этом разъёме не реализует свой паспортный интерфейс. Для адаптеров в полноразмерных слотах отдельно проверяют электрическую ширину и поддержку нужной схемы; наличие длинного разъёма не гарантирует требуемое разбиение линий.
У базовой H11DSi гигабитная сеть. Идеальный предел 1 Гбит/с равен 125 МБ/с до накладных расходов. Передача 1 ТБ десятичных данных при таком пределе заняла бы около 2 часов 13 минут; на 10GbE идеальное время — около 13 минут 20 секунд. В реальности обе передачи дольше, а результат ограничивают диски, протокол и другие задачи. Это объясняет, почему быстрые бэкапы иногда требуют NIC раньше, чем ещё одного CPU.
Два гигабитных порта не дают автоматически 2 Гбит/с одному копированию. Агрегация может распределять разные потоки, но её поведение зависит от протокола и настройки коммутатора. Для большого единичного потока нужна проверенная схема, а не арифметическое сложение цифр на задней панели.
Корпус, питание и эксплуатация двухсокетной H11DSi
Размер платы — примерно 305 × 331 мм, E-ATX. Перед выбором корпуса 3U, 4U или Tower проверяют не только заявленную поддержку E-ATX, но и точки крепления, глубину, два кулера, длину GPU и кабельные зазоры. Видеокарта на три слота физически перекроет часть соседних разъёмов.
Расчёт охлаждения должен включать два CPU с TDP 225 Вт, DIMM, VRM и выбранную GPU. В сервере с направленным воздушным потоком пассивный радиатор может быть нормальным решением; в свободном Tower без соответствующего обдува — уже нет. Увеличение мощности вентилятора не заменяет правильно организованный маршрут воздуха через горячие зоны.
Мощность БП проверяют вместе с наличием нужных CPU/GPU-кабелей и допустимым током по линиям. Резервированный БП полезен лишь при подходящей схеме питания и достаточной мощности одного модуля для предусмотренного режима отказа. Он не устраняет общий отказ платы, памяти или самого гипервизора.
Для эксплуатации сохраняют карту DIMM и PCIe-слотов, версии прошивок, состав ВМ, адреса устройств и порядок запуска. IPMI нужен не только для первого включения: через него можно увидеть POST, датчики и аппаратные события, когда гостевая система с GPU уже недоступна.
Как принять такую конфигурацию: недостаточно увидеть рабочий стол
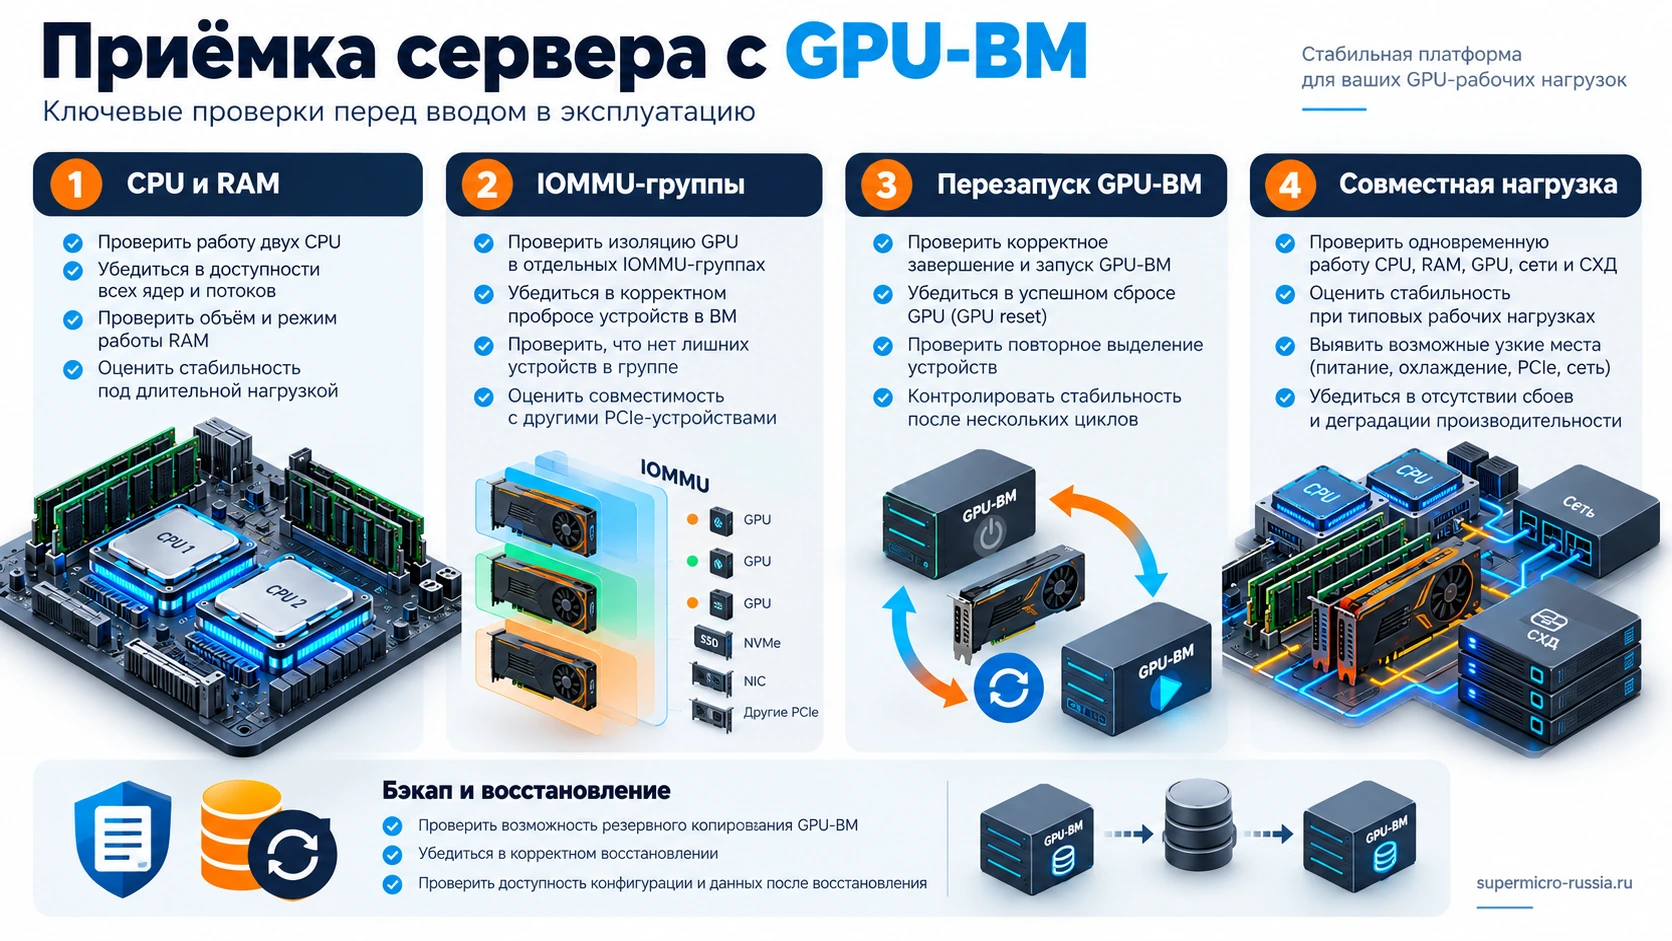
| Этап | Проверяемое условие | Что фиксировать |
|---|---|---|
| Аппаратная база | Оба CPU и вся RAM определяются, ошибок памяти нет | Ревизия PCB, BIOS/BMC, карта DIMM, журнал событий |
| Обычная ВМ | Сеть, диск, выключение и перезагрузка работают без GPU | Версии гостя, драйверов и конфигурация виртуального оборудования |
| GPU-ВМ | Карта и связанные функции принадлежат нужному гостю | PCI-адреса, IOMMU-группа, драйвер, тестовая задача |
| Повторные циклы | Например, 10 последовательных остановок и запусков без сбоя | События сброса GPU, ошибки ядра и гостя; это выбранный тест, не гарантия ресурса |
| Совместная нагрузка | GPU-задача, CPU-сборка и запись на диски работают одновременно | Время задач, задержки, температуры и частоты |
| Восстановление | Бэкап разворачивается, приложения и данные доступны | Время восстановления и необходимость повторной привязки PCI-устройств |
Продолжительность стресс-теста выбирают под риск проекта. Разумный практический сценарий — отдельно проверить память, затем несколько часов совместной нагрузки и реальную последовательность действий пользователя. Но ни час, ни сутки без ошибки не доказывают бесконечную надёжность. Приёмочные условия должны быть заранее понятны обеим сторонам и содержать проверяемые задачи.
Для оценки конкуренции полезен простой эксперимент: измерить длительность одной и той же GPU-задачи отдельно, затем вместе с CPU-сборкой и резервным копированием. Если время выросло, например, с условных 10 до 16 минут, нужно искать конкретный ресурс: память, диск, сеть, локальность или ограничение мощности. Эти числа — пример методики, а не результаты исходной сборки.
Что такая лаборатория не решает автоматически
Это не отказоустойчивый кластер. Все гостевые системы зависят от одной платы и одного физического хоста. Сбой хоста остановит их одновременно. Если бизнесу нужен перенос при отказе и ограниченный простой, проектируют несколько узлов, хранение, резервирование и проверку восстановления отдельно.
Бэкап ВМ не сохраняет состояние физической GPU как обычного виртуального устройства. После восстановления должны совпасть доступное оборудование, привязка и драйверы. Возможность миграции и сохранения состояния с passthrough зависит от конкретного стека; её нельзя обещать для произвольной карты. Для этого кейса разумно рассчитывать на остановку, перенос данных и повторный запуск на подготовленном совместимом хосте.
64 ядра не заменяют высокую производительность одного потока. Сервер хорошо подходит для нескольких параллельных задач, но программа с узким последовательным участком может выиграть от более нового быстрого CPU. И 128 логических потоков не являются 128 независимыми физическими ядрами.
Одна GPU не превращается в несколько полноценных ускорителей. Если разным командам одновременно нужен прямой доступ к картам, закладывают дополнительные GPU, проверяют физическое размещение и питание либо выбирают отдельную поддерживаемую архитектуру виртуализации ускорителей.
Вопросы по кейсу H11DSi и Proxmox
Подойдёт ли любая H11DSi для пары EPYC 7542?
Нет. Требуются ревизия 2.x, подходящий BIOS, совместимая память и охлаждение. Артикул без фотографии ревизии не закрывает проверку. Также нужно убедиться, что приобретён именно базовый или NT-вариант с ожидаемыми интерфейсами.
Можно ли повторить проект с меньшим объёмом RAM?
Да, если сумма реальных рабочих наборов, резерва хоста и запаса помещается в выбранную ёмкость. Однако сокращение числа модулей может оставить часть каналов незаполненными. Нужно сравнивать не только объём, но и скорость прикладной задачи в новой раскладке.
Почему GPU работает после включения хоста, но не после перезапуска ВМ?
Возможна проблема сброса устройства, драйвера или освобождения функций GPU. Проверяют журнал хоста, состояние устройства, состав группы и версии ПО. Нельзя считать регулярную перезагрузку всего сервера нормальным доказательством корректного passthrough.
Можно ли использовать встроенную графику BMC для доступа к хосту?
Да, BMC обслуживает управление и консоль физической системы. Он не заменяет вычислительную дискретную GPU, зато помогает не потерять доступ к хосту после её передачи гостю. Работу консоли проверяют до назначения PCI-устройств.
Инженерный результат кейса и следующий шаг
Связка H11DSi и двух EPYC 7542 даёт основу для лаборатории с несколькими Windows/Linux-средами и отдельной GPU-ВМ. Её сильные стороны — 64 физических ядра, шестнадцать каналов RAM и развитое расширение. Ограничения столь же конкретны: ревизия платы для 7002, PCIe 3.0, гигабитная сеть базовой модели, NUMA и зависимость всех ВМ от одного хоста.
Для повторения составьте список приложений, рабочие наборы памяти, число одновременно активных сред, модель GPU и допустимый простой. Затем согласуйте плату, серверную память, корпус, накопители и программу приёмки. Эти данные можно отправить для подготовки комплектации: в этом проекте проверенный состав и порядок испытаний полезнее, чем обещание любого числа ВМ по одной цифре «128 потоков».