Сколько виртуальных машин выдержит сервер Supermicro и как рассчитать CPU и RAM до покупки?
Число виртуальных машин, которое выдержит сервер Supermicro, определяется их одновременной рабочей нагрузкой, доступной памятью и допустимым временем отклика. Один и тот же хост может подходить для нескольких тяжёлых ВМ или десятков небольших сервисов. Из количества ядер и установленных гигабайт нельзя получить единственную достоверную цифру без профиля нагрузки.
Для предварительной оценки рассчитывают два ограничения: по процессорной мощности и по RAM. Для одинаковых ВМ выбирают меньшее число. Для разных ВМ складывают потребность каждого профиля, а затем проверяют размещение крупных машин и работу после отказа узла. Хранилище, сеть и ограничения программной платформы должны пройти отдельную проверку: даже правильный расчёт CPU и RAM не устраняет их узкие места.
Сколько виртуальных машин поместится на один сервер?
Полезно различать три числа: сколько машин можно создать, сколько можно включить и сколько смогут одновременно выполнять нужную работу. Первое определяется в том числе лимитами управления и объёмом хранилища. Второе зависит от ресурсов запуска. Третье — от производительности приложений под нагрузкой. Покупателю нужен именно третий показатель.
Например, 20 ВМ по 4 vCPU и 8 ГиБ RAM — это 80 назначенных vCPU и 160 ГиБ гостевой памяти. Однако процессорная потребность будет разной, если в этих машинах находятся редко используемые внутренние сервисы, постоянно занятые обработчики данных или пользовательские рабочие места. Одинаковые настройки ВМ не означают одинакового потребления.
Практический критерий вместимости: все обязательные сервисы выполняют согласованные операции с допустимой задержкой, при этом хост и гости не испытывают устойчивого дефицита CPU и памяти. Если интерфейс открывается, но отчёт строится втрое дольше нормы, такую ВМ нельзя считать успешно размещённой.
Почему опыт с сотнями ВМ не даёт готовую норму для бизнеса?
В эксперименте «250 Virtual Machines on a Proxmox Mini PC» канала VirtualizationHowto использовалось 96 ГБ DDR5. На момент проверки 9 октября 2026 года ролик набрал более 92 тысяч просмотров. В сопровождающем разборе автор Brandon Lee описывает одинаковые Ubuntu-ВМ с 2 vCPU и 2 ГБ RAM, работу механизмов экономии памяти и отдельные нагрузочные задания.
Lee уточняет характер нагрузки: Я запускал обновления на нескольких машинах одновременно
— перевод короткого фрагмента его пояснения. Большинство гостей в опыте не выполняло значительной работы; автор отдельно оговаривает отсутствие строгой измерительной методики. Поэтому 250 включённых гостей нельзя приравнять к 250 одновременно нагруженным базам данных. Полезный вывод из этого опыта — проверять фактическую активность, а не переносить число машин из заголовка ролика в коммерческое предложение.
Какие данные собрать перед расчётом сервера для виртуализации?
Начните с реестра ВМ. Для каждой запишите роль, число vCPU, объём RAM, характер нагрузки, расписание тяжёлых задач и требования к доступности. Отдельно пометьте машины, которые допустимо остановить при аварии: тестовый стенд и производственная база не обязаны иметь одинаковый приоритет.
Для работающей инфраструктуры полезен период мониторинга в 2–4 недели, если в него попадают значимые пики. Это рекомендация по организации измерений, а не универсальное требование гипервизора. Если закрытие квартала бывает раз в три месяца, его придётся включить в модель отдельно. Низкая загрузка в тихую неделю не характеризует годовой максимум.
| Что фиксировать | Зачем это нужно | Какую ошибку предотвращает |
|---|---|---|
| vCPU, CPU usage и потребность в процессорном времени; задержки планировщика | Отделить назначенные ресурсы от реальной вычислительной работы | Покупку процессора по сумме vCPU или по одной средней загрузке |
| Назначенную RAM, активную память, committed memory, swap/paging | Увидеть рабочую потребность, кэши и признаки дефицита | Расчёт только по текущему RSS или проценту памяти хоста |
| Одновременную нагрузку с едиными временными метками | Проверить совместные пики ВМ | Сложение независимых максимумов как будто они происходят вместе |
| p95/p99 времени бизнес-операций и число запросов в секунду | Связать ресурсы с качеством обслуживания | Признание медленной, но включённой ВМ успешным результатом |
| Рост числа ВМ, пользователей и объёма обработки | Задать горизонт закупки | Запас «на всякий случай», который невозможно обосновать |
| Крупнейшую ВМ, правила разнесения, CPU pinning и устройства passthrough | Проверить допустимое размещение | Предположение, что любая сумма ресурсов свободно делится между узлами |
Снимайте CPU и RAM за одинаковые интервалы. Для предварительного профиля подходят минутные значения; короткие задержки и микропики требуют более частого наблюдения. Зафиксируйте длительность интервала в отчёте. Среднее за пять минут может скрыть десятисекундный период, в котором все пользователи одновременно ждут ответа.
Что делать, если сервер покупается для новой системы?
Заменить измерения уверенным коэффициентом переподписки нельзя. Используйте требования разработчика приложений, пилотный стенд и три сценария: ожидаемый, тяжёлый и аварийный. В каждом укажите число активных ВМ и их действия. Затем сравните конфигурации по тем же сценариям. До пилота результат остаётся проектной оценкой.
Не задавайте одной ВМ 16 vCPU только потому, что такой шаблон использовался раньше. Запишите, какая операция требует параллельного выполнения и как меняется её скорость при 2, 4 и 8 vCPU. Для RAM аналогично: каким объёмом данных пользуется приложение и что происходит, когда рабочий набор перестаёт помещаться в память?
Что значит vCPU и чем он отличается от физического ядра?
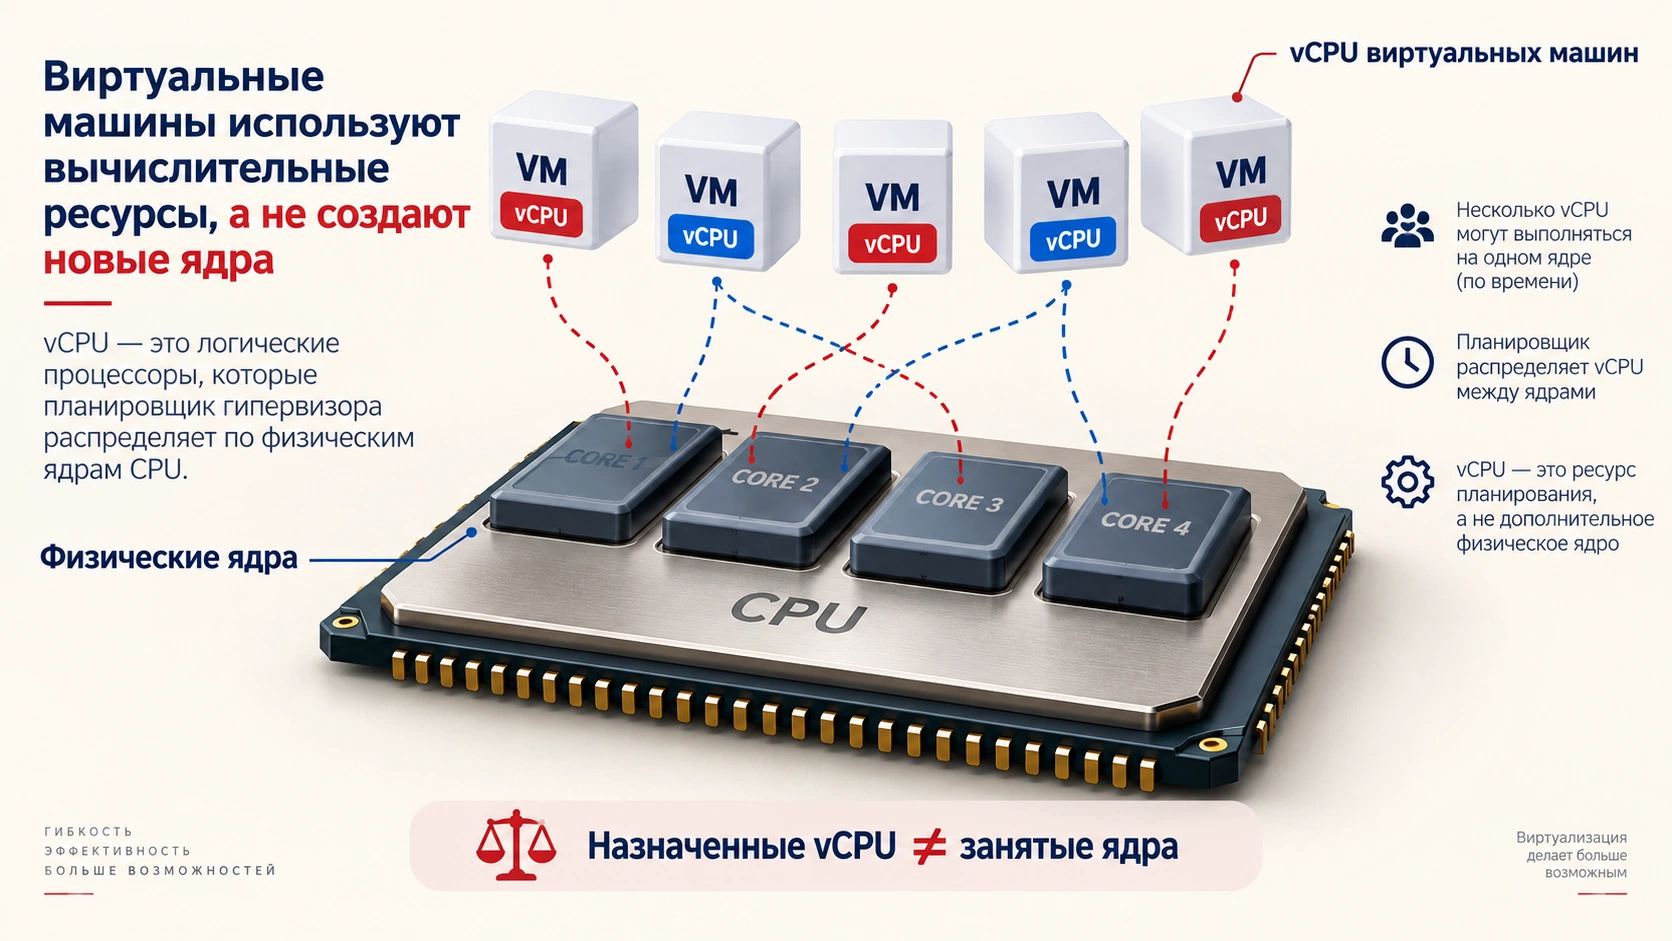
Физическое ядро — аппаратный вычислительный ресурс процессора. Логический процессор — контекст исполнения, который видит операционная система. При включённой двухпоточной SMT одно физическое ядро предоставляет два таких контекста; они разделяют часть аппаратных ресурсов. vCPU — виртуальный процессор гостевой машины, которому гипервизор предоставляет время исполнения на логических процессорах хоста.
Поэтому сервер с 32 физическими ядрами и 64 аппаратными потоками нельзя автоматически считать равным серверу с 64 физическими ядрами. Эффект SMT зависит от работы приложения. Для первичной консервативной оценки считайте физические ядра, а дополнительную производительность SMT подтверждайте испытанием.
Сколько vCPU можно выделить на одно физическое ядро?
Отношение суммы назначенных vCPU к числу физических ядер называют коэффициентом переподписки. Если 32-ядерному хосту назначено 96 vCPU, это 3:1. Число показывает плотность назначения, но не гарантирует приемлемую задержку. Три почти простаивающих vCPU и три постоянно занятых vCPU предъявляют разные требования.
В ролике ElectronicsWizardry об over-provisioning отдельно разбираются CPU и память. Его описание начинается словами: В этом видео я рассматриваю избыточное выделение ресурсов в Proxmox
. Это короткий фрагмент русской версии описания. Такой раздельный подход полезен и при покупке: успешная переподписка процессора сама по себе не подтверждает достаточность RAM.
Коэффициенты 2:1, 4:1 или 8:1 можно рассматривать как гипотезы для проверки конкретной среды. У полностью занятых обработчиков, требовательных БД и сервисов с жёсткой задержкой допустимая переподписка может быть существенно ниже, чем у лаборатории. Универсального безопасного отношения для всех серверов Supermicro нет.
Как рассчитать CPU по фактической нагрузке?
Сначала приведите потребление разных ВМ к сопоставимой единице. Удобная расчётная единица — производительность одного полностью занятого физического ядра выбранного CPU на характерной нагрузке. Обозначим потребность одной ВМ в таких единицах как D. Это не название стандартного счётчика: показатель получают из измерений и калибровки.
В учебной модели без вклада SMT и при сопоставимой производительности ядер можно принять D = vCPU × доля загрузки. Для ВМ с 4 vCPU при нагрузке 20% получится 0,8 условного физического ядра. На реальном стенде нельзя слепо подставить любой процент из панели: сначала выясните, относительно чего он рассчитан. 100% одного vCPU и 100% всей ВМ — разные значения. При SMT время логического процессора также не превращается в производительность полного физического ядра автоматически.
Доступный бюджет гостям в простой модели: BCPU = (C − H) × U, где C — физические ядра, H — расчётная потребность хоста, U — выбранная доля загрузки оставшейся мощности. Тогда для одинаковых ВМ NCPU = floor(BCPU / D). floor означает округление вниз. H здесь — статья бюджета, а не обязательное закрепление ядер за гипервизором.
Значение U задаётся проектом. Например, 0,70 оставляет часть мощности для отклонений от модели и пиков. Это принятое условие расчётного примера, а не установленная производителем норма. Чем дороже задержка операции и чем хуже изучены пики, тем осторожнее следует выбирать целевую загрузку.
Почему нельзя просто сложить p95 всех виртуальных машин?
p95 — значение, ниже которого находится 95% наблюдений за выбранный период. Сумма отдельных p95 не равна p95 общей нагрузки. Если один сервис активен утром, другой вечером, механическое сложение завысит потребность. Если все начинают обработку по одному расписанию, эффект несовпадения пиков исчезнет.
Правильнее сначала сложить потребление ВМ в каждый момент времени, а затем вычислить p95/p99 суммарного ряда. При недостатке данных сумма индивидуальных проектных пиков может служить осторожной верхней оценкой. Но её следует так и назвать. Уменьшать сумму произвольным «коэффициентом неодновременности» без расписаний и измерений рискованно.
Сам p95 не заменяет аварийный сценарий. Пять процентов времени могут включать самые важные часы работы. Отдельно проверяют закрытие периода, массовый вход пользователей, загрузку после обслуживания, обновления и резервное копирование.
Как пересчитать нагрузку при переходе на другой процессор?
Количество ядер и тактовая частота не дают готового коэффициента ускорения. Сравнивайте характерную операцию при одинаковых данных, версиях ПО и настройках. Для одних ВМ важнее скорость одного потока, для других — суммарный throughput или пропускная способность памяти.
Предположим, тест показал: на целевой платформе одно ядро выполняет вашу работу в 1,25 раза быстрее эталонного. Для той же обработки оценку 20 эталонных ядер можно предварительно пересчитать как 20 / 1,25 = 16 целевых. Такой коэффициент нельзя получить делением GHz и распространить на все приложения. Если профили разные, коэффициент оценивают по каждому значимому профилю.
Сколько памяти выделить виртуальным машинам и оставить хосту?
Для предсказуемой производственной работы разумная отправная модель — физическая RAM покрывает согласованную потребность гостей, накладные расходы платформы и рост. В отличие от назначенных vCPU память нельзя превратить в дополнительную физическую ёмкость переключением планировщика.
Бюджет гостям: BRAM = RAMфиз − RAMхост − RAMнакладные − RAMрост. Если накладные расходы уже включены в измеренный расход хоста, второй раз их не вычитают. Если они зависят от числа и размера ВМ, их нужно пересчитать для итоговой плотности, а не оставить от почти пустого стенда.
Для одинаковых машин NRAM = floor(BRAM / M), где M — согласованный объём памяти одной ВМ. Для разных гостей складывают их M. Это может быть фиксированное выделение либо подтверждённый нагрузочным тестом бюджет при динамической памяти. Минимум из настроек ballooning не равен рабочей потребности приложения.
Какие показатели памяти смотреть?
Назначенная память показывает конфигурацию, активная — используемый рабочий набор по методике конкретного счётчика, committed — обязательства гостевой ОС по выделению памяти. Ни один из них в одиночку не описывает всё. Проверяйте также гостевой paging, swap хоста, признаки нехватки и скорость приложений.
Не весь файловый кэш обязан быть занят постоянно, но считать его полностью бесплатным тоже нельзя. После сокращения кэша растёт обращение к дискам. Если экономия RAM приводит к заметному ухудшению задержки, она противоречит исходной задаче. Для СУБД отдельно учитывают лимиты её кэша и память ОС; низкая текущая активность базы не доказывает, что выделение можно безопасно уменьшить.
Сколько оперативной памяти нужно для Proxmox?
В официальных требованиях Proxmox VE указан минимум 2 ГБ для ОС и сервисов самой платформы; память гостей добавляется отдельно. Это минимальное требование к запуску, а не универсальный резерв для рабочего узла. Фактический расход зависит от конфигурации, числа ВМ, служб, кэшей и хранения. Если на том же хосте работают ZFS или распределённое хранилище, их ресурсы учитывают в бюджете отдельно.
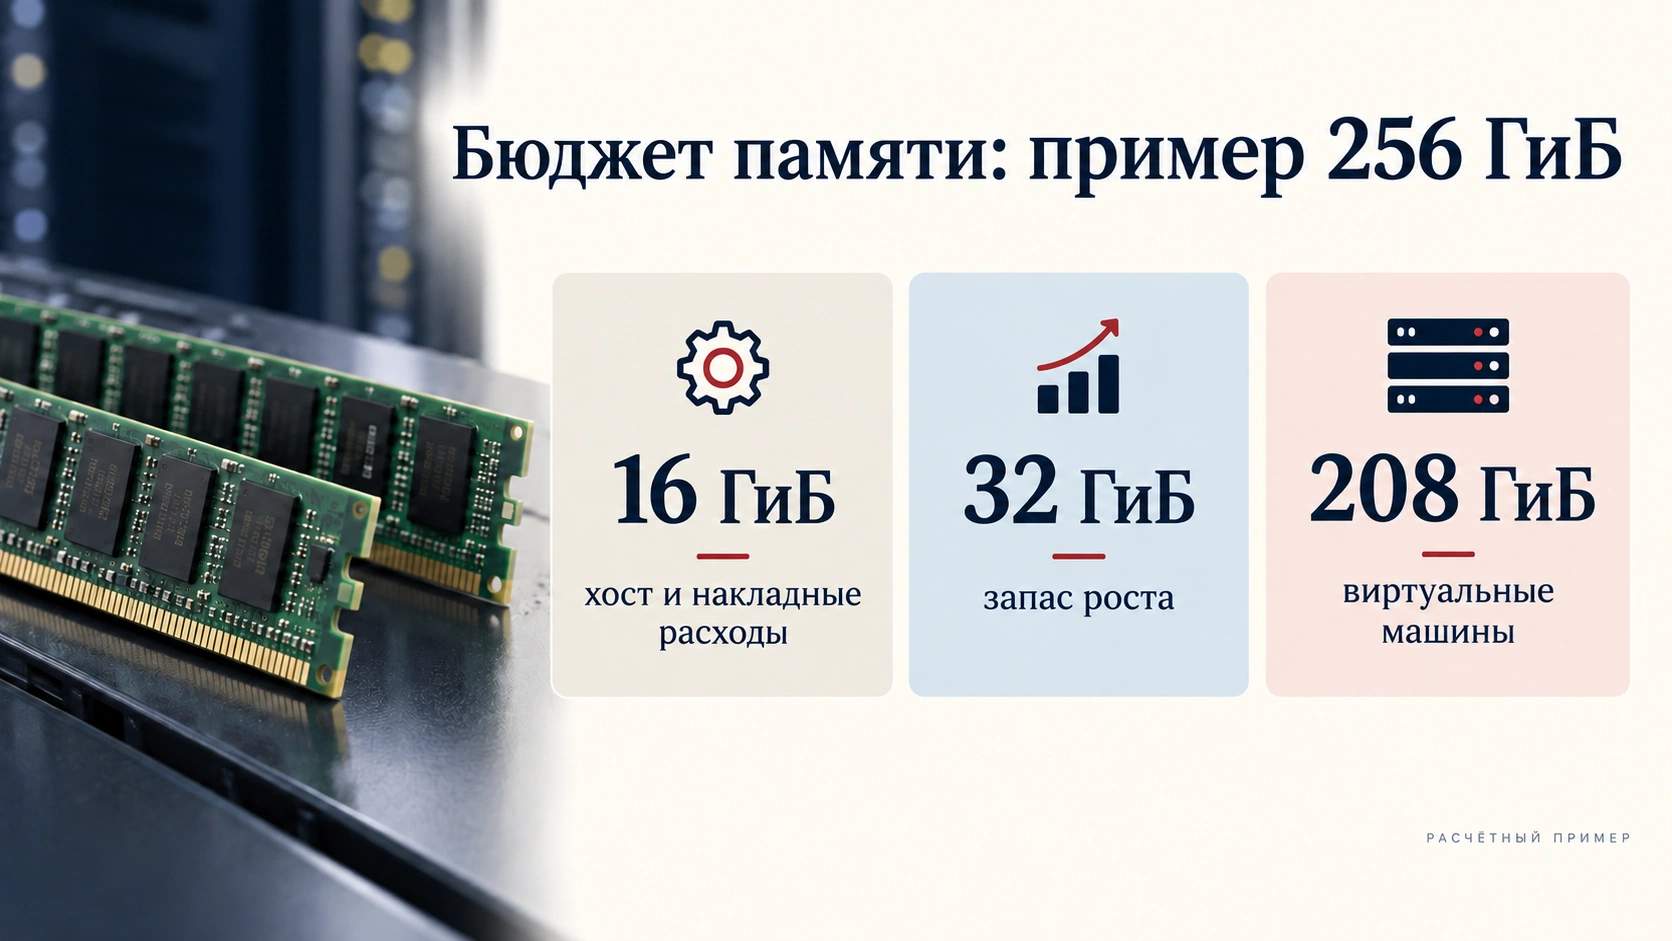
В модели ниже принято 16 ГиБ на хост вместе с накладными расходами. Эта цифра выбрана для демонстрации арифметики. До закупки её необходимо подтвердить для нужной плотности, платформы и схемы хранения. Для другого решения она может оказаться как избыточной, так и недостаточной.
Можно ли переподписывать RAM: ballooning, KSM и Dynamic Memory?
Ballooning позволяет вернуть часть памяти гостя хосту через соответствующий драйвер. KSM объединяет идентичные страницы. Выигрыш зависит от содержимого памяти, настроек и поведения гостей. При изменении рабочих данных одинаковые страницы могут перестать быть общими. Поэтому заранее обещать фиксированную экономию в гигабайтах нельзя.
Для критичных систем проектируйте требуемую рабочую память так, чтобы она обеспечивалась без предполагаемой экономии KSM. Динамическое управление проверяйте под совместной нагрузкой: экономия на простаивающих ВМ не характеризует массовую активность. Наличие swap помогает в некоторых ситуациях пережить давление на память, но не делает диски эквивалентом RAM по задержке.
У Hyper-V Dynamic Memory различаются Startup RAM, Minimum RAM и Maximum RAM. Запуск и дальнейшая работа предъявляют разные требования. Microsoft отдельно указывает, что Smart Paging не применяется при запуске выключенной ВМ и при её переходе на другой узел кластера после отказа. Поэтому рассчитывать аварийную вместимость по Minimum RAM без проверки запуска нельзя.
Пример расчёта: сколько ВМ выдержит сервер с 32 ядрами и 256 ГиБ RAM?
Все числа в следующих примерах — заданные условия учебной модели, а не результаты испытаний Supermicro. Производительность ядер считается сопоставимой; дополнительный эффект SMT в расчёт не включён. CPU-потребность каждого профиля выражена в условных физических ядрах целевого CPU.
Примем 32 физических ядра; H = 2 условных ядра на хост и служебную обработку; U = 70%. Получим (32 − 2) × 0,70 = 21 условное ядро для гостей. Из 256 ГиБ вычтем 16 ГиБ на хост и накладные расходы и 32 ГиБ на рост: 256 − 16 − 32 = 208 ГиБ.
| Условный профиль одной ВМ | Назначено | CPU-потребность D | Лимит CPU | Лимит RAM | Предварительный предел |
|---|---|---|---|---|---|
| Небольшой сервис | 2 vCPU / 4 ГиБ | 0,2 ядра | floor(21 / 0,2) = 105 | floor(208 / 4) = 52 | 52 ВМ, ограничение по RAM |
| Умеренная нагрузка | 4 vCPU / 8 ГиБ | 0,8 ядра | floor(21 / 0,8) = 26 | floor(208 / 8) = 26 | 26 ВМ |
| Высокая вычислительная нагрузка | 4 vCPU / 8 ГиБ | 2,8 ядра | floor(21 / 2,8) = 7 | floor(208 / 8) = 26 | 7 ВМ, ограничение по CPU |
| Приложение с большим рабочим набором | 8 vCPU / 32 ГиБ | 4 ядра | floor(21 / 4) = 5 | floor(208 / 32) = 6 | 5 ВМ, ограничение по CPU |
В строке с умеренной нагрузкой 26 ВМ получают 104 vCPU. Отношение к 32 физическим ядрам — 3,25:1. Их модельная потребность составляет 26 × 0,8 = 20,8 ядра, а RAM — 208 ГиБ. Арифметика проходит оба заданных ограничения. Однако даже небольшое увеличение расхода платформы потребует пересчёта: бюджет 16 ГиБ должен соответствовать именно 26 ВМ.
Таблица не обещает 52 маленькие ВМ на любой 32-ядерной системе. У таких гостей могут оказаться интенсивные фоновые задания, а их реальный D — в десять раз выше. До подтверждения профиля число остаётся ориентиром для выбора стенда.
Что изменится при росте CPU-нагрузки на 25%?
Если до конца планового периода D умеренного профиля увеличится с 0,8 до 1,0 условного ядра, предел CPU уменьшится до floor(21 / 1,0) = 21 ВМ. В RAM пока помещаются 26. Поэтому общий предел станет 21. Свободная память не компенсирует процессорный дефицит.
Не учитывайте один и тот же рост дважды. Если будущий D уже содержит увеличение работы на 25%, не умножайте его повторно на коэффициент роста. Свободные 30% CPU в этой модели остаются оперативным запасом сверх выбранного проектного режима; их назначение нужно явно записать.
Как рассчитать сервер, если виртуальные машины разные?
В реальной среде встречаются инфраструктурные сервисы, приложения, базы и терминальные роли. Средняя ВМ скрывает эти различия. Возьмём четыре заданных профиля, для которых указана потребность в один и тот же расчётный период совместной активности.
| Профиль | Число ВМ | Одна ВМ | D одной ВМ | Суммарный CPU | Суммарная RAM |
|---|---|---|---|---|---|
| Небольшие сервисы | 12 | 2 vCPU / 4 ГиБ | 0,2 | 2,4 ядра | 48 ГиБ |
| Серверы приложений | 8 | 4 vCPU / 8 ГиБ | 1,4 | 11,2 ядра | 64 ГиБ |
| Базы данных | 2 | 8 vCPU / 32 ГиБ | 4,0 | 8,0 ядер | 64 ГиБ |
| Терминальные роли | 2 | 4 vCPU / 16 ГиБ | 1,6 | 3,2 ядра | 32 ГиБ |
| Всего | 24 | 80 vCPU назначено | — | 24,8 ядра | 208 ГиБ |
RAM укладывается в 208 ГиБ, CPU превышает бюджет 21 ядро на 3,8. Это не утверждение, что хост физически не запустит машины: конфигурация не проходит выбранное условие загрузки 70%. Потребность гостям занимает 24,8 / 30 ≈ 82,7% оставшейся после служебного бюджета мощности.
Если просто увеличить RAM до 512 ГиБ, процессорное ограничение останется. При прочих тех же условиях 48 физических ядер дают (48 − 2) × 0,70 = 32,2 расчётного ядра, и данный пул проходит предварительную CPU-проверку. Но переход на другой CPU требует проверки сопоставимости ядер: 48 медленных ядер не обязаны заменить 32 быстрых в чувствительной к одному потоку базе.
Есть и другие варианты: распределить роли между узлами, изменить расписание фоновых работ, уменьшить лишние vCPU или оптимизировать конкретную тяжёлую операцию. Каждый вариант проверяют по времени отклика. Нельзя снизить D в таблице только ради того, чтобы уложиться в желаемую цену.
Почему свободных CPU и RAM иногда недостаточно: NUMA и крупные ВМ
NUMA описывает расположение памяти относительно вычислительных ресурсов. Доступ к локальной памяти и памяти другого узла может отличаться по задержке и пропускной способности. Одна большая ВМ способна чувствовать топологию заметнее, чем десятки небольших.
Число сокетов не всегда равно числу NUMA-узлов. Например, настройки NPS у определённых AMD EPYC позволяют разделять ресурсы одного сокета на несколько доменов. Проверяйте фактическую топологию установленного процессора, BIOS и гипервизора. Схему виртуальных сокетов также нельзя выбирать только из соображений удобства.
Условный хост имеет два NUMA-узла по 128 ГиБ. ВМ с 160 ГиБ не помещается целиком в один из них, даже если её объём меньше общей RAM сервера. Она может работать, используя несколько узлов; вопрос в том, корректно ли приложение и платформа используют такую раскладку и выполняется ли требование по задержке.
Проверяйте крупнейшую ВМ отдельно: число vCPU, расположение памяти, настройки vNUMA и работу после миграции. Суммарные свободные 160 ГиБ в кластере, распределённые между двумя хостами, вообще не означают возможность выдать одному гостю 160 ГиБ: обычная ВМ должна разместиться на одном физическом хосте.
Какой запас CPU и RAM нужен при отказе одного сервера?
При требовании N+1 обязательная рабочая нагрузка должна помещаться в оставшихся узлах после потери одного. Плановое обслуживание тоже может временно убрать сервер из работы. Если во время обслуживания требуется переносить ещё один отказ, сценарий сложнее обычного N+1 и должен быть рассчитан отдельно.
Для одинаковых хостов предварительное условие по ресурсам выглядит так: Dвсего ≤ (n − 1) × BCPU и Mвсего ≤ (n − 1) × BRAM. n — установленное число хостов. Эти неравенства необходимы, но недостаточны: нужно проверить реальное размещение каждой ВМ и ресурсы во время её восстановления.
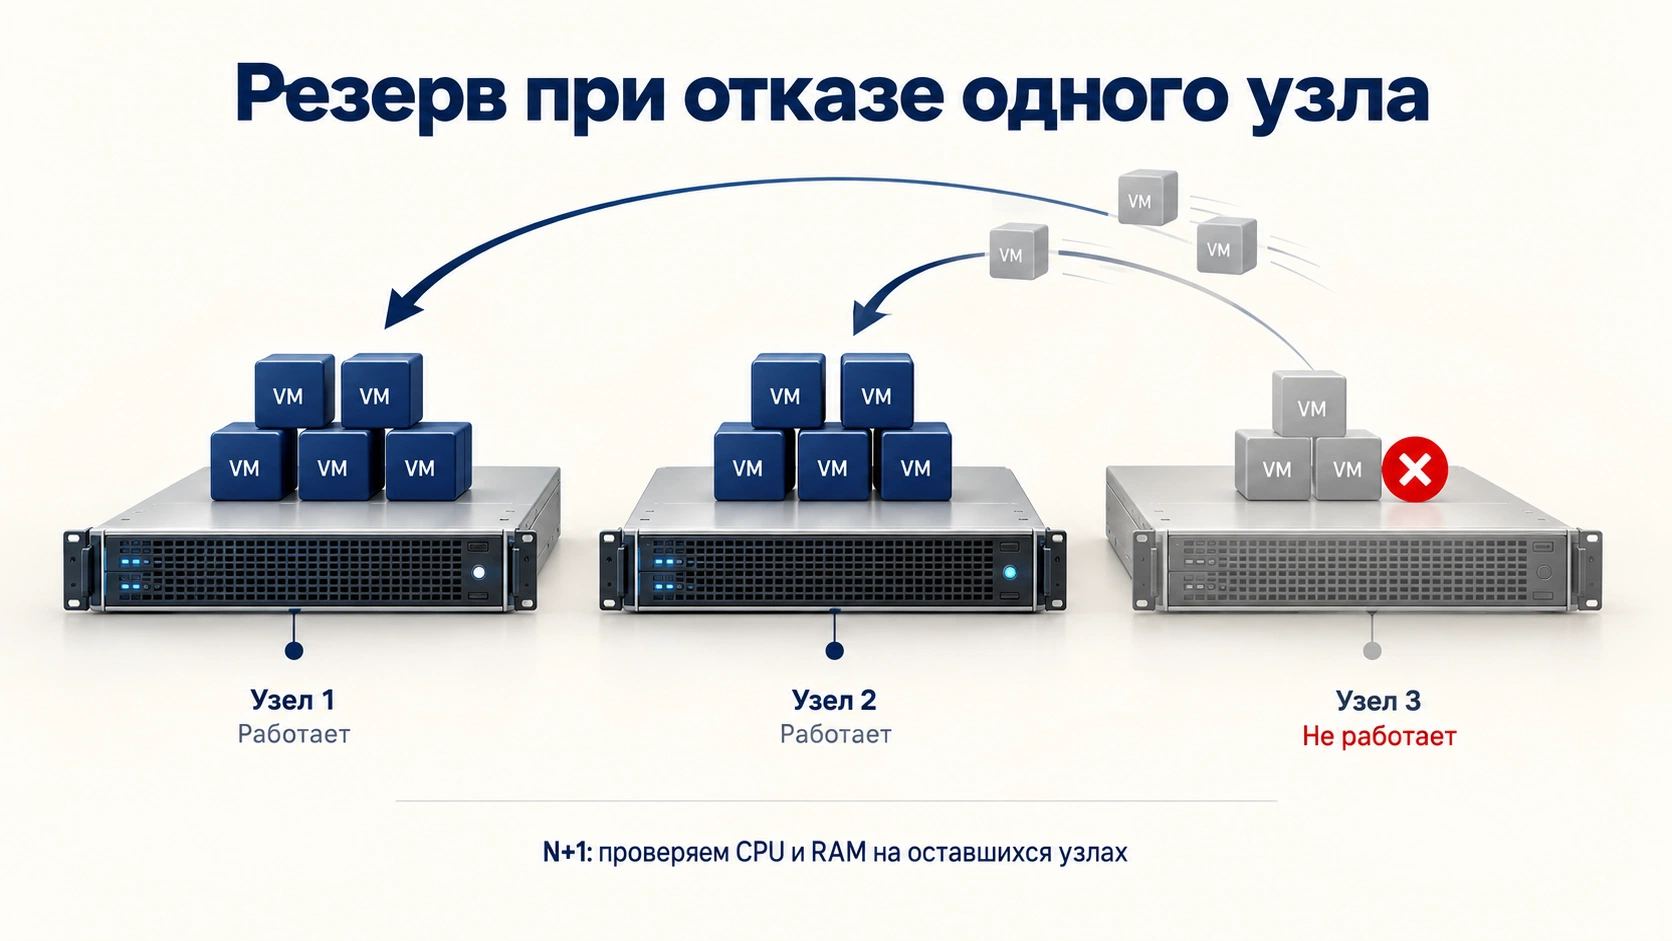
Пример N+1 для трёх одинаковых узлов
Используем прежний бюджет одного хоста: 21 условное ядро и 208 ГиБ гостям. В штатном режиме суммарно доступны 63 ядра и 624 ГиБ. После потери одного узла — 42 ядра и 416 ГиБ. Считаем ВМ умеренного профиля: D = 0,8, RAM = 8 ГиБ.
| Пул | Потребность CPU / RAM | Три узла работают | Один узел потерян |
|---|---|---|---|
| 40 ВМ | 32 условных ядра / 320 ГиБ | Проходит арифметическую проверку | Проходит: на каждый оставшийся узел по 20 ВМ, 16 ядер и 160 ГиБ |
| 60 ВМ | 48 условных ядер / 480 ГиБ | Проходит: на каждом по 20 ВМ | Не проходит: потребность выше 42 ядер и 416 ГиБ |
Для одинаковых узлов резерв целого одного хоста составляет долю 1/n от номинальной суммарной ёмкости: в трёхузловой схеме 33,3%, в четырёхузловой 25%. Это идеализированная арифметика. Она не учитывает фрагментацию свободных ресурсов, ограничения размещения и повышенную нагрузку при восстановлении.
Для неодинаковых серверов последовательно моделируйте потерю каждого значимого узла. Достаточность RAM после отказа самого ёмкого хоста и достаточность CPU после отказа самого производительного — разные проверки. Добавление слабого сервера не превращает произвольный кластер в N+1.
Что ещё проверяют кроме суммы ресурсов?
Наличие кворума, доступность дисков гостя с другого узла, правила HA, сеть и фактический процесс перезапуска. При локальном хранении возможность восстановить ВМ определяется выбранной архитектурой доступа или репликации. Репликация может быть асинхронной; допустимая потеря данных должна быть согласована отдельно.
Сценарий отказа создаёт свою нагрузку: одновременная загрузка ОС, старт приложений, прогрев кэшей и восстановление хранения. Поэтому после проверки «все помещаются» нужна проверка «все успевают восстановиться и нормально работать». Ограничения anti-affinity, резервирования памяти, закрепления CPU и passthrough могут уменьшить доступный набор узлов.
Как выбрать конфигурацию Supermicro по результатам расчёта?
Сначала определите необходимую производительность, RAM, размер крупнейшей ВМ и число рабочих узлов после отказа. Затем выбирайте платформу, которая обеспечивает эти параметры при совместимой комплектации. Название SuperServer или высота 2U сами по себе не характеризуют вместимость.
Например, Supermicro Hyper AS-2015HS-TNR — односокетная 2U-платформа с 24 слотами DDR5 DIMM. В официальной спецификации указаны AMD EPYC 9004/9005; поддержка EPYC 9005 требует соответствующей ревизии платы 2.x. Это пример платформы с возможностью расширения памяти, а не готовая конфигурация на определённое число ВМ. Установленный CPU, состав DIMM и версия платформы должны быть зафиксированы отдельно.
Один современный сокет может быть достаточен для значительного пула гостей. Два сокета рассматривают, когда нужны большая суммарная мощность, память или доступные ресурсы расширения. При этом оценивают топологию и стоимость программного использования выбранного оборудования. Две процессорные модели нельзя сравнивать только по сумме ядер в прайс-листе.
При выборе среди готовых серверов Supermicro проверяйте фактическую комплектацию. Серверная платформа и полностью собранный сервер могут иметь разный состав поставки. Число доступных слотов не означает, что память уже установлена, а поддержка нескольких интерфейсов дисков не означает наличие всех требуемых кабелей и контроллеров.
Как не переплатить за CPU и память?
Сравнивайте варианты на одном профиле нагрузки. Если первым заканчивается RAM, дополнительные ядра могут почти не увеличить число ВМ. Если ограничение процессорное, переход с 256 на 512 ГиБ без изменения CPU не решит проблему. Вариант с низкой стартовой ценой также может потребовать дорогой замены всех модулей при расширении.
Для памяти проверяют не только объём, но и заполнение каналов, ранги, число DIMM на канал и поддерживаемую частоту. Один большой модуль и набор модулей по каналам не всегда дают одинаковую пропускную способность. Подробности совместимости и размещения разобраны в руководстве по памяти Supermicro. Здесь задача другая — определить требуемую ёмкость для ВМ.
Практичная закупка оставляет понятный путь роста: совместимые модули, свободные ресурсы расширения и возможность добавить узел без ограничения миграции. Но запас должен соответствовать прогнозу. Покупка вдвое большего объёма RAM для пула, который стабильно упирается в CPU, оправдана только отдельным планом расширения.
Если требуется несколько узлов и восстановление при отказе, результат расчёта можно использовать как исходное ТЗ для кластера виртуализации Supermicro. В предложении должны быть отдельно указаны аппаратная комплектация, программная платформа, лицензии и работы: присутствие карточки решения не означает автоматическое включение всех этих частей.
Как проверить, что сервер действительно выдержит нужное число ВМ?
До покупки согласуйте испытание на сопоставимой конфигурации. Важны модели CPU, установленные DIMM, схема хранения и сеть, версия гипервизора, гостевые драйверы и настройки питания. Тест другого процессора с таким же числом ядер не подтверждает ваш результат.
Копии рабочих баз и данных должны быть обезличены, если это требуется условиями проекта. Для теста используют изолированную среду: нельзя устраивать проверку отказа на рабочей инфраструктуре без согласованного порядка. Сам тест строится вокруг приложений, а не вокруг максимального числа клонированных ОС.
| Сценарий | Что запускать | Что оценивать |
|---|---|---|
| Обычный рабочий период | Все нужные роли с типичной одновременной активностью | Пропускную способность, p95/p99 операций, CPU и память |
| Совместный пик | Рабочую нагрузку вместе с фоновыми задачами по реальному расписанию | Рост очередей, задержки планирования, paging и запас |
| Запуск группы ВМ | Контролируемое включение и старт сервисов | Время готовности, расход Startup RAM, нагрузку хранения |
| Потеря узла на стенде | Восстановление обязательных ВМ на оставшихся хостах | Размещение, восстановление сервиса, нагрузку после прогрева |
| Будущий объём работы | Увеличенный набор ВМ или бизнес-нагрузки по прогнозу | Выполнение прежних критериев без скрытой деградации |
Какие счётчики показывают, что CPU не хватает?
В VMware vSphere CPU Ready характеризует время ожидания исполнения готового vCPU. В Linux-гостях полезно наблюдать steal time вместе с хостовой нагрузкой; его интерпретация зависит от платформы и доступности счётчика. Также учитывают очереди приложения и выполненную работу. Низкий средний CPU хоста не исключает проблемы отдельной большой ВМ.
Не сравнивайте миллисекунды Ready с процентами напрямую. Broadcom приводит формулу: Ready % = summationms / (интервалs × 1000) × 100. Если за интервал 20 секунд накоплено 1000 мс, получается 5%. Для агрегированного показателя многопроцессорной ВМ значение может суммировать ожидание её vCPU; индивидуальные метрики точнее характеризуют каждый процессор.
Поэтому правило «5% всегда плохо» без контекста неверно. Проверяйте уровень агрегации, временной интервал, изменение относительно нормального режима и влияние на приложение. Устойчивая очередь и ухудшение отклика требуют разбора; единичный пик сам по себе не определяет конфигурацию.
Какие условия записать в протоколе приёмки?
Заранее задайте допустимые времена операций, число одновременных пользователей или запросов, длительность проверки и сценарий отказа. Например, «p95 выбранного запроса не более 2 секунд при 100 одновременных сессиях» — проверяемое условие, если описаны запрос и данные. «Сервер должен быть быстрым» проверить невозможно. Значения в этом примере придуманы для формы протокола, а не являются нормой для любой системы.
Достаточность RAM подтверждают без устойчивого дефицита памяти и связанного с ним ухудшения отклика. Swap, который использовался в прошлом и сейчас не создаёт активного обмена, не равен постоянному давлению на память. При отказе отдельно измеряют время готовности приложения, а не только статус «ВМ включена».
Если тест не проходит, установите причину. Увеличение CPU не устранит медленное хранилище или программную блокировку. Добавление RAM не поможет операции, которая целиком выполняется в одном потоке и уже помещается в память. Конфигурацию меняют по выявленному ограничению, после чего повторяют именно не прошедший сценарий.
Какие ошибки чаще всего приводят к неверной закупке?
- Расчёт по сумме vCPU. Игнорируется фактическая активность; покупают лишние ядра либо чрезмерно уменьшают их число коэффициентом 4:1.
- Удвоение мощности из-за SMT. Два логических потока записывают как два полноценных физических ядра.
- Средняя загрузка без пиков. Ночная тишина скрывает утренний запуск всех сервисов.
- Смешение единиц. Проценты разных панелей, миллисекунды Ready и условные ядра складывают без нормализации.
- RAM по Minimum RAM. Не учитываются фактическая работа и потребность при запуске.
- Резерв без назначения. Один и тот же рост включают в нагрузку и в несколько коэффициентов, завышая закупку.
- Сумма вместо размещения. Крупная ВМ не помещается на конкретном хосте или нарушает правила разнесения.
- N+1 только на бумаге. Не проверяются запуск после отказа, хранение и время восстановления.
Частые вопросы о количестве виртуальных машин, CPU и RAM
Сколько виртуальных машин можно запустить на одном сервере Supermicro?
Одного числа для всех конфигураций нет. Для одинаковых гостей предварительно считают min(floor(BCPU / D), floor(BRAM / M)), затем проверяют хранение, сеть и размещение. Для разных ВМ используют сумму потребностей профилей. Работоспособность подтверждает испытание приложений под одновременной нагрузкой.
Что значит 2 vCPU: это два физических ядра?
Это два виртуальных процессора гостя. Они получают время исполнения на процессорах хоста. Выделение 2 vCPU само по себе не гарантирует два эксклюзивных физических ядра и определённую скорость работы; такие условия задаются механизмами резервирования и конкретной платформой.
Сколько vCPU выделять виртуальной машине: 2, 4 или 8?
Столько, сколько позволяет выполнить её задачу с нужной задержкой. Сначала проверьте рекомендованный минимум приложения, затем сравните нагрузку и скорость при увеличении vCPU. Если приложение не использует дополнительный параллелизм, увеличение может не дать ускорения и усложнить планирование ресурсов.
Сколько памяти выделить виртуальной машине?
Память должна покрывать гостевую ОС, рабочий набор приложения и согласованный запас. Объём проверяют по активной работе, paging и времени операций. Универсальной нормы «8 ГБ на каждую ВМ» нет: сервис каталогов, база, обработчик аналитики и удалённое рабочее место имеют разные потребности.
Хватит ли 128 ГиБ RAM для 20 виртуальных машин?
Если каждой требуется 8 ГиБ, только гостям нужно 160 ГиБ, и 128 ГиБ недостаточно для модели без переподписки. Если каждой достаточно 4 ГиБ, сумма составляет 80 ГиБ; из оставшихся 48 ГиБ нужно покрыть платформу, накладные расходы и рост. Затем отдельно проверяют CPU: память не определяет результат в одиночку.
Сколько ВМ поместится в 256 или 512 ГиБ памяти?
Если в обоих условных примерах оставить 16 ГиБ платформе и 32 ГиБ росту, гостям доступны 208 и 464 ГиБ. При 8 ГиБ на гостя RAM-лимиты равны 26 и 58 ВМ. Это только арифметика памяти, а не подтверждённая вместимость серверов: CPU и фактические накладные расходы могут уменьшить число.
Что важнее для виртуализации — частота CPU или количество ядер?
Для чувствительной к одному потоку операции важна производительность этого потока, которая не определяется одной частотой. Для большого пула параллельных работ важна суммарная мощность. Покупать нужно под оба условия: самая медленная критичная операция должна укладываться в норму, а все ВМ вместе — в бюджет хоста.
Нужны ли два процессора для 30 виртуальных машин?
Не обязательно. Тридцать лёгких гостей и тридцать активных вычислительных машин — разные проекты. Один сокет может покрыть задачу, если хватает производительности, памяти и расширения. Два выбирают по расчёту, а не по самому числу ВМ.
Можно ли назначить больше RAM, чем физически установлено?
Некоторые платформы поддерживают такую конфигурацию и динамическое управление. Но при одновременной потребности всех гостей физическая ёмкость не увеличится. Для критичной среды необходимы подтверждённая политика памяти, мониторинг и сценарий отказа; успех запуска простаивающих ВМ не доказывает устойчивость.
Сколько памяти оставить гипервизору?
Столько, сколько требуется выбранной конфигурации при итоговой плотности ВМ и работе её служб. Минимальные системные требования не являются резервом для производственной нагрузки. В расчёт также входят связанные службы хранения, управления и накладные расходы гостей без двойного учёта.
Почему при свободном CPU виртуальные машины работают медленно?
Причиной могут быть ожидание планировщика у отдельных ВМ, NUMA-размещение, нехватка гостевой памяти, дисковые задержки, сеть или ограничение приложения. Сопоставьте момент замедления с индивидуальными счётчиками и конкретной операцией. Общий процент CPU хоста не объясняет каждый случай.
Можно ли считать контейнеры как обычные виртуальные машины?
Нет, их механизмы изоляции и накладные расходы отличаются. Раздельно учитывайте ВМ и контейнеры, затем складывайте подтверждённую потребность в общих ресурсах хоста. Цифра плотности из опыта с контейнерами не переносится напрямую на полные гостевые ОС.
Нужен ли запас N+1, если уже есть резервные копии?
Резервные копии позволяют восстанавливать данные по выбранной процедуре, но сами по себе не предоставляют свободные CPU и RAM для быстрого перезапуска всех сервисов. Требуемую ёмкость и время восстановления определяют отдельно. Если допустим длительный простой, архитектура может быть другой.
Что передать поставщику для обоснованного подбора?
Подготовьте реестр ВМ, совместные графики нагрузки, требования к задержке, прогноз роста и описание аварийного сценария. Укажите крупнейшую машину, гипервизор, ограничения миграции и обязательные периферийные устройства. Для нового проекта приложите план пилота вместо неподтверждённой «средней нагрузки».
В спецификации должны совпадать расчёт и поставка: модель CPU, количество физических ядер, состав памяти по модулям, доступная гостям RAM, число узлов и компоненты хранения и сети. Решение о покупке стоит принимать по этому комплекту данных и протоколу проверки вашей нагрузки.
