Серверы для Kubernetes: как рассчитать узлы, CPU, память и локальные диски
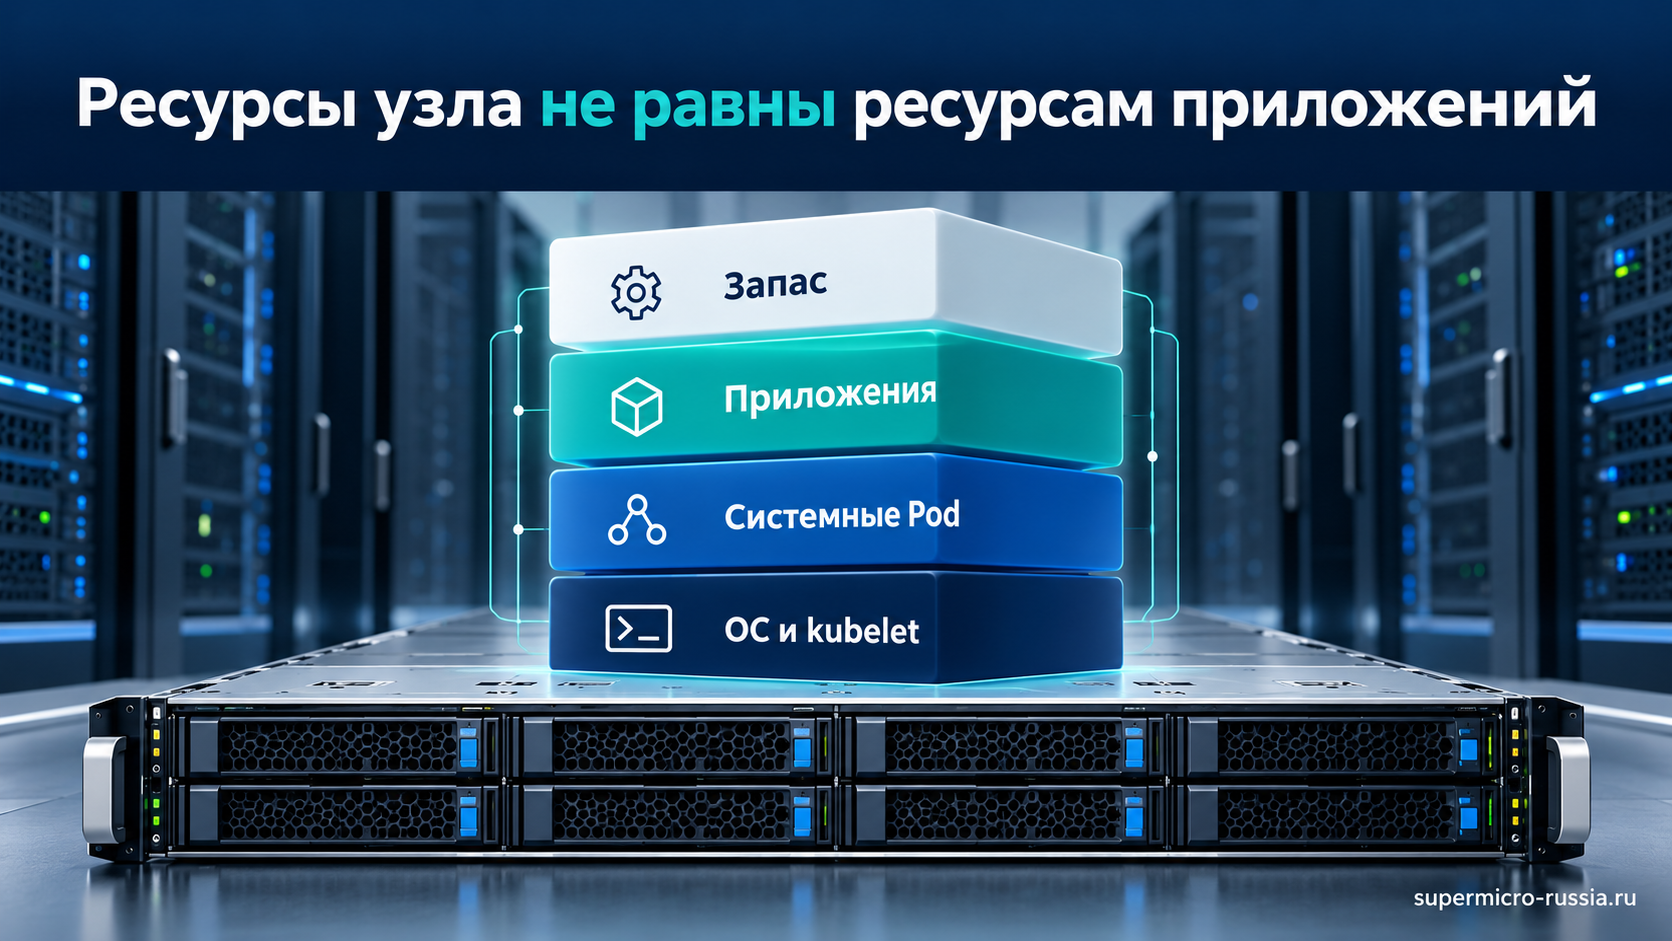
Серверы для Kubernetes рассчитывают по ресурсам приложений, системным расходам и работе после отказа узла. Сумма ядер и памяти всех машин показывает установленный ресурс, но не доступную вместимость приложений. Часть занимает ОС, kubelet, runtime, сетевые компоненты, мониторинг и резерв на пиковые события.
Доступность приложений зависит также от etcd, сети и постоянных томов. Кворум управляющих узлов сохраняет управление кластером, но не заменяет репликацию данных и ресурсы для возврата нагрузки после отказа.
Сколько серверов нужно для Kubernetes?
Для лаборатории достаточно одного узла, если допустимо останавливать весь стенд. Для рабочей системы количество зависит от архитектуры управления, нужной ёмкости, хранения и модели отказов. Смешивать эти два назначения в одной «минимальной конфигурации Kubernetes» нельзя.
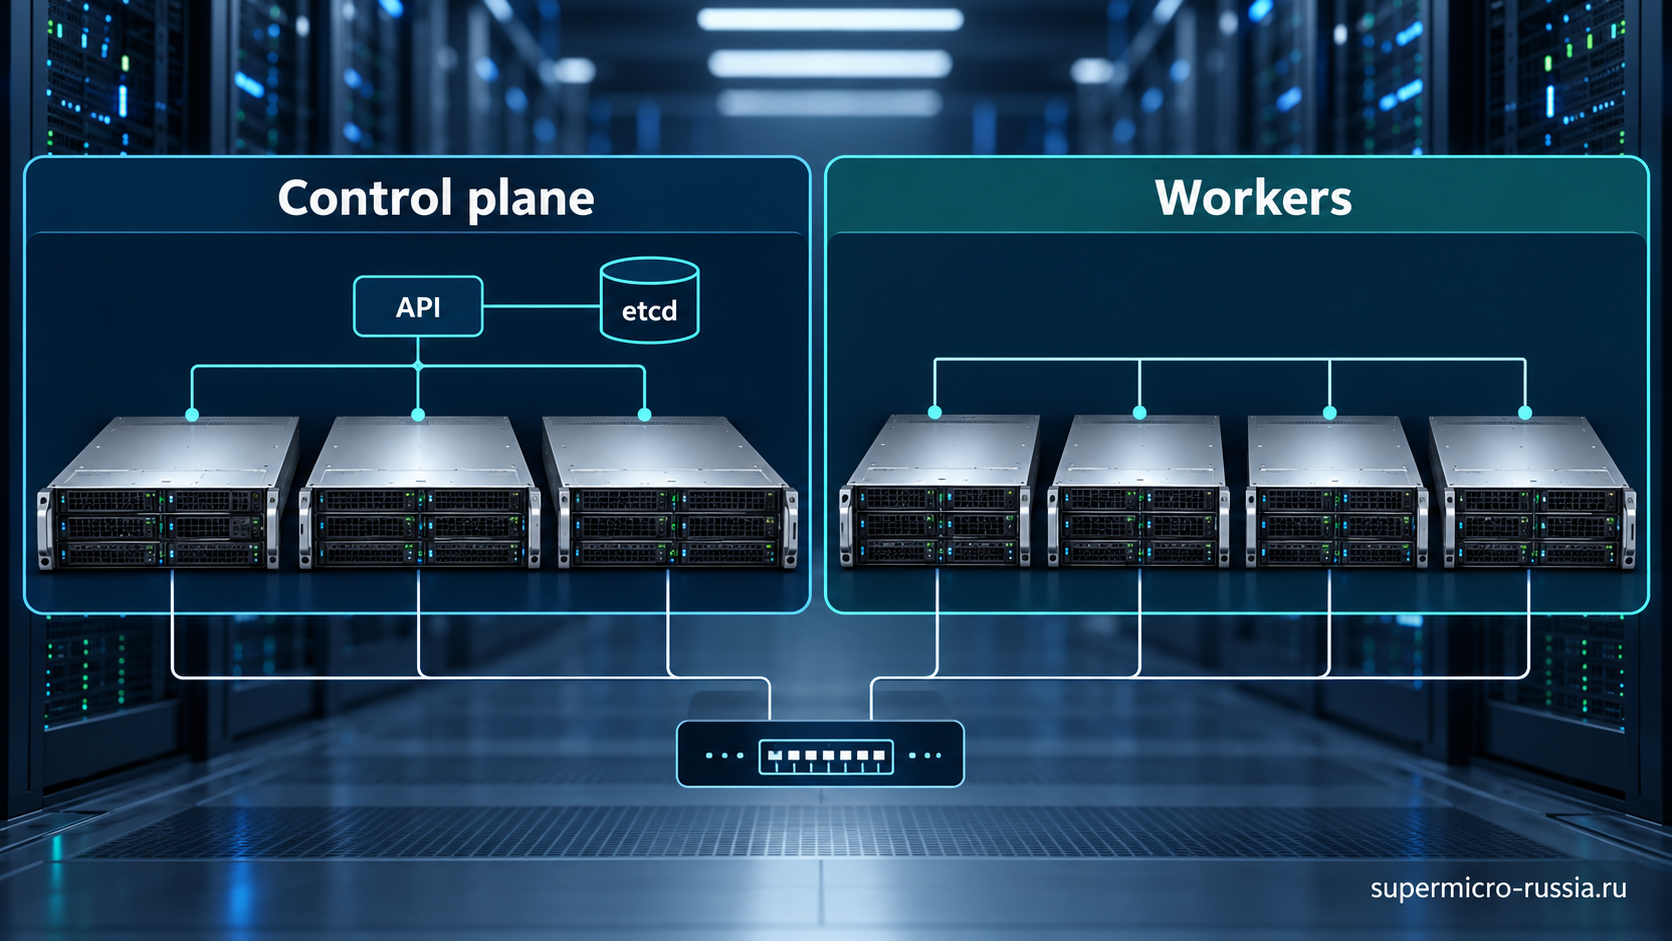
В распространённой отказоустойчивой схеме etcd имеет три голосующих участника и сохраняет кворум при потере одного. Пять участников могут пережить потерю двух, если остальные доступны и связаны. Четыре участника не дают большего допустимого числа отказов, чем три: большинству из четырёх нужны три. Добавление участников не является обычным способом ускорить etcd.
Control plane может использовать локальный etcd на тех же узлах либо отдельный кластер etcd. Рабочие приложения размещают на worker-узлах; в компактных установках роли иногда совмещают. При совмещении отказ и перегрузка одного сервера одновременно затрагивают управление и нагрузку, поэтому нужен явный бюджет ресурсов и проверка соответствующего риска.
Что bare-metal Kubernetes должен получить вместо облачных сервисов?
На bare metal балансировщик, хранение, адреса и управление аппаратурой проектируют отдельно. Без них узлы могут иметь статус Ready, пока приложение остаётся недоступным снаружи или не получает постоянный том.
| Потребность | Что нужно определить | Проверяемый результат |
|---|---|---|
| Доступ к API | Устойчивую точку входа, адрес и путь к control plane | Управление сохраняется при предусмотренном отказе |
| Доступ к приложениям | Ingress/Gateway, внешний балансировщик или иной принятый способ | Клиент достигает нужных реплик после отказа узла |
| Сеть Pod | CNI, маршруты, MTU, адреса и политики | Работает фактический трафик приложения, а не только ping |
| Постоянные данные | CSI, режимы доступа, topology и восстановление | Приложение получает доступ к правильным данным |
| Жизненный цикл | Установку ОС, BMC, обновления и замену узла | Сервер воспроизводимо возвращается в рабочее состояние |
Не все способы публикации сервиса одинаковы. Service типа LoadBalancer требует работающей реализации соответствующего механизма в окружении; само объявление ресурса не создаёт отсутствующее внешнее оборудование. Выбор маршрутизации и объявления адресов должен соответствовать сети площадки и модели отказов.
Control plane, workers и etcd: что рассчитывают отдельно?
| Роль | Основной ресурс | Типичная ошибка |
|---|---|---|
| API server и контроллеры | CPU, RAM, число объектов, частота событий и запросов | Оценка только по числу рабочих Pod |
| etcd | Задержка подтверждённой записи, сеть между участниками, RAM | Медленный общий диск рядом с тяжёлым журналированием |
| Worker | Эффективные requests, фактические пики и системные расходы | Выделение приложениям всей физической памяти |
| Хранилище приложений | IOPS, задержки, репликация, восстановление | Ожидание автоматического переноса локальных данных |
| Общая инфраструктура | DNS, registry, балансировка, доступ, мониторинг | Незамеченная единственная точка отказа вне Kubernetes |
Control plane выбирают по размеру и активности кластера, а не по фиксированному проценту от worker-ресурсов. Сотни редко меняющихся Pod и активная среда с большим количеством CRD, операторов и событий могут создавать разную нагрузку. Стартовые требования конкретного дистрибутива используют как нижнюю границу запуска, затем проверяют свой профиль.
Как собрать ресурсную ведомость приложений?
Для каждого сервиса записывают число реплик, CPU и memory requests, ограничения, временное хранение, постоянные тома, зависимости и план обновления. Учитывают sidecar, init-контейнеры и эффективный ресурс Pod по правилам используемой версии Kubernetes. Отдельно считают DaemonSet, потому что его расход повторяется на каждом подходящем узле.
Например, сервис имеет шесть реплик с requests 2 CPU и 4 ГиБ на Pod. На размещение требуется 12 CPU и 24 ГиБ. Если на время обновления допускаются две дополнительные реплики того же размера, понадобится ещё 4 CPU и 8 ГиБ. Если этот ресурс не предусмотрен, обновление может зависнуть на Pending даже при нормальной повседневной работе.
Requests подбирают по запуску, прогреву и рабочим пикам. Заниженное значение позволяет планировщику разместить больше нагрузки, чем узел устойчиво обслуживает; завышенное оставляет часть ресурса недоступной другим Pod.
Capacity и Allocatable: почему нельзя отдать контейнерам всю RAM?
Capacity описывает ресурсы узла, Allocatable — доступный для размещения Pod бюджет после предусмотренных системных резервов. Настройки kubeReserved, systemReserved и пороги вытеснения задают с учётом ОС и дистрибутива. После этого из бюджета Pod отдельно учитывают системные DaemonSet и другие размещённые компоненты.
Для условного worker с Capacity 32 CPU и 128 ГиБ памяти заложим 4 CPU и 16 ГиБ на системный резерв. Получим 28 CPU и 112 ГиБ Allocatable. Пусть системные Pod занимают ещё 2 CPU и 8 ГиБ по requests. Для прикладных Pod остаётся 26 CPU и 104 ГиБ до дополнительного эксплуатационного запаса.
В этом примере CPU — единицы ресурса, которые видит Kubernetes. На bare metal при включённом SMT они связаны с логическими процессорами; их нельзя считать равными физическим ядрам другого CPU по производительности. Сопоставимость подтверждают тестом приложения и записывают режим SMT.
Как оценить системные Pod и рост наблюдаемости?
DaemonSet добавляет экземпляр на каждый подходящий узел. Если два агента вместе запрашивают 0,4 CPU и 600 MiB на узел, шесть узлов требуют суммарно 2,4 CPU и 3600 MiB, около 3,52 GiB. Это учебный пример: собственные requests и фактическое потребление агентов надо измерить. Добавление узлов увеличивает не только прикладную вместимость, но и часть инфраструктурных расходов.
Метрики, логи и трассировки растут по разным правилам. Число временных рядов зависит от меток и количества объектов, объём логов — от приложений и уровня подробности, хранение — от срока удержания. Бюджет «всё служебное — 2 ГБ» быстро теряет смысл, если в тот же кластер добавили registry, систему мониторинга и долгий архив журналов.
При условном потоке логов 5 MB/s за сутки поступит 432 GB исходного текста, за семь суток — 3,024 TB. К этому добавляют индексы, реплики и резерв, а эффект сжатия измеряют отдельно. Приём журналов проверяют одновременно с другими задачами диска.
Расчёт N+1: пример на три, четыре и пять worker-узлов
Пусть приложения суммарно запрашивают 48 CPU и 180 ГиБ. Каждый worker имеет рассчитанные выше 26 CPU и 104 ГиБ прикладного бюджета. Дополнительно примем консервативное проектное условие: после потери одного узла requests приложений занимают не более 70% оставшегося бюджета. Это выбранный резерв примера, а не обязательная норма Kubernetes.
| Workers | Прикладной бюджет в норме | После потери одного | 70% аварийного бюджета | 48 CPU / 180 ГиБ с этим резервом |
|---|---|---|---|---|
| 3 | 78 CPU / 312 ГиБ | 52 CPU / 208 ГиБ | 36,4 CPU / 145,6 ГиБ | Не помещается |
| 4 | 104 CPU / 416 ГиБ | 78 CPU / 312 ГиБ | 54,6 CPU / 218,4 ГиБ | Помещается по суммарному ресурсу |
| 5 | 130 CPU / 520 ГиБ | 104 CPU / 416 ГиБ | 72,8 CPU / 291,2 ГиБ | Есть дополнительный запас |
Четыре worker проходят проверку суммы ресурсов в данном примере. Затем проверьте размещение каждого крупного Pod и ограничения affinity, топологии и хранения: ресурс должен найтись на подходящем узле.
Как учесть rolling update, обслуживание и несколько зон отказа?
Если один worker выведен на обслуживание, а второй отказал, требуется расчёт N+2 на оставшихся узлах. Дополнительно учитывают временные Pod во время rollout: maxSurge и anti-affinity переводят в аппаратный бюджет.
Пример: 12 реплик по 1,5 CPU и 3 GiB требуют 18 CPU и 36 GiB. Четыре временные дополнительные реплики требуют ещё 6 CPU и 12 GiB. На этапе обновления нужно разместить 24 CPU и 48 GiB, не считая системных компонентов и запаса. Если одновременно недоступен worker, расчёт проводят на оставшихся допустимых узлах.
Двенадцать реплик в одном шасси не образуют двенадцать независимых аппаратных зон. Общими могут быть питание, backplane, охлаждение и сеть. Укажите, от какой аварии требуется защита: один worker, шасси, коммутатор, стойка или площадка. Ресурсная формула N+1 не покрывает потерю нескольких узлов одной зоной, если этого отдельно не заложили.
Requests, limits и реальное потребление: как связать их с железом?
Планировщик учитывает requests и ограничения размещения, а фактическое потребление может отличаться. CPU limit может приводить к throttling контейнера даже при свободном CPU на узле. Для памяти проверяют OOM, перезапуски и поведение на пределе; средняя загрузка CPU этих условий не показывает.
Для сервиса фиксируют три величины: обычное потребление, ожидаемый пик и поведение при превышении ограничения. Для Java, баз данных, кэшей и приложений с прогревом особенно важно измерить запуск и длительную работу. Автомасштабирование также требует свободного физического ресурса: HPA не создаёт новые CPU в заполненном bare-metal кластере.
В аппаратную ведомость переносят эффективные requests, ограничения и системный запас выбранного приложения. Дополнительно фиксируют поведение при превышении limits, которое проверяют в пилоте.
Почему свободные ресурсы кластера не гарантируют размещение Pod?
Предположим, на четырёх узлах свободно по 6 единиц CPU: суммарно 24. Новый Pod требует 8. Даже без других ограничений он не разместится, поскольку ни один отдельный узел не имеет нужного свободного бюджета. Это фрагментация ресурсов: агрегированная сумма полезна для предварительной оценки, но окончательное решение принимают по узлам и требованиям каждого Pod.
Дополнительные условия могут ещё сильнее сузить выбор. GPU-задача требует нужного ускорителя и device plugin, том привязан к определённой зоне или узлу, а политика размещения запрещает соседство реплик. В проектной ведомости выделяют самые крупные Pod и их совместимость с каждым классом worker. Усреднённые 0,5 CPU на контейнер не описывают приложение с отдельным тяжёлым процессом. Также проверьте лимит числа Pod на узле и ограничения CNI: свободные CPU и RAM не отменяют их.
Topology spread и anti-affinity помогают распределять реплики, но строгие ограничения тоже требуют запаса доступных доменов. При обслуживании или отказе часть вариантов размещения исчезает. Условие «реплики всегда на трёх разных узлах» нельзя сохранить на двух оставшихся узлах без изменения требований. Лучше увидеть этот конфликт при расчёте, чем во время аварии.
Какие диски нужны control plane и etcd?
etcd чувствителен к задержкам записи и сети между участниками. Большой HDD или высокая паспортная последовательная скорость не заменяют стабильную подтверждённую запись. Для control plane рассматривают подходящие SSD и отделяют конкурирующую тяжёлую нагрузку, особенно если на узле одновременно работают приложения.
Проверяют fsync/WAL latency, backend commit, смену лидера и задержку API при обновлении объектов. Численные допустимые границы задают по версии etcd, профилю кластера и требованиям, а не берут произвольный «универсальный миллисекундный норматив». Разовый быстрый тест на пустом SSD не описывает работу при заполнении и фоновой активности.
Что показывает разбор внутреннего устройства etcd?
В докладе об устройстве etcd показаны версии объектов и механизм watch. Их изменения и работа контроллеров создают нагрузку управляющего хранилища; размер базы внутри прикладного Pod не задаёт размер etcd.
Например, тысяча объектов, для каждого из которых приложение инициирует одно обновление каждые десять секунд, создаёт около ста обновлений в секунду на выбранной границе API. Это модель активности, не обещание ста физических операций записи на SSD: есть дополнительные компоненты и особенности обработки. Оценивать control plane только по суммарным CPU приложений нельзя.
Для etcd учитывают число объектов, частоту изменений, наблюдателей и нагрузку операторов. Проверяйте задержку подтверждённой записи вместе с API при развёртывании, массовом запуске Pod и восстановлении: линейная скорость SSD её не описывает.
Локальные диски worker: образы, логи, ephemeral storage и тома
В дисковый бюджет входят ОС, runtime, образы и их распаковка, writable layers, журналы, временные файлы, локальные тома и свободное место для обновлений. Десять версий образа по несколько гигабайт на каждом узле могут занимать заметный объём ещё до данных приложений. При распаковке объём способен отличаться от размера скачанного сжатого образа.
Условный worker требует 40 ГиБ на ОС и службы, 80 ГиБ на образы, 30 ГиБ на логи и 100 ГиБ на временные данные. Получается 250 ГиБ. При лимите заполнения 75% нужен бюджет 333,3 ГиБ до локальных постоянных томов и дополнительного пространства обслуживания. Поэтому системный SSD 480–960 ГБ может быть кандидатом по ёмкости в этом примере, но ресурс записи и совместимость проверяют отдельно.
Local PersistentVolume привязывает данные к конкретному месту. Перезапуск Pod на другом узле не переносит автоматически содержимое локального диска. Для состояния приложения нужны поддерживаемая репликация, доступное внешнее хранилище либо процедура восстановления. Выбор CSI и класса хранения должен соответствовать этим требованиям.
Как учесть загрузку образов и зависимость от registry?
Новый worker после отказа должен получить образы, подключить хранение и сеть, а затем запустить приложение. Если тестировали только уже прогретые узлы, время восстановления может оказаться заниженным. Проверьте отдельно холодный старт с отсутствующим образом и одновременный возврат нескольких узлов.
Условный образ объёмом 3 GB, который отсутствует на 40 узлах, создаёт до 120 GB передачи от registry при независимой полной загрузке. Для общего выхода 10 Gbit/s идеальная нижняя оценка — 96 секунд только на передачу. Реальное время больше из-за других потоков, распаковки и записи. Общие слои, кэширование и размер сжатой передачи меняют объём; в расчёте нужно использовать фактически скачиваемые данные.
Registry, DNS, доверенные сертификаты и доступ к репозиториям пакетов включают в план зависимостей. В изолированной среде заранее проверяют наличие всех нужных образов, включая CNI, CSI и системные компоненты. Зеркало registry полезно только тогда, когда известны порядок синхронизации, доступы и поведение при его недоступности.
Как учитывать репликацию хранилища и сетевой трафик?
При трёх полных репликах 1 ТБ полезных данных сами копии требуют около 3 ТБ сырого пространства. Для erasure coding теоретический коэффициент ёмкости равен (k + m) / k, где k — число частей данных, m — число частей избыточности. Например, профиль 4+2 даёт базовую оценку 1,5 ТБ на 1 ТБ пользовательских данных. Отдельно добавляют метаданные, накладные расходы размещения, свободное место и запас восстановления. Домены отказа, производительность записи и rebuild проверяют для выбранной реализации хранения.
Сеть обслуживает не только запросы пользователей. Есть Pod-to-Pod, доступ к томам, репликация, загрузка образов, backup и восстановление. Передача 100 ГБ через 1GbE теоретически занимает не менее 800 секунд, или 13 минут 20 секунд, до накладных расходов. При массовом перезапуске нескольких узлов загрузка образов может заметно продлить возврат приложения.
Для сети 10/25GbE согласуют NIC, трансиверы или DAC, коммутаторы, MTU, CNI и маршруты. Доступ к registry, хранилищу и резервным копиям проверяют по тем же участкам, которые будут работать при отказе.
Как рассчитать адреса, сеть и время переноса данных?
Адресный план включает серверы, управление, Pod, Service и внешние точки входа в рамках выбранной реализации. У CNI могут быть резервирование диапазонов на узел и собственные правила выделения. Поэтому число свободных адресов подсети нельзя напрямую приравнивать к допустимому числу Pod без проверки плагина.
Если для рассматриваемой схемы каждому Pod нужен один адрес и планируется до 600 одновременно существующих Pod, пул из 512 адресов уже мал даже до учёта остальных расходов. Это пример проверки достаточности, не универсальная рекомендация размера CIDR. Отдельно убедитесь, что диапазоны не конфликтуют с корпоративными сетями и путями доступа к данным.
Сеть требуется и для фонового восстановления. Перенос 1 TB за 40 минут требует полезного потока около 416,7 MB/s, или 3,33 Gbps. Это выше теоретического предела гигабитного соединения ещё до накладных расходов. При расчёте 10/25GbE учитывайте одновременно приложения, репликацию, загрузку образов и восстановление, а также возможности исходных и целевых дисков.
Что полезного показывает маломощный кластер Techno Tim?
В одном практическом проекте используются три компактных Intel NUC с 64 ГБ RAM каждый и NVMe. Control plane, etcd и приложения совмещены на трёх узлах. Для тестового веб-приложения заданы три реплики и разнесение по hostname. При выключении одного узла доступ сохраняется; после выключения второго показанный сценарий теряет доступность.
Этот опыт показывает разницу между «запустить три Pod» и разместить их по разным узлам. Но он не доказывает такую же устойчивость любой базы или локального тома. Также домашняя конфигурация с небольшой нагрузкой не задаёт требования большого производственного control plane.
«Я решил запускать etcd и control plane на тех же узлах, что и рабочие нагрузки».
Techno Tim, перевод пояснения о компактной трёхузловой конфигурации.
Чему учит переносной Kubernetes-кластер через 5G?
Во втором проекте Techno Tim использует три небольших узла с Intel N150, 16 ГБ RAM и SSD 500 ГБ каждый. Кластер RKE2 подключён через мобильную сеть, управление развёртываниями выполняется через Flux, а закрытый доступ и обмен метриками с другим кластером организованы отдельным сетевым решением.
Для аппаратного проектирования здесь важны внешние зависимости: управление, registry, секреты, наблюдение и сеть. Работоспособные узлы без доступа к нужному образу или правильно выданных прав ещё не обеспечивают готовность приложения. При этом переносной лабораторный опыт не является подтверждением заявленного уровня безопасности всей системы или пригодности мобильного канала для etcd между удалёнными площадками.
Не следует растягивать кворум по каналам с большой и нестабильной задержкой только потому, что через них открывается интерфейс управления. Сетевые требования к административному доступу и обмену участников etcd различаются. Разнесённые площадки проектируют по модели отказов и проверенным задержкам.
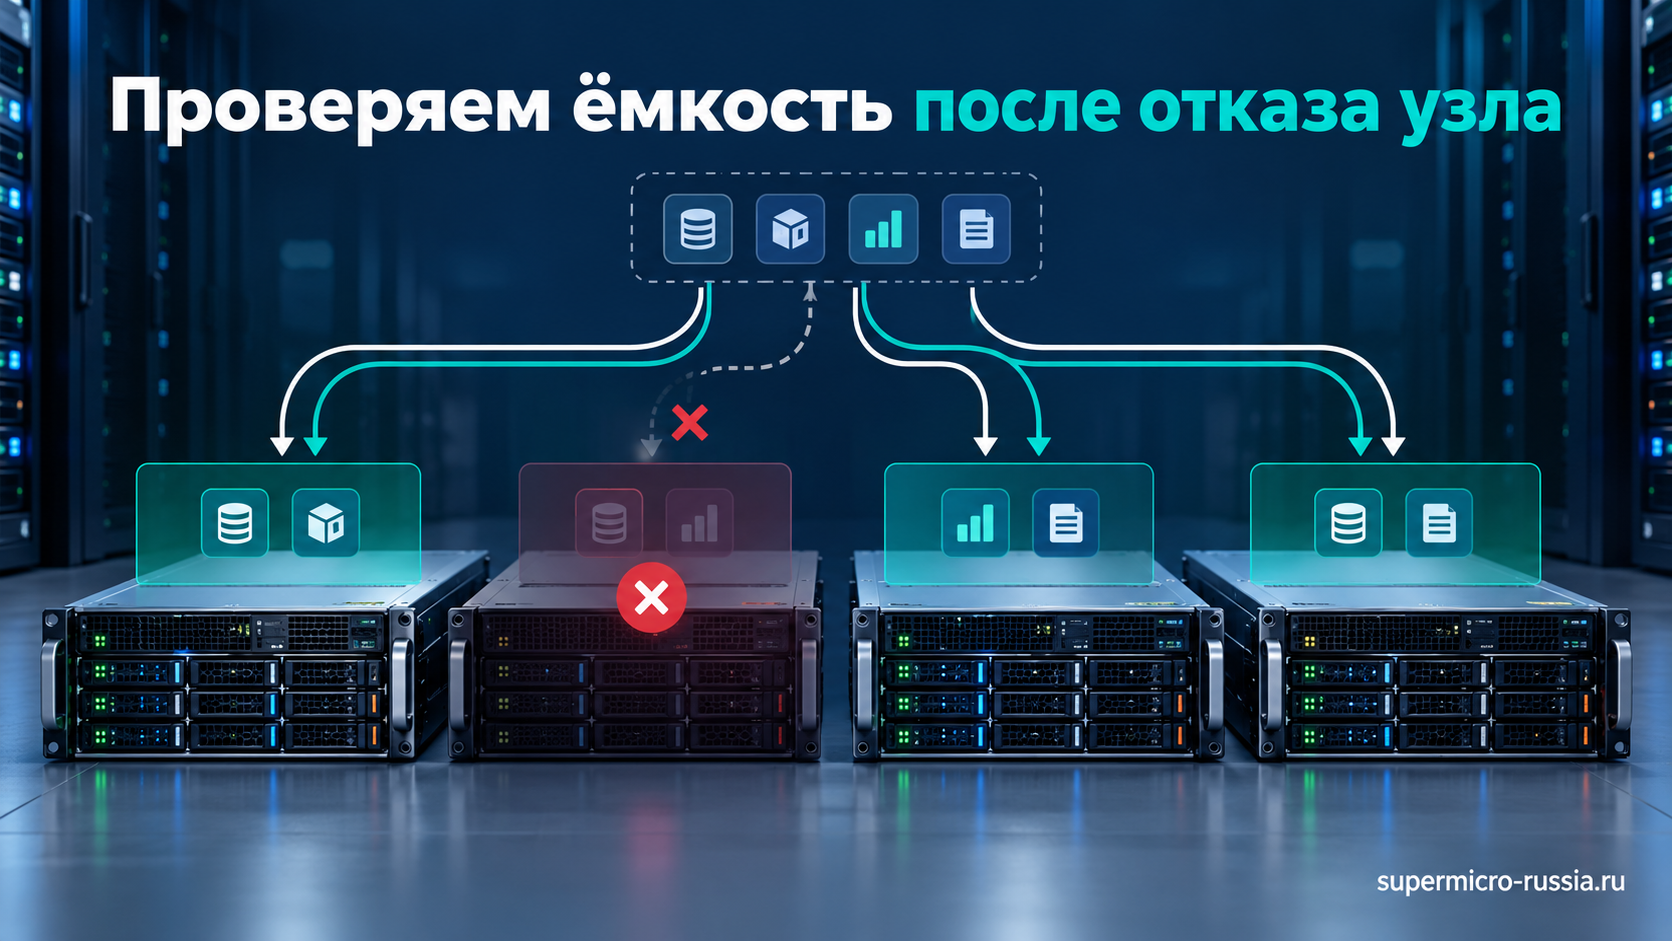
Матрица совместимости серверов и Kubernetes-компонентов
| Компонент | Что подтвердить | Что не считается достаточным |
|---|---|---|
| CPU и ОС | Архитектура, инструкции, ядро, cgroups, поддержка дистрибутива | Общее слово x86 без проверки требований приложения |
| Runtime | Поддерживаемые версии и настройки выбранного Kubernetes | Успешный запуск одиночного контейнера |
| CNI | Ядро, режим сети, MTU, маршруты, политики | Ping между физическими серверами |
| CSI и storage | ОС, драйвер, режим доступа, topology, восстановление | Том монтируется только на одном тестовом узле |
| GPU/SR-IOV | Драйверы, firmware, device plugin, ограничения платформы | Карта видна в PCIe |
| Управление | BMC, удалённая консоль, питание, мониторинг | Доступ по SSH при исправной ОС |
Для смешанных архитектур дополнительно проверяют наличие соответствующих образов и корректное размещение. Для разных поколений CPU — обязательные инструкции приложений. Замена узла на «более новый» не гарантирует одинаковое поведение драйверов, ускорителей и сетевого стека.
Как применить расчёт к Supermicro?
Для worker выбирают платформу с достаточной памятью, нужными NVMe и сетевыми портами, учитывая резерв после отказа. Для control plane важны устойчивые SSD, управляемость и независимость от перегрузки рабочих приложений. Один тип сервера не обязан одинаково хорошо подходить всем ролям.
В каталоге серверов сравнивают полный состав, а при самостоятельной комплектации проверяют материнскую плату, CPU, DIMM, слоты и охлаждение. Для плотных многомодульных систем отдельно учитывают общее питание, backplane, управление и зоны отказа шасси.
Плотную компоновку показывает кейс восьми узлов MicroCloud. Для Kubernetes отдельно рассчитывают общие питание, backplane и сеть шасси: восемь узлов внутри одной системы не образуют восемь независимых площадок.
Подбирая серверы через каталог Supermicro, передайте ресурсную ведомость и сценарии отказа. До заказа проверьте не только суммарную вместимость, но и размещение самых крупных Pod.
Как автоматизация установки меняет требования к серверу?
В новой демонстрации NKP Metal сначала подключаются интерфейсы внеполосного управления, задаются сетевые параметры и образ ОС, затем хосты попадают в управляемый пул. В показанной схеме из семи серверов три выбираются для control plane и четыре — для workers. Это конкретный пример распределения ролей, а не минимальное требование Kubernetes.
Для такого развёртывания заранее проверяют BMC, firmware, NIC, накопители и образ ОС. Демонстрация NKP не подтверждает совместимость произвольной платформы Supermicro: нужна матрица выбранного продукта.
До ввода подготовьте порядок замены узла: идентификация неисправной машины, исключение из работы, сохранность данных, установка согласованного образа, выдача нужной роли и возврат нагрузки. Развёртывание образа может перезаписать диски, поэтому процедура должна однозначно выбирать целевое устройство и учитывать локальные тома.
Как проверить кластер перед запуском приложений?
Сначала сверяют физические ресурсы, Allocatable, системные Pod, состояние накопителей и фактический сетевой путь. Затем запускают репрезентативную нагрузку, одновременно наблюдая приложения и инфраструктуру. Команда top показывает текущий снимок, поэтому для выбора железа нужны временные ряды, пики и длительность событий.
kubectl get nodes -o wide
kubectl describe nodes
kubectl get pods -A -o wide
kubectl top nodes
kubectl top pods -A
kubectl get events -A --sort-by=.lastTimestamp
Для top требуется работающий источник resource metrics. Эти команды помогают наблюдению, но не рассчитывают автоматически правильные requests. Также проверяют журнал kubelet/runtime, ошибки дисков и NIC, а для etcd — метрики подтверждённой записи и состояние участников.
Испытания отказов проводят на согласованном стенде: потеря worker, останов участника control plane, недоступность хранилища, обрыв сетевого пути и возврат оборудования. Плановое обслуживание и внезапный отказ проверяют отдельно. PodDisruptionBudget помогает ограничивать добровольные нарушения при обслуживании, но не предотвращает аппаратный отказ.
Что считать успешным испытанием отказа и возврата узла?
Тест не заканчивается появлением Ready у replacement-узла. Сначала проверяют доступность сервиса и сохранность данных во время отказа, затем — распределение нагрузки после переразмещения. После возврата наблюдают прогрев, загрузку образов, восстановление реплик и конкуренцию за сеть и накопители. В некоторых системах именно восстановительная работа создаёт самый тяжёлый период.
Для каждого сценария задают временную шкалу: момент потери, обнаружение, начало восстановления, готовность необходимых реплик и восстановление нормального отклика. Таймер обнаружения и запуск контейнера — только части полного времени недоступности. В StatefulSet добавляются правила доступа к томам и поведение приложения, поэтому результат для stateless-веб-службы нельзя переносить на базу данных.
Наконец, различайте сохранение управления и сохранение уже запущенных процессов. Потеря кворума etcd нарушает работу управляющих операций, но не означает мгновенную остановку каждого контейнера на исправных worker. Тем не менее кластер с недоступным управлением нельзя считать полностью работоспособным: новые размещения и часть восстановительных действий будут ограничены. В акте приёмки нужны оба измерения — пользовательский сервис и состояние control plane.
Как проверять восстановление Kubernetes после потери площадки?
Для потери площадки нужен отдельный сценарий с конфигурациями, ключами, образами, копиями etcd и прикладных данных. Снимок etcd восстанавливает состояние объектов Kubernetes, но не содержимое внешней базы или PersistentVolume.
Последовательность восстановления должна учитывать инфраструктуру: управление серверами, сеть и DNS, control plane, сетевой и дисковый плагины, доступ к образам и затем приложения. Порядок зависит от выбранной архитектуры. Его проверяют в среде, где недоступные зависимости действительно отключены, а не продолжают незаметно обслуживаться с основной площадки.
Для критичного приложения измеряют время до успешной бизнес-операции после возврата сервиса, а не до появления статуса Running у Pod. В проверку входят целостность данных, права доступа, маршрутизация и возобновление наблюдаемости. Readiness-проба полезна, но только если она проверяет то, что требуется для реальной обработки запроса.
Запас на потерю worker, на обслуживание и на восстановление площадки учитывают раздельно. Один свободный ресурс нельзя целиком обещать нескольким сценариям, которые могут совпасть.
Программа приёмки Kubernetes-кластера
| Проверка | Что измерить | Критерий |
|---|---|---|
| Нормальная нагрузка | Отклик приложения, CPU, RAM, диски, сеть | Выполнены прикладные цели с предусмотренным резервом |
| Пиковый запуск и обновление | Загрузка образов, прогрев, maxSurge, Pending | Обновление завершается без нехватки ресурсов |
| Потеря worker | Переразмещение, доступность томов и время возврата | Согласованный аварийный режим выполняется |
| Control plane и etcd | API latency, запись etcd, смена лидера | Сохраняется предусмотренный кворум и управление |
| Нагрузка хранения | Приложения одновременно с репликацией/rebuild | Нет недопустимой деградации и переполнения |
| Восстановление | etcd, конфигурация и данные приложения | Проверенная рабочая операция после возврата |
Результат сохраняют вместе с версиями Kubernetes, runtime, CNI, CSI, ОС, firmware и ресурсной ведомостью. После добавления тяжёлых операторов, изменения хранилища и увеличения реплик расчёт обновляют. Производственная вместимость кластера — проверяемое состояние системы, а не постоянное свойство названия сервера.
Как собрать ведомость для запроса конфигурации Kubernetes?
- Число ролей и узлов, допустимые зоны отказа и сценарий обслуживания.
- Requests и реальное потребление приложений, крупнейший Pod, replicas и maxSurge.
- ОС, runtime, CNI, CSI, драйверы GPU и необходимые инструкции CPU.
- Объём образов, журналов, локальных данных и срок хранения.
- Постоянное хранение, репликация, резервные копии и требуемое время восстановления.
- Скорость сети, MTU, адресный план, путь к registry и внешним зависимостям.
- BMC, питание, охлаждение, поддержка автоматизированной установки и замены.
Частые вопросы о серверах Kubernetes
Можно ли совместить control plane и workers?
В определённых конфигурациях можно, но тогда нужно учитывать taints, конкуренцию ресурсов, нагрузку etcd и последствия отказа. Для рабочей системы это отдельное проектное решение, а не следствие наличия трёх машин.
Почему свободная RAM есть, а Pod вытесняются?
Проверьте давление на ephemeral storage, память на уровне нужного узла, настройки kubelet и события. Суммарный показатель кластера может скрывать локальную проблему.
Нужен ли всем узлам одинаковый CPU?
Не обязательно. Разные пулы могут выполнять разные задачи. Но приложения, образы, инструкции, драйверы и правила размещения должны соответствовать каждому классу узлов.