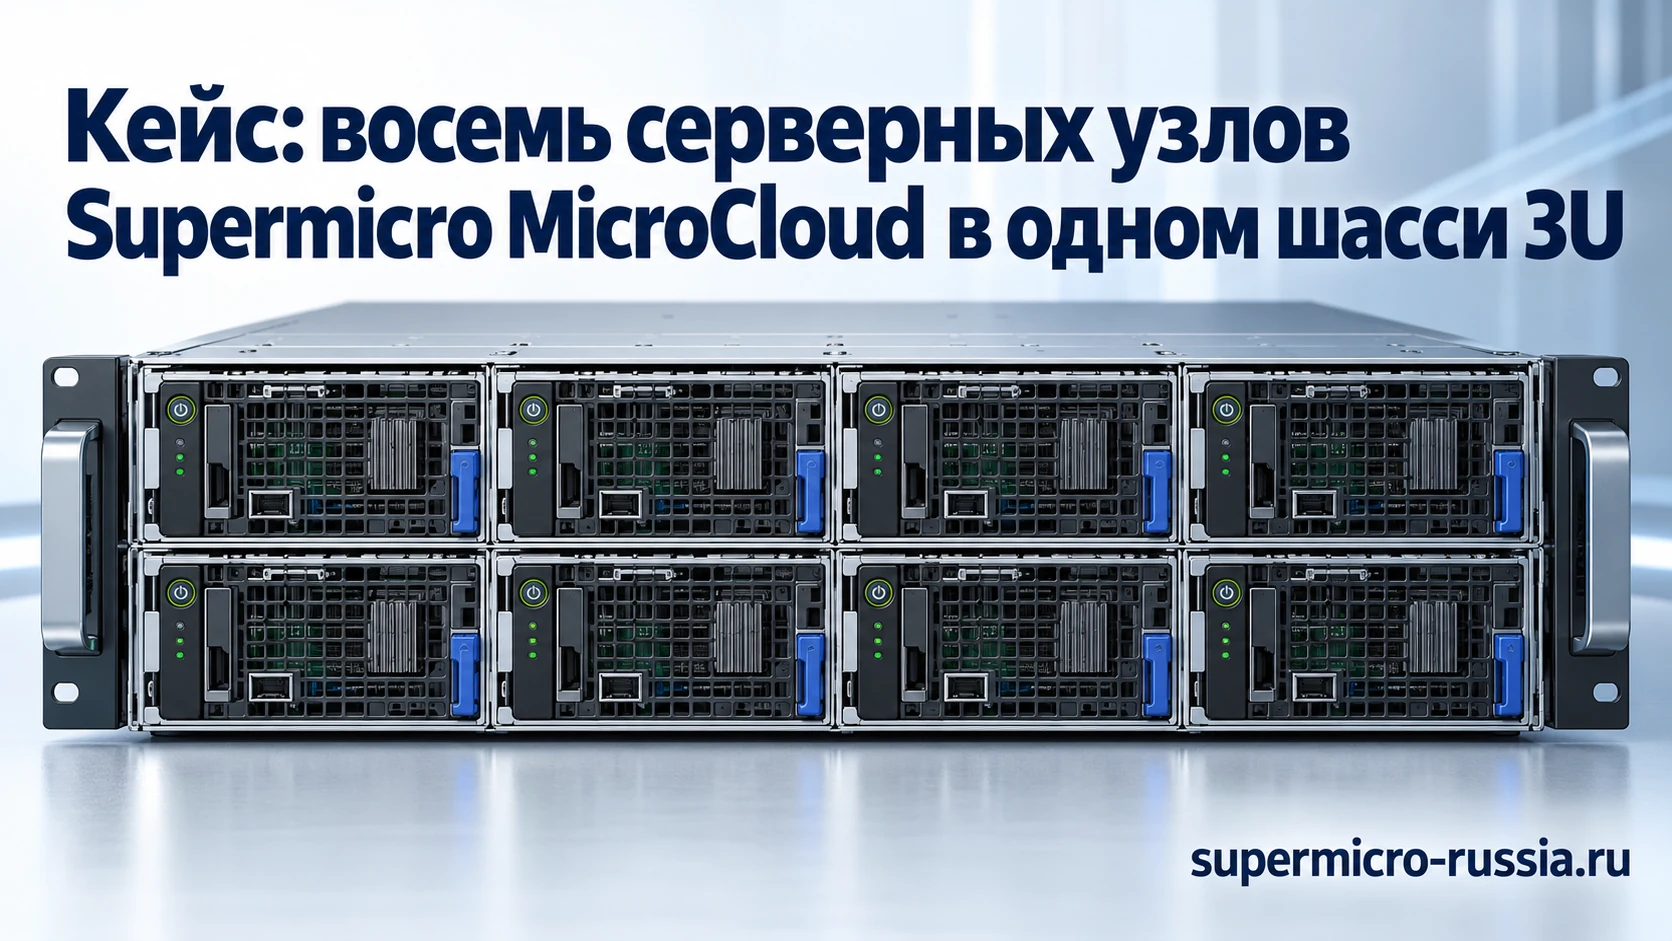
Кейс: восемь серверных узлов Supermicro MicroCloud в одном шасси 3U
Восемь независимых серверов в 3U — это не восемь виртуальных машин на большой плате. У каждого узла Supermicro MicroCloud собственные CPU, память, загрузка и операционная система. Такая компоновка интересна лаборатории, где нужно испытывать отказ узла, обновления кластера и распределённые приложения. В этом кейсе разбираем Supermicro SYS-5037MR-H8TRF с восемью X9SRD-F и считаем, какие ресурсы действительно получает инженер.
Практический пример — серия Craft Computing: сначала покупка восьмиузловой платформы, затем её эксплуатация и обсуждение модернизации. Исторические 399 долларов из названия первой публикации — цена конкретной покупки автора, а не текущая стоимость сервера, памяти, дисков и всей лаборатории. Наши примеры распределения ролей и N+1 ниже не являются составом его работающего кластера.
Зачем лаборатории восемь физических узлов
Один мощный хост с большим количеством ВМ удобен для разработки приложений. Но если требуется проверить потерю питания одного сервера, обновление его BIOS или особенности сетевого адаптера, восемь ВМ всё равно зависят от одной физической машины. Многоузловая лаборатория переносит часть этих границ в настоящее оборудование.
Инженер может выключить отдельный узел, загрузить другую ОС, проверить миграцию и оставить остальные машины работающими. Это полезно для обучения администраторов, CI-сред, экспериментов с оркестрацией и испытаний процедур резервного копирования. Физическая независимость узлов делает сценарии реалистичнее, но общее шасси сохраняет важные общие риски.
Лаборатория отличается от производственного кластера целями. В лаборатории допустим эксперимент с отказом, который намеренно останавливает тестовую службу. В производстве нужен согласованный уровень доступности. Нельзя превратить первое во второе одной установкой гипервизора и словом «кластер».
Как устроена исходная MicroCloud
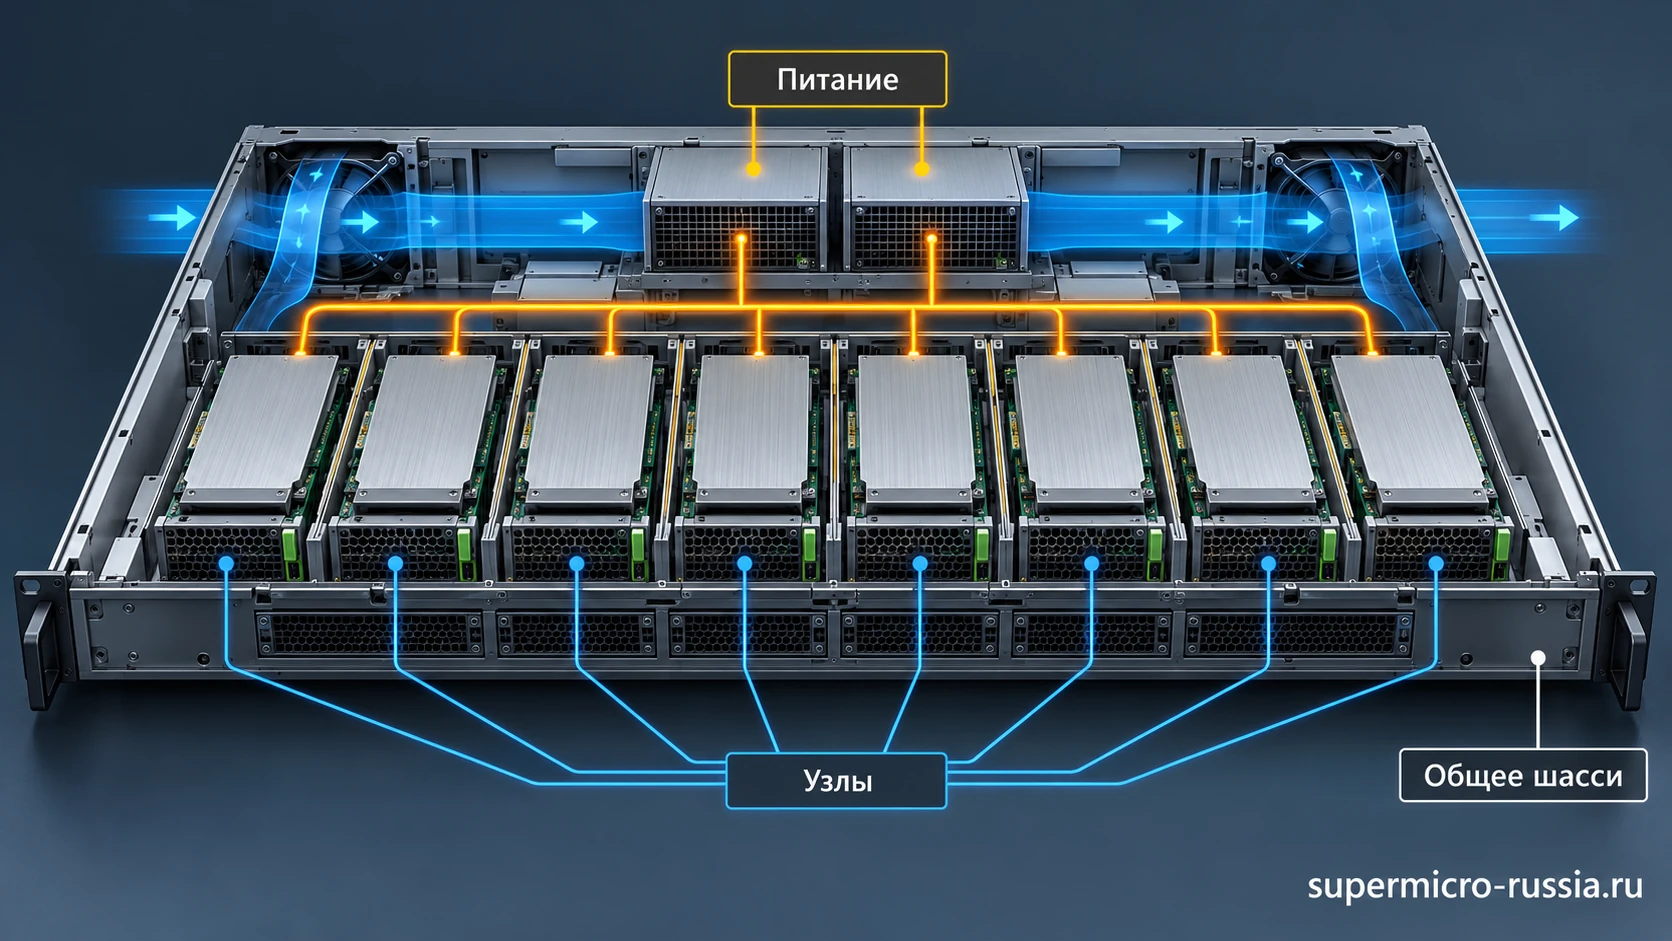
SYS-5037MR-H8TRF объединяет восемь однопроцессорных узлов на Supermicro X9SRD-F. У каждого LGA2011 с поддержкой соответствующих Xeon E5-2600/E5-2600 v2, четыре слота DDR3, два дисковых подключения, два рабочих гигабитных сетевых порта и отдельное управление IPMI. Для CPU v2 требуется подходящая версия BIOS; сам сокет не подтверждает готовность к установке.
Максимум памяти на узел — до 128 ГБ ECC RDIMM либо до 32 ГБ ECC UDIMM в поддерживаемом составе. Это разные классы модулей, их не смешивают. У восьми узлов по 128 ГБ арифметически получится 1024 ГБ установленной памяти, но ни одна обычная ВМ не получит автоматически единый терабайт: она работает в памяти выбранного хоста.
Шасси имеет общие вентиляторы и резервируемые БП класса 1620 Вт. Их количество не означает простого удвоения доступной мощности при требовании пережить отказ одного модуля. Расчёт выполняется по режиму резервирования, входному напряжению и реальному потреблению всех узлов.
| Ресурс | Граница одного узла | Что остаётся общим |
|---|---|---|
| CPU и RAM | Собственные процессор и DIMM | Сумма ресурсов не превращается в один большой сокет |
| Загрузка ОС | Собственная операционная система | Процедуры администрирования можно централизовать |
| Данные | Локальные накопители узла | Общее хранилище появляется только при отдельном проектировании |
| Рабочая сеть | Два 1GbE-порта | Коммутаторы, uplink и кабельная инфраструктура |
| IPMI | Управление конкретной платой | Сеть управления и её доступность |
| Питание и воздух | Собственная нагрузка узла | БП, шасси и корпусные вентиляторы |
Как распределить роли восьми машин
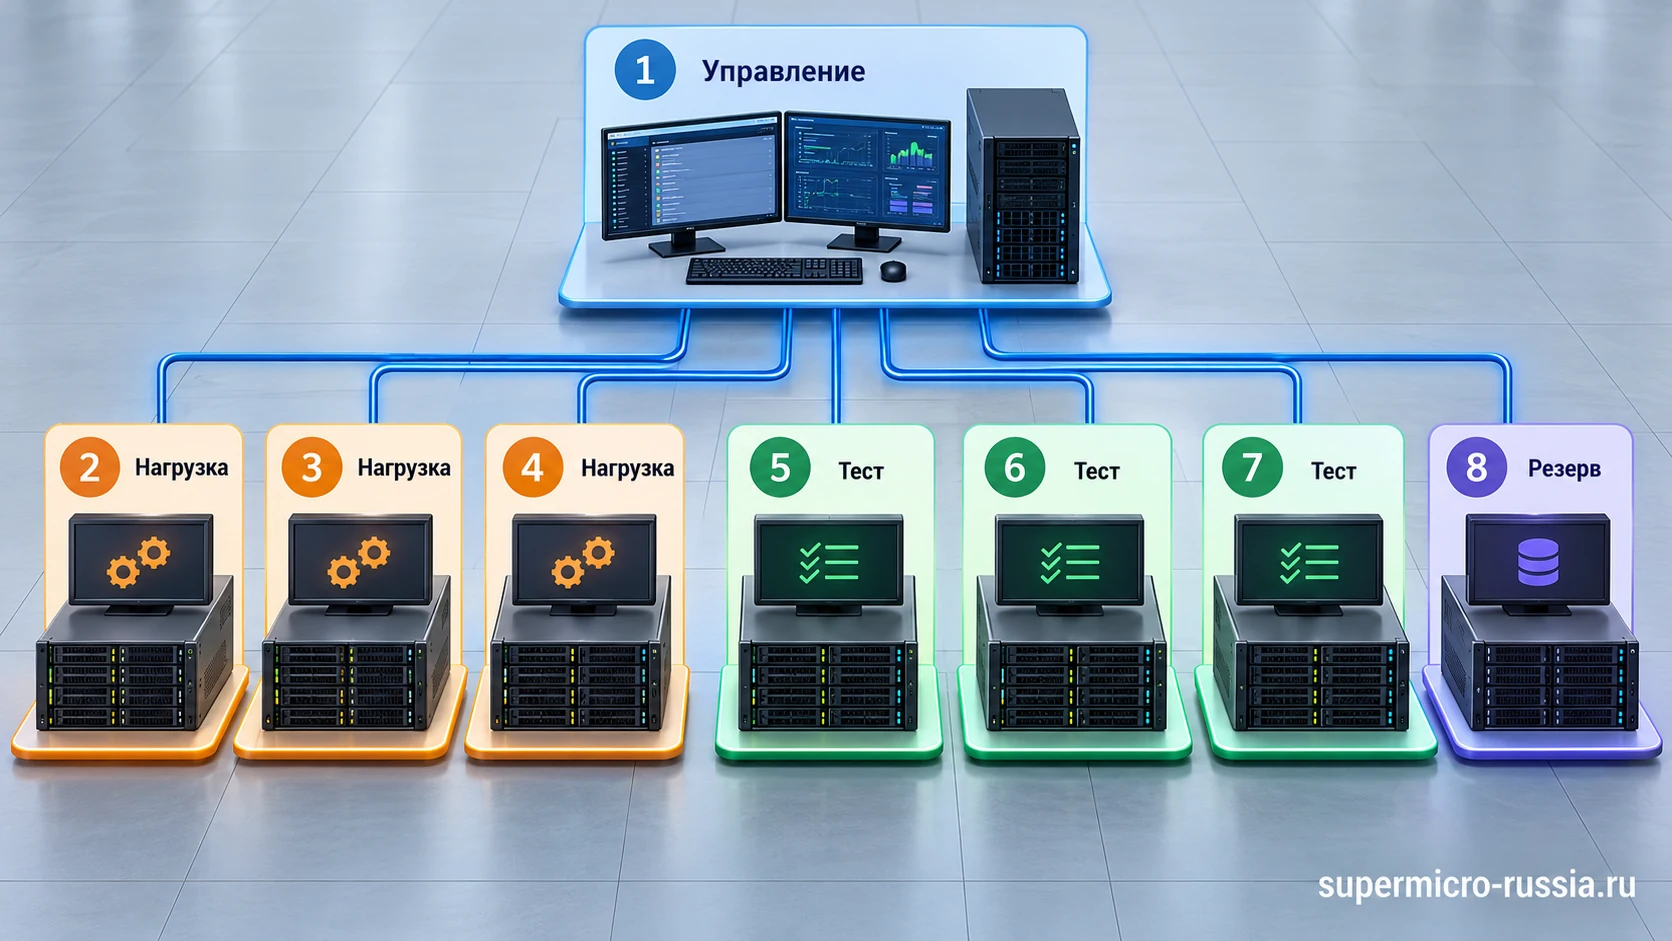
Не обязательно делать все узлы одинаково занятыми. Для прикладной лаборатории возможен проектный вариант: один узел управления, три узла основного тестового контура, три узла экспериментального контура и один резервный. На резервном проверяют новую ОС или временно размещают нагрузку обслуживаемой машины. Это пример, а не обязательная схема Craft Computing.
Разделение контуров помогает не смешивать проверку приложения и изменение самой инфраструктуры. Если обновляются гипервизор, драйвер и приложение одновременно, при сбое трудно найти причину. Отдельный стенд позволяет воспроизвести изменение на малой части среды и сохранить контрольную конфигурацию.
Службы управления тоже требуют плана отказа. Если единственная DNS, аутентификация и документация находятся на узле, который инженер собирается выключить, испытание быстро потеряет управляемость. Минимальные сведения для восстановления хранят вне кластера; административный доступ не должен зависеть исключительно от тестируемого приложения.
Как посчитать доступную память с запасом N+1
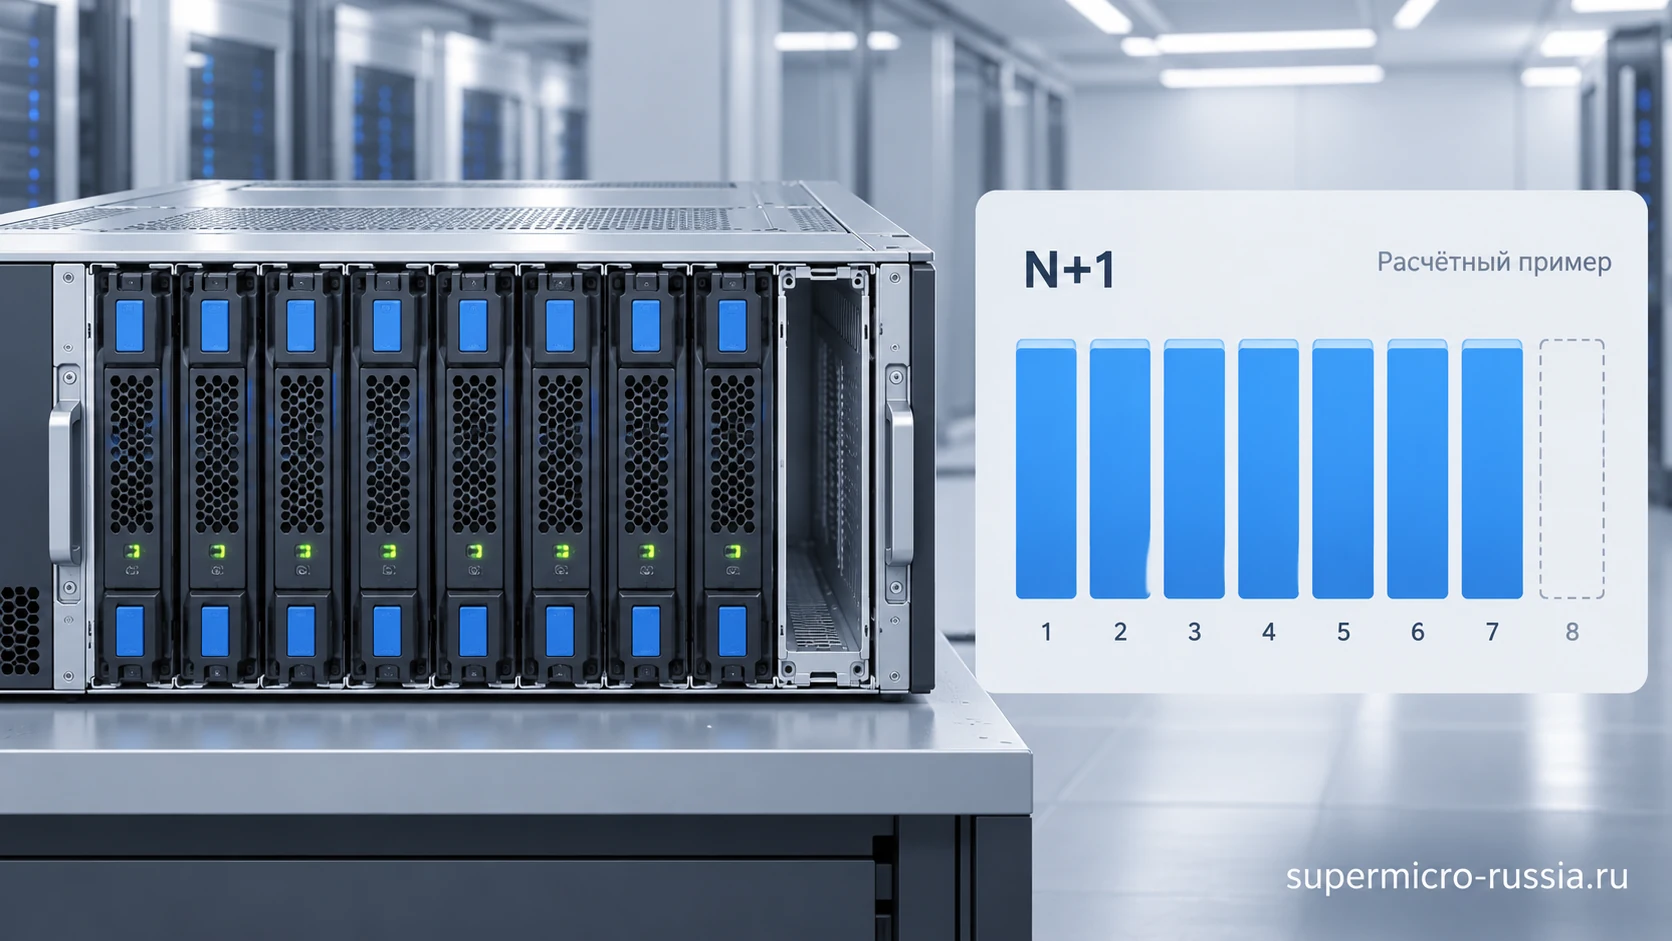
Возьмём отдельный расчётный состав: восемь узлов по 64 ГБ, из которых на каждом 8 ГБ оставлены хосту и служебным процессам. Общая установленная память — 512 ГБ, обычный гостевой бюджет — 8 × 56 = 448 ГБ. Для размещения всей нагрузки после потери одного узла остаётся 7 × 56 = 392 ГБ.
Таким образом, заполнить все 448 ГБ гостями и одновременно обещать N+1 нельзя. При равномерном распределении предел занятого гостевого бюджета — 392 ГБ до дополнительного эксплуатационного резерва. Для N+2 он уменьшится до 6 × 56 = 336 ГБ. Это только память: CPU, диски и сеть проверяются отдельно.
| Режим расчётного стенда | Установлено | Бюджет гостей после вычета памяти хоста | Ограничение |
|---|---|---|---|
| Все восемь узлов работают | 512 ГБ | 448 ГБ | Запаса под потерю узла ещё нет |
| N+1 | Физически прежние 512 ГБ | Не более 392 ГБ для сохраняемой нагрузки | Один узел недоступен |
| N+2 | Физически прежние 512 ГБ | Не более 336 ГБ | Два узла недоступны |
Даже при достаточной сумме памяти конкретная ВМ должна помещаться на одном допустимом целевом узле. Если её рабочее выделение 96 ГБ, стенд из 64-гигабайтных машин ей не подходит. Наличие свободных 16 ГБ на шести узлах не складывается в 96 ГБ для одной обычной гостевой машины.
Общий алгоритм расчёта ВМ отдельно разобран в статье о CPU и RAM для виртуализации. Здесь его дополняет физическое ограничение: способность разместить нагрузку после изменения числа работающих серверов.
Сколько портов коммутатора потребуется
При подключении обоих рабочих интерфейсов каждого узла понадобится 16 портов. Для восьми отдельных IPMI добавятся ещё восемь — всего 24 подключения до uplink, рабочего места администратора и внешнего хранилища. Поэтому «всё помещается в 3U» не означает, что вся лаборатория помещается в один корпус без дополнительной сети.
Один 1GbE-порт имеет теоретическую границу 125 МБ/с до накладных расходов. Для передачи 32 ГБ памяти это минимум около 256 секунд, если условно передать только эти байты по полностью свободной линии. Живая миграция сложнее: память меняется во время переноса, часть страниц отправляется повторно, есть служебный трафик и дисковые данные.
Два интерфейса не гарантируют 2 Гбит/с для одного потока. Их можно использовать для раздельных сетей или избыточности при подходящей схеме, но агрегирование проверяется по реальному распределению соединений. Для испытаний распределённого хранения гигабитная сеть может стать главным ограничением задолго до заполнения CPU.
Нужны как минимум понятные границы сети управления, рабочей сети гостей и трафика миграции/хранения. Выделенные VLAN помогают логическому разделению, но не создают дополнительную физическую пропускную способность. На одном занятом uplink разные VLAN продолжают конкурировать за один канал.
Какие отказы лаборатория действительно позволяет проверить
Остановка одного узла полезна для проверки выбора лидера, повторного запуска ВМ и поведения распределённого приложения. Отдельная загрузка помогает испытать обновление ОС или гипервизора. Изъятие тестового локального диска проверяет процедуру восстановления именно этого узла, если такой эксперимент допустим и заранее подготовлен.
Но отказ общего шасси, общей цепи питания или охлаждения может затронуть сразу все восемь машин. Разместить три копии данных на трёх узлах одной MicroCloud — лучше, чем на одном узле для некоторых отказов, но это не защита от потери всего корпуса. Границы отказов должны совпадать с теми событиями, от которых требуется защита.
Резервируемые БП не устраняют общий PDU, а два порта не устраняют единственный коммутатор. Для настоящей независимости нужны соответствующие источники и маршруты. Поэтому материал не обещает производственную отказоустойчивость только на основании числа узлов.
Как организовать диски и резервные копии
Два локальных диска узла позволяют спроектировать загрузку и хранение, но не задают автоматически резервирование. Если оба отдать под разные независимые роли, зеркала не появится. Если объединить в зеркало, полезный объём будет равен меньшему из дисков, а бэкап всё равно останется отдельной задачей.
Общее хранилище может упростить миграцию, но добавляет сетевой путь и зависимость от внешней системы. Распределённое хранилище на самих узлах требует отдельного расчёта репликации, сети и восстановления. Не следует выбирать его только потому, что «узлов много» и программа допускает установку.
Для лаборатории часто разумно разделить ценное и воспроизводимое. Образы ОС и тестовые результаты можно создать снова; инфраструктурный код, секреты, конфигурации и уникальные данные требуют надёжной внешней копии. Резерв на другом узле того же шасси полезен при локальном отказе, но не покрывает потерю всей MicroCloud.
Почему старое поколение требует проверки ПО
У платформы X9 — DDR3 и процессоры поколения E5-2600/v2. Их возможности и требования современных гипервизоров нужно проверять по конкретной версии. Факт успешного запуска старой ОС не доказывает поддержку нового установщика, драйверов и всех функций виртуализации.
Совместимость CPU важна и для миграции. Если в шасси постепенно появляются разные поколения узлов, одинаковое название кластера не делает наборы инструкций одинаковыми. Выбирают поддерживаемый общий CPU-профиль либо ограничивают миграцию подходящими группами, понимая возможные потери функций.
В продолжении исходной серии обсуждаются X10SRD-F и X10SDD-F. Это не означает, что любая такая плата механически и электрически заменяет X9SRD-F. Проверяется совместимость именно узла в сборе: разъёмы, райзер, охлаждение, дисковые соединения и питание. Для программной части полезен отдельный чек-лист совместимости ESXi и Proxmox.
Как сделать лабораторию воспроизводимой
Одинаковые установки вручную быстро расходятся. На одном узле забывается настройка сети, на другом — версия пакета, на третьем — старый ключ. Для каждого сервера сохраняют инвентарную карточку: плата, BIOS/BMC, CPU, DIMM, диски, MAC, адреса, порты коммутатора и назначение.
Базовую конфигурацию лучше описывать автоматизируемым способом, а изменения — журналировать. После переустановки узел должен возвращаться к заданному состоянию без поиска команд в личной переписке. Тест считается воспроизводимым, когда другой инженер понимает исходную конфигурацию и способен повторить сценарий.
Управление BMC организуют отдельно, с уникальными учётными данными и ограниченным доступом. Старая удалённая консоль может иметь требования к клиентскому ПО; это проверяют до размещения сервера в недоступной стойке. Работоспособность SSH в ОС не заменяет проверку доступа при её полном отказе.
Как оценить электричество и охлаждение восьми узлов
Экономия места не означает низкое потребление. Для проектного примера средние 70 Вт на узел дадут 560 Вт до учёта той части общих нагрузок, которая не включена в измерение. Если итог на входе всего шасси окажется 650 Вт, за год 24/7 получится 5694 кВт·ч. Это сценарный расчёт, не измерение исходной MicroCloud.
Измерять выгодно несколько режимов: восемь узлов в простое, обычная лабораторная работа и длительный стресс. Для редко используемого стенда расписание включения способно дать больший эффект, чем тонкая настройка одного CPU. Но механика питания и удалённого запуска должна поддерживать выбранный режим.
Общие вентиляторы реагируют на тепловой профиль системы. Установка горячего экспериментального узла может повлиять на акустику всего корпуса. Для размещения рядом с людьми такую платформу сначала измеряют, а не выбирают по плотности 3U.
Что показало продолжение проекта с другими узлами MicroCloud
В январе 2026 года Craft Computing вернулся к проекту и испытал два дополнительных узла: X10SRD-F с сокетным Xeon поколения v3/v4 и вариант на Xeon D-1541. Это важное продолжение исходной идеи: вместо обещания «поставлю ВМ позже» появился опыт эксплуатации и сравнения нескольких вариантов. При этом смешивание узлов в одном шасси остаётся авторским экспериментом; одинаковый разъём питания не заменяет официальную матрицу совместимости.
Один из новых узлов получил Xeon E5-2696 v3 и 128 ГБ DDR4. Второй — интегрированный D-1541 с 8 ядрами и 16 потоками и также 128 ГБ RAM. Для D-платформы автор отдельно выделяет возможность установки нескольких NVMe. Практический выбор здесь зависит не только от процессора: переход с DDR3 на DDR4 требует других DIMM, а другой BMC меняет способ удалённой работы с узлом.
Главный эксплуатационный замер относится к четырём уже работающим узлам: примерно 280 Вт из розетки. В состав входили три E5-2651 v2 и один E5-2667 v2, две Intel Arc A310, шесть SATA SSD по 1,2 ТБ, два M.2 SATA SSD по 240 ГБ, пара HDD по 8 ТБ и Sun F80. Арифметическое среднее составляет 70 Вт на узел, но это не индивидуальное измерение каждого сервера и не результат восьми полностью загруженных машин.
Если использовать 280 Вт как постоянную расчётную мощность, получится около 2453 кВт·ч за год непрерывной работы. Нельзя просто удвоить это число и объявить расход восьми узлов: общие вентиляторы, эффективность БП и распределение нагрузки изменятся. Для собственной лаборатории измеряют минимум три режима — работающие сервисы, параллельный тест нескольких узлов и выключенные вычислительные модули при оставшемся питании шасси.
В продолжении обнаружилась и диагностическая ловушка: один неисправный DIMM не позволял узлу пройти POST. Из этого не следует, что все проблемы запуска связаны с памятью. Но перед миграцией рабочих ВМ следует проверить каждый модуль и канал, а также загрузку после полного выключения. Настройки загрузчика и доступ к USB-носителю у разных поколений узлов могут вести себя по-разному.
Этот результат поддерживает исходную цель проекта: несколько небольших машин для конкретных сервисов и отдельного полигона. Он не подтверждает универсальное превосходство старого шасси над одним EPYC. Производительность одного потока, возможности NVMe, управление, стоимость памяти и общие точки отказа остаются самостоятельными критериями.
Как провести испытание N+1 без потери рабочих данных
- Выделить тестовый контур и подтвердить внешнюю копию конфигураций и данных.
- Зафиксировать нормальную загрузку CPU, память, сетевой поток и задержки приложений.
- Проверить, что все сохраняемые ВМ помещаются на оставшихся узлах по отдельности и суммарно.
- Остановить один тестовый узел согласованным способом и измерить фактическое время восстановления службы.
- Проверить не только запуск ВМ, но и корректность приложения, данных, DNS и зависимостей.
- Вернуть узел, дождаться завершения синхронизаций и оценить влияние обратного переноса.
- Описать результат, включая то, какие общие отказы испытание не покрывало.
Что можно изучать на настоящих физических границах
Многоузловой стенд удобен для экспериментов с кворумом. В упрощённой системе из восьми равноправных голосующих участников большинство — пять. После потери одного остаётся семь, но при разделении на две группы по четыре ни одна не получает большинства. Это пример логики голосования, а не описание автоматически настроенного механизма данной MicroCloud.
В разных кластерных продуктах число голосов, роль внешнего арбитра и поведение при потере связи различаются. Поэтому на стенде полезно проверять именно используемое ПО, а не переносить общую формулу без настройки. Кворум разрешает определённые действия управления, но не создаёт дополнительную копию данных и не добавляет свободную RAM.
Одна из ценных учебных проверок — отличить потерю узла от потери связи с узлом. Во втором случае машина может продолжать исполнять приложение. Если запустить вторую копию с теми же дисками без предусмотренного механизма защиты, возникает риск одновременной записи. Правила перезапуска и изоляции определяются кластерной системой; самостоятельная импровизация здесь не заменяет штатную процедуру.
Именно такие сценарии труднее показать на восьми ВМ одного хоста. Но общий коммутатор лаборатории тоже нужно учитывать: его перезапуск может одновременно разорвать управление всеми узлами и имитировать совсем другой масштаб события, чем планировалось.
Как поставить воспроизводимый опыт с миграцией
Выбирают одну тестовую ВМ с известным объёмом памяти и диска. Сначала измеряют перенос в простое, затем при нагрузке, которая активно меняет память, затем при обычном прикладном профиле. Сравнивают не только общую длительность, но и паузу доступности приложения, потери запросов и нагрузку на сеть.
При 1GbE даже идеальная передача 100 ГБ дисковых данных занимает минимум около 800 секунд, то есть 13 минут 20 секунд. Служебные расходы и соседний трафик увеличивают срок. Если диски общие и переносятся только состояния памяти, профиль другой. Поэтому запись «миграция заняла пять минут» без условий почти бесполезна для планирования.
В pre-copy-подобном сценарии скорость изменения памяти тоже важна. Если гость меняет страницы быстрее, чем доступный тракт успевает их передавать, перенос не сможет завершиться так же легко, как у почти простаивающей ВМ. Условные 150 МБ/с изменений уже превосходят сырую границу одного гигабитного порта в 125 МБ/с. Это поясняющий пример, не измерение MicroCloud.
После переноса проверяют время внутри гостя, сетевые соединения и работу приложения. Сам факт появления ВМ в списке другого хоста не доказывает корректного завершения операции. В журнал опыта заносят версии гипервизора, общий CPU-профиль и состояние внешнего хранилища.
Как использовать узлы для CI и проверки обновлений
Восемь независимых машин позволяют держать несколько эталонных окружений. Например, один контур использует текущую версию ОС, другой — следующую, а резервный узел переустанавливается для воспроизведения ошибки. Для CI важно, чтобы после задания узел или ВМ возвращались в известное состояние и не переносили остаточные данные между проектами.
Кэш пакетов, сборочные артефакты и секреты имеют разные правила хранения. Ускорение сборки за счёт общего кэша полезно, но право изменения такого кэша должно быть ограничено. Иначе тест одного проекта способен повлиять на следующий. Для внешнего кода выделяют соответствующий уровень изоляции и не дают доступ к сети управления BMC.
Планировщик заданий должен учитывать предел отдельного узла. Восемь серверов с небольшим объёмом RAM хорошо обслуживают независимые сборки, но одно задание, требующее 200 ГБ памяти, на них не поместится без специально распределённой реализации. Число исполнителей и размер крупнейшего задания — два разных требования.
Для честного сравнения времени сборки используют одинаковые исходники, зависимости и состояние кэша. Холодная первая сборка и повтор с заполненным кэшем не являются сопоставимыми результатами. Многоузловая лаборатория особенно полезна тем, что позволяет сохранить контрольную машину неизменной.
Когда лабораторию выгодно включать по расписанию
Если стенд нужен только для обучения и коротких экспериментов, постоянная работа может быть лишней. Возьмём прежний условный итог 650 Вт на входе шасси. При 12 часах работы в неделю это 624 часа в год и около 405,6 кВт·ч, без учёта потребления выключенного/дежурного состояния. При 24/7 было бы 5694 кВт·ч.
Такая разница не означает, что именно эту систему обязательно следует выключать. Постоянные службы, удалённые задания и расписание копий могут требовать другого режима. Но электричество и выделение тепла нужно сравнивать с фактическими часами использования, а не заранее умножать любой стенд на 8760 часов.
Перед автоматическим выключением проверяют завершение заданий, состояние ВМ и синхронизаций, а перед включением — порядок старта зависимостей. Нужен доступ к BMC, который сохраняется в предусмотренном дежурном режиме. Расписание без контроля состояния способно прерывать самые длинные тесты.
Как передать лабораторию следующему инженеру
Узлы маркируют одинаково в физической стойке, IPMI, гипервизоре и системе мониторинга. Если node-03 в одном интерфейсе соответствует пятому отсеку в другом, вероятность ошибки при выключении растёт. Карта соответствий должна быть простой и проверенной на месте.
Сохраняют эталон конфигурации, процедуру очистки тестовых данных и порядок возврата в исходное состояние. Для каждого сценария отказа заранее записывают ожидаемый результат и безопасный выход. Это особенно полезно при обучении: эксперимент заканчивается восстановленной лабораторией, а не набором машин с неизвестной историей настроек.
Готовность стенда определяется тем, что он позволяет повторить нужные опыты и объяснить результат. Плотность восемь узлов в 3U — сильное аппаратное свойство, но полезная лаборатория появляется только вместе с сетью, инвентаризацией, запасом ресурсов и воспроизводимыми процедурами.
Частые вопросы о MicroCloud как лаборатории
Восемь узлов быстрее одного большого сервера?
Для независимых задач суммарная производительность может быть полезна. Но обычная программа одного узла не получает CPU и RAM соседних автоматически. Для единственной крупной ВМ или плохо распараллеливаемого приложения один современный хост может подходить лучше.
Можно ли назвать такую систему отказоустойчивой?
Только после определения границ отказов и настройки конкретных механизмов. Несколько физических узлов помогают пережить отдельные события, но общее шасси остаётся общим риском. Уровень доступности подтверждают испытанием прикладного сервиса.
Стоит ли повторять покупку из ролика ради низкой цены?
Историческая цена автора не описывает текущий рынок и полный бюджет. Нужно учитывать память, накопители, сеть, электричество, обслуживание и программную совместимость. Если стенд нужен для постоянной работы, сравнивают полную стоимость, а не только стоимость корпуса.
Что указать для подбора лаборатории?
Число физических границ отказа, размеры крупнейших ВМ, нужные ОС, сценарии миграции, сеть и ограничения стойки. На этой основе выбирают плотную платформу либо несколько отдельных серверов Supermicro. Выбор должен обеспечивать нужные эксперименты и понятное восстановление после них.