Как выбрать сервер для базы данных: PostgreSQL и SQL Server под реальную нагрузку
Сервер для баз данных подбирают по активному набору данных, характеру запросов и допустимой задержке. База 1 ТБ с редко читаемым архивом может создавать меньшую нагрузку, чем 200 ГБ с постоянной записью и тяжёлыми отчётами.
Подключения, ядра и объём файла базы нельзя напрямую пересчитать друг в друга. Сначала выясняют, где приложение тратит время: на вычисления, чтение, подтверждение записи или ожидание другого запроса. Это определяет, за какое оборудование имеет смысл платить.
Какие данные нужны для выбора сервера СУБД?
Сначала описывают приложение: учётные операции, интернет-магазин, аналитика, телеметрия, смешанная нагрузка. Измеряют размер таблиц и индексов, прирост, объём журнала, количество соединений и реально активных запросов. Нужны пиковые периоды, а не только средняя загрузка в спокойный день.
Параллельно задают допустимое время операций. Для карточки заказа это может быть доля секунды, для отчёта — десятки секунд, для ночной обработки — часы. Такие значения являются требованиями приложения. Железо проверяют на их выполнение с ожидаемым числом клиентов и объёмом данных.
| Показатель | Что измерять | Как влияет на конфигурацию |
|---|---|---|
| Размер и рост | Данные, индексы, журнал, временные файлы | Полезная ёмкость и запас на обслуживание |
| Рабочий набор | Часто читаемые таблицы и индексы | Эффект RAM и нагрузка на накопители |
| Одновременность | Исполняемые запросы, транзакции, соединения | CPU, память операций, очереди |
| Профиль ввода-вывода | Чтение/запись, блоки, IOPS, p95/p99 задержек | Выбор SSD и схемы хранения |
| Требования сохранности | RPO, RTO, подтверждение транзакций | Журнал, репликация и резервные копии |
| Программная среда | Версия, редакция, расширения, ОС | Поддержка CPU, памяти, функций и лицензий |
Для действующей системы снимите профиль за неделю или другой период, который включает рабочие пики. Для новой подготовьте данные и сценарии приложения: один массовый отчёт способен потребовать больше ресурсов, чем десятки коротких транзакций.
OLTP и аналитика: почему им нужны разные ресурсы?
OLTP обычно состоит из множества коротких чтений и изменений. Здесь заметны задержка отдельного запроса, блокировки, скорость выполнения на ядро и подтверждение записи журнала. Аналитическая задача может сканировать большие объёмы, сортировать, группировать и распараллеливать обработку. Ей часто важны общий поток памяти, CPU и временное пространство.
Один сервер может обслуживать оба типа работы, но тогда тяжёлый отчёт способен вытеснять полезные страницы из кэша, занимать CPU и создавать временные файлы. Нужны ограничения конкуренции, расписание либо отдельный ресурс для аналитики. Выделение реплики для чтения возможно только при поддерживаемой архитектуре и приемлемой свежести данных.
Если CPU свободен, а запрос медленный, проверьте ожидания блокировок, диска и сети. Покупка процессора до этой проверки легко оставляет прежнюю причину задержки.

Что важнее: частота, ядра, кэш или число процессоров?
У CPU оценивают производительность на конкретном запросе и суммарную производительность при нужной одновременности. Номинальные GHz разных поколений не являются сопоставимым баллом скорости. Длинная последовательная часть запроса может ограничиваться одним ядром, а параллельные отчёты — общим CPU-бюджетом, памятью и настройками выполнения.
Учебный расчёт CPU: примем 80 операций/с и по 20 мс процессорного времени на операцию. Получится 80 × 0,02 = 1,6 эквивалента занятого ядра до фоновых задач. При 200 мс на операцию понадобится уже 16 таких эквивалентов. Для закупки оба исходных значения заменяют измерениями на сопоставимой платформе.
При переносе на другое семейство CPU расчёт подтверждают повторным тестом. Второй сокет добавляет память, линии и вычислительные ресурсы, но создаёт NUMA-топологию. Удалённый доступ к памяти и межпроцессорный обмен могут мешать некоторым нагрузкам. Если задача помещается в один сокет с достаточными каналами памяти и расширением, такой вариант стоит сравнить отдельно.
Почему для тысячи подключений не нужна тысяча ядер?
При подсчёте CPU учитывают выполняющиеся запросы. Простаивающее соединение расходует ресурсы, но не требует отдельного занятого ядра; пул нужен прежде всего для управления конкуренцией.
Связь потока и времени удобно проверять законом Литтла: в устойчивом режиме среднее число запросов в рассматриваемой системе равно потоку, умноженному на среднее время пребывания. При 400 запросах/с и среднем времени 0,05 с внутри системы находится около 20 запросов. Это не 20 занятых ядер: в указанные 50 мс могут входить ожидания диска, блокировок и сети. Условия стационарности и границу измерения надо сохранять.
Пул подключений ограничивает конкуренцию и расходы на соединения, но не делает тяжёлый запрос дешёвым. Слишком маленький пул переносит ожидание в очередь приложения; слишком большой способен перегрузить СУБД. При пилоте измеряют суммарную задержку от клиента, время в пуле, число активных запросов и результат базы. Иначе снижение времени выполнения SQL будет выглядеть успехом, хотя пользователь продолжит ждать в другом месте.
Почему PostgreSQL использует одно ядро и поможет ли параллельный запрос?
PostgreSQL Mechanics разбирает запрос на 16-ядерной машине, который оставляет часть CPU свободной. Здесь число доступных ядер следует сопоставить с планом: может ли эта операция распараллеливаться и есть ли для неё свободные исполнители?
У PostgreSQL есть параллельные планы, но не каждый запрос может ими воспользоваться. Проверьте фактические Workers Planned и Workers Launched, ограничения общего пула исполнителей и текущую конкуренцию. Рост параллелизма одного отчёта способен уменьшить его время и одновременно ухудшить пропускную способность сервера для остальных клиентов.
Например, четыре одновременно работающих отчёта, каждый с ведущим процессом и четырьмя рабочими процессами, потенциально создают до 20 участников вычисления. Это верхняя оценка состава процессов, а не обещание постоянной загрузки 20 ядер. Добавьте фоновые задачи и сравните весь смешанный сценарий. Настройка одного запроса при пустом сервере не доказывает пригодность рабочей конфигурации.
Сколько RAM нужно PostgreSQL и SQL Server?
RAM рассчитывают под активно используемые таблицы, индексы и память операций. Промахи кэша увеличивают чтение с накопителей; после размещения рабочего набора в памяти задержку могут определять блокировки, CPU и запись журнала.
Условная база занимает 1 ТБ, а активные таблицы и индексы — около 140 ГБ. Для кандидата с 256 ГБ RAM можно построить предварительный бюджет: 64 ГБ shared buffers PostgreSQL, 80 ГБ под целевой файловый кэш ОС, 48 ГБ на процессы и операции, 24 ГБ на ОС и другие службы, 40 ГБ запаса. Это распределение ресурсов для теста, а не гарантированное размещение уникальных 144 ГБ данных: часть страниц может дублироваться между кэшами.
Рабочий набор уточняют по поведению приложения. Большой архив редко используемых записей может почти не влиять на повседневный кэш. Один неожиданный аналитический запрос, наоборот, способен прочитать весь архив и изменить картину. Поэтому память проверяют на сочетании обычной работы, отчётов и обслуживания.
Какие настройки памяти нельзя переносить между СУБД?
PostgreSQL использует shared_buffers и кэш ОС. Значение около 25% RAM может служить отправной точкой для выделенного сервера, но окончательная настройка зависит от нагрузки. work_mem относится к отдельным операциям сортировки и хеширования, а не ко всему серверу или просто к одному подключению. Параллельные исполнители и несколько узлов плана увеличивают возможное суммарное потребление.
Пример верхней оценки: 40 активных запросов × 3 одновременно работающие операции × 64 МиБ = 7680 МиБ, или 7,5 ГиБ. Если в рассматриваемой схеме такие операции одновременно выполняют ещё два исполнителя на запрос, грубый бюджет может утроиться до 22,5 ГиБ. Реальное выделение зависит от плана и настроек; для хеширования есть дополнительные особенности. Увеличивать work_mem «для всех» без расчёта конкуренции нельзя.
В SQL Server настраивают max server memory, оставляя ресурс ОС и другим компонентам. Этот параметр не следует считать абсолютным пределом всей памяти процесса при любых выделениях. Также учитывают memory grants, tempdb, другие экземпляры и лимиты конкретной редакции. Значение из инструкции PostgreSQL здесь не подходит.
Для установки модулей проверяют каналы памяти, допустимые типы DIMM и режимы конкретной платы. Большой суммарный объём в нескольких занятых каналах может давать меньший поток, чем правильное распределение по всем доступным каналам. Практические ограничения раскрыты в материале о памяти Supermicro и установке DIMM.
Какие накопители нужны для данных, WAL, журнала и tempdb?
Разделяют четыре профиля: основные данные и индексы, журнал транзакций, временная обработка и резервные копии. Они могут находиться на одном физическом массиве либо на разных устройствах, но отдельные буквы дисков сами по себе не создают независимую производительность.
| Роль | Что особенно важно | Что проверять |
|---|---|---|
| Данные и индексы | Случайный доступ, смешанная нагрузка, полезная ёмкость | Задержки при реальном заполнении и конкуренции |
| WAL / transaction log | Предсказуемая подтверждённая запись | Flush/fsync, защита кэша, p99 задержки |
| Временные файлы / tempdb | Пики записи и чтения, конкуренция операций | Достаточное место и отсутствие конфликтов с основными данными |
| Копии и архив журналов | Поток и возможность восстановления | Независимость от основного хранилища и доступ при аварии |
NVMe снижает часть ограничений интерфейса и открывает высокий параллелизм, но не гарантирует низкую задержку синхронной записи любого SSD. Проверяют защиту от потери питания, ресурс записи, прошивку, длительную установившуюся производительность и поведение после заполнения. Пользовательский SSD с высокими короткими пиковыми цифрами может уступать более подходящему накопителю на рабочем журнале.
Почему миллионы IOPS не равны быстрой транзакции?
Паспортный показатель часто измеряется при большой глубине очереди и специально заданном профиле. Короткая транзакция может ждать одну последовательную зависимую операцию. Если увеличить очередь, суммарный поток вырастет, но время отдельного запроса способно ухудшиться.
Для дискового I/O тот же закон Литтла связывает IOPS с числом операций в системе: при 50 000 IOPS и среднем времени с ожиданием 1 мс одновременно находится около 50 операций, при 5 мс — около 250. Расчёт применим к установившемуся режиму с одной границей измерения.
Для журнала важны подтверждение записи и группировка транзакций. Нельзя просто поделить секунду на fsync latency и объявить результат пределом TPS: несколько транзакций могут подтверждаться совместно, а сама транзакция выполняет дополнительную работу. В приёмке измеряют TPS, задержки транзакций, ошибки и журнал одновременно.
Как рассчитать рост базы на год и не забыть об индексах?
Покупать накопители ровно под текущий размер базы опасно. В расчёт входят сами данные, индексы, журналы, временная работа и свободное место для обслуживания. Уточните, что показывает исходное число: логический размер бизнес-данных, занятые файлы СУБД или весь том. Если индексы уже входят в измеренный размер, добавлять их второй раз нельзя.
Разберём условный проект. Сегодня данные и индексы занимают 600 GB, чистый прирост составляет 25 GB в месяц. Через год ожидается 600 + 12 × 25 = 900 GB. Для проектного пика WAL выделено 160 GB, временных операций — 120 GB, служебных данных — 40 GB. Получаем 1220 GB занятого бюджета. При условии не заполнять полезный том выше 75% требуется 1220 / 0,75 = 1626,7 GB полезной ёмкости до выбора конкретного массива. Паритет и резервный диск в эту цифру не входят.
Линейная модель подходит только при обоснованном постоянном приросте. Если объём растёт на 5% ежемесячно, годовой множитель равен 1,05 в степени 12 — примерно 1,796. Те же 600 GB превращаются примерно в 1077,5 GB ещё до журналов и запаса. Разница с линейной моделью важна для срока службы выбранной конфигурации.
Для обслуживания задайте отдельный сценарий. Перестроение крупного индекса, временная сортировка, импорт и восстановление могут требовать свободное место одновременно. Резерв в процентах не разрешает любую операцию любого размера: нужно проверить её фактическую потребность и путь записи. Расширение файловой системы и добавление дисков также должны быть предусмотрены аппаратно.
После расчёта полезного пространства подбирают физическую схему хранения. У двухдискового зеркала полезная ёмкость определяется одним участником.
Ресурс записи оценивают по фактическому потоку на накопители. При 2 ТБ host writes в сутки за пять лет получится 3650 ТБ записи. Для SSD 3,84 ТБ это около 0,52 DWPD по такой упрощённой оценке. Сверяют период гарантированного ресурса, TBW/DWPD, распределение нагрузки между участниками массива и запас на рост. Внутреннее усиление записи зависит от устройства и профиля; host writes и внутреннюю запись NAND не смешивают.
Сколько места оставлять для WAL и transaction log?
Журнал растёт при интенсивных изменениях и может удерживаться из-за зависимых процессов. У PostgreSQL это, например, отставание архивирования или репликации и удержание WAL слотами. У SQL Server повторное использование журнала зависит от модели восстановления и состояния системы. Недостаточно один раз задать размер и забыть о нём.
Если средний поток WAL равен 20 МБ/с, а система должна пережить два часа недоступности получателя без удаления требуемого журнала, только этот интервал составляет 144 000 МБ, или 144 ГБ. Затем учитывают пики, другие причины удержания и выбранную политику ограничения. При 80 МБ/с тот же интервал требует уже 576 ГБ.
Оповещения настраивают по скорости роста и оставшемуся времени, а не только по проценту заполнения. 100 ГБ свободного места могут быть большим запасом для спокойной базы и несколькими минутами для интенсивного потока. Процедуру действий при отставании реплики проверяют заранее.
Что показал разбор Postgres I/O на PGCon?
Мелани Плагеман сопоставляла графики TPS и задержек с очередями накопителей, памятью, контрольными точками и статистикой PostgreSQL. На одном и том же оборудовании изменение распределения обращений и размера рабочего набора меняло поведение теста. Усреднённый результат скрывал провалы во времени.
«Сегодня я буду говорить только о локальном хранилище».
Мелани Плагеман, перевод пояснения о границах исследованного стенда.
Прогон должен захватить прогрев, контрольные точки и фоновое обслуживание. Отдельно проверяют набор больше RAM и используемый тип хранения: локальный SSD и сетевой том создают разные задержки.
Как сравнить цену сервера и стоимость SQL Server?
Брент Озар в Server Hardware Sizing связывает CPU, память и хранение со стоимостью редакции СУБД. Для закупки нужны действующие условия лицензирования; исторические цены из его примера используются только как пояснение метода.
При модели лицензирования по ядрам сравнивают стоимость нужного прикладного результата, а не максимальное число ядер в пределах бюджета на железо. Конфигурация с меньшим числом быстрых ядер и достаточной памятью иногда выгоднее, если она выдерживает нагрузку и подходит по правилам лицензирования. Для другой задачи больше ядер может быть оправданно.
Проверяют версию, редакцию, лимиты памяти и вычислений, права виртуализации, резервных узлов и миграции. Названия Standard и Enterprise без года и модели лицензии недостаточны. Для PostgreSQL также учитывают сопровождение, расширения, инструменты backup и работу специалистов: отсутствие определённой лицензии не делает эксплуатацию бесплатной.
SQL Server Standard: почему версия меняет расчёт CPU и памяти?
| Редакция | Вычислительный предел одного экземпляра Database Engine | Предел buffer pool одного экземпляра |
|---|---|---|
| SQL Server 2022 Standard | Меньшее из 4 сокетов или 24 ядер | 128 GB |
| SQL Server 2025 Standard | Меньшее из 4 сокетов или 32 ядер | 256 GB |
Предел buffer pool не равен всей памяти процесса SQL Server и не означает запрет устанавливать больше RAM в сервер. Память нужна ОС, другим структурам и компонентам, соседним экземплярам и службам. Но покупать 512 GB с ожиданием, что единственный экземпляр SQL Server 2022 Standard использует весь этот объём как buffer pool, неверно. У виртуального размещения отдельно проверяют, какие процессорные ресурсы доступны гостевой ОС и СУБД.
Замена версии ради снятия предела также требует проверки приложения. В пилоте фиксируют compatibility level, планы критичных запросов, драйвер подключения, время резервного копирования и восстановления. Ускорение одного отчёта после обновления не компенсирует регрессию основной транзакции. Сравнение проводят на копии репрезентативной базы с одинаковыми данными и условиями прогрева.
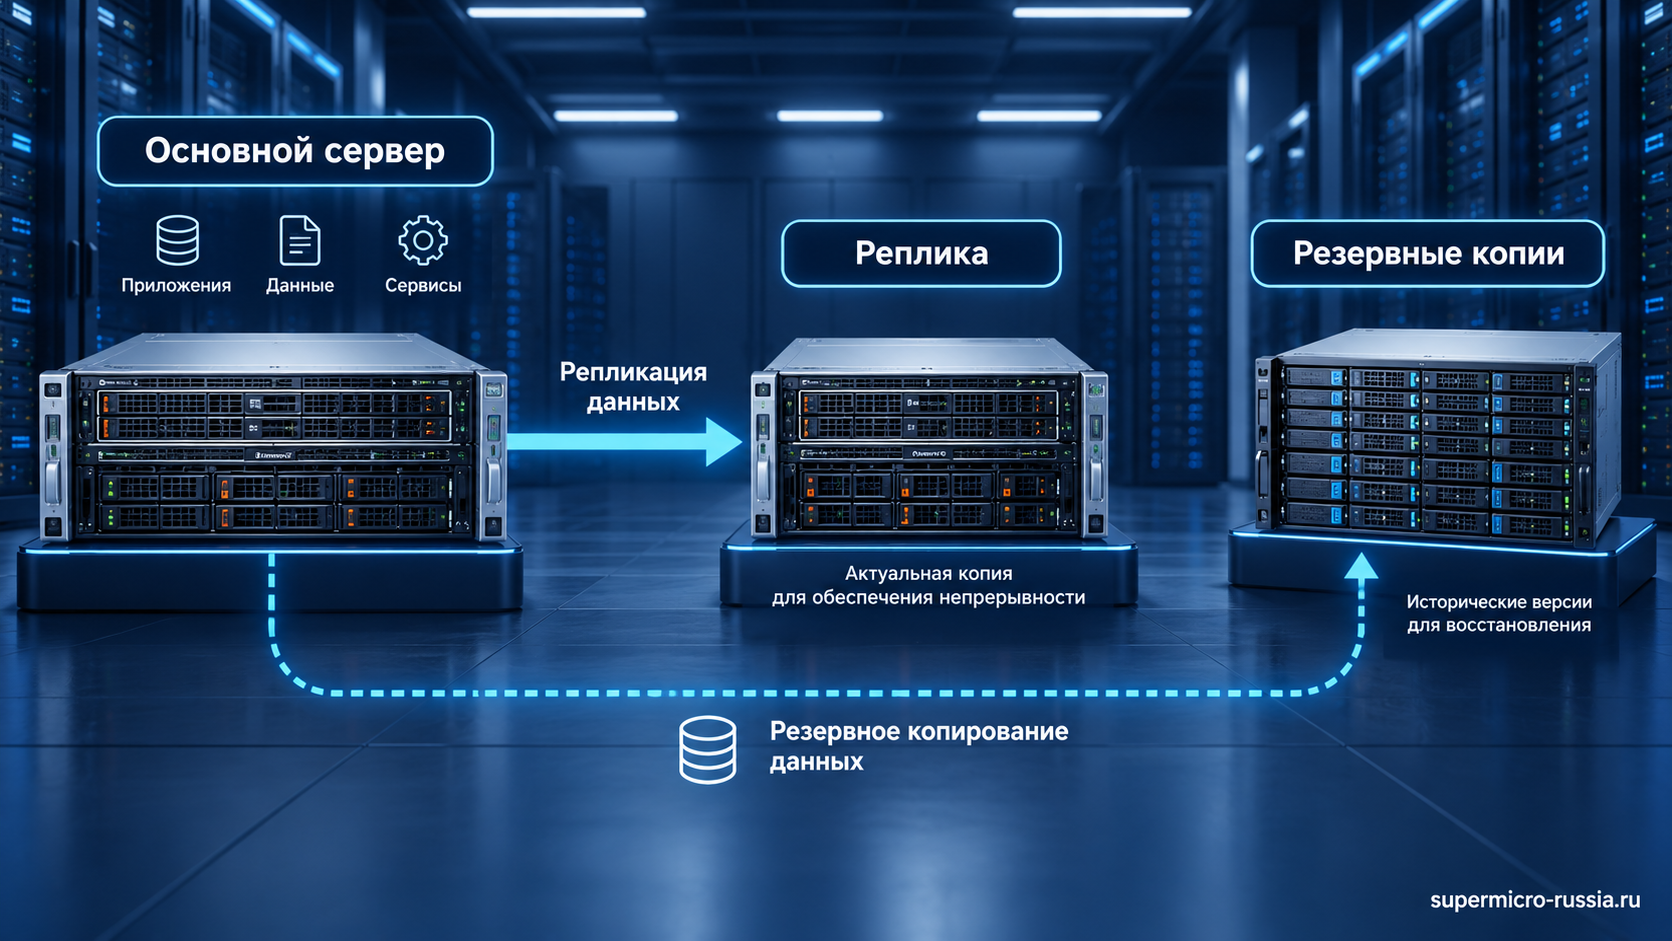
Репликация, отказоустойчивость и резервная копия
Реплика может помочь пережить отказ основного узла, но способна повторить логическое удаление или повреждающую операцию приложения. Копия нужна для возврата к предыдущему состоянию. При проектировании задают оба механизма и проверяют их совместную работу.
Синхронное подтверждение реплики добавляет сетевой и дисковый путь в критическую операцию записи. При асинхронной репликации возможна потеря последних ещё не доставленных изменений. Режим выбирают по допустимым потерям и задержкам. Само наличие второго сервера не доказывает нулевой RPO и автоматическое переключение.
Для копий СУБД нужен согласованный механизм: логический экспорт, поддерживаемая физическая копия либо интеграция backup-продукта с приложением. Простое копирование меняющихся файлов работающей базы без предусмотренной процедуры может оказаться непригодным. После восстановления проверяют целостность и реальные запросы.
Матрица совместимости и предварительные конфигурации
| Нагрузка | Что заложить в кандидат | Что обязательно подтвердить |
|---|---|---|
| Небольшая транзакционная база | CPU с хорошим откликом, RAM под активный набор, защищённая запись SSD | p95 операций, журнал и параллельные клиенты |
| Смешанная база и отчёты | Больше памяти, CPU-бюджет, быстрые временные операции | Отчёт не нарушает целевое время коротких транзакций |
| Большой аналитический набор | Каналы памяти, сканирование, параллелизм, полезная ёмкость | Планы запросов, spills, итоговое время обработки |
| Интенсивная запись | Журнал с низкой задержкой, ресурс SSD, запас WAL/log | Устойчивые задержки, контрольные точки, отставание реплики |
| Критичная система | Основной узел, механизм переключения и независимые копии | RPO/RTO и восстановление на другом оборудовании |
Для любого кандидата проверяют поддержку ОС и СУБД, тип и заполнение DIMM, путь PCIe/NVMe, контроллеры, драйверы и охлаждение. Покупка дополнительных NVMe требует достаточного числа линий и подходящего backplane; разъём M.2 или U.2 сам по себе не подтверждает всю конфигурацию.
Подобрать аппаратную основу можно в разделе серверов Supermicro. Если конфигурацию комплектуют по отдельности, рассматривают серверные материнские платы и проверяют их в составе нужного шасси. Для задач именно 1С есть отдельный расчёт сервера под реальную нагрузку 1С.
Выбирайте оборудование Supermicro по рабочему набору, задержкам и требуемому резерву. Сравнение подходящих вариантов полезнее покупки максимального числа ядер в доступном шасси.
Как отделить недостаток железа от проблемы запроса?
До покупки соберите профиль ожиданий: CPU, дисковая запись, чтение, блокировки, временные файлы и передача результата клиенту. Если запрос ждёт блокировку другой транзакции, удвоение числа ядер не обязано уменьшать задержку. Если возвращаются миллионы строк через медленный клиентский канал, быстрый локальный NVMe тоже не устранит всё время выполнения.
Нужен хотя бы один воспроизводимый проблемный сценарий: одинаковые данные, план, параметры запроса, число клиентов и настройки сохранности. Затем изменяют один фактор: объём доступной памяти, индекс, параллелизм или ресурс хранения. Это позволяет оценить причинный эффект и не приписать выигрыш нового сервера случайному прогреву кэша.
Для PostgreSQL полезны статистика запросов при настроенном pg_stat_statements, сведения об ожиданиях и планы выполнения. EXPLAIN ANALYZE действительно выполняет запрос; для изменяющих данных команд это требует отдельно подготовленного безопасного окружения. Для SQL Server анализируют соответствующие средства наблюдения за запросами и ожиданиями. Диагностический отчёт должен показывать, где проходит время, а не только высокий процент занятости CPU.
Пример: отчёт выполняется 30 секунд, из которых 20 приходятся на ожидание ресурса, который новая конфигурация не улучшит. Даже бесконечное ускорение оставшихся вычислений не даст результат быстрее 20 секунд. Если же основное время занимает подтверждённое чтение рабочего набора, увеличение RAM и подходящий дисковый путь могут иметь совсем другой эффект. Числа здесь поясняют ограничение, а не обещают скорость определённой СУБД.
Dreams of Code показывает работу с prepared statements и индексами. Первые могут сократить повторную подготовку запроса, вторые — объём просматриваемых данных. Эффект проверяют на своих запросах и распределении значений; проценты демонстрационного ускорения для закупки не подходят.
Индекс ускоряет подходящие чтения, но занимает место и обслуживается при изменениях, увеличивая запись и WAL. Поэтому его проверяют на рабочем сочетании чтения и обновлений, а расход места возвращают в расчёт ёмкости.
Autovacuum, контрольные точки, резервное копирование и репликация создают фоновую работу. Запишите её в расписание теста. Если производительность падает каждые несколько минут, временной ряд задержки и записи полезнее среднего значения CPU за час. Уменьшать сохранность транзакций ради красивой скорости при подборе оборудования нельзя.
Как провести тест PostgreSQL и SQL Server до покупки?
Как сформулировать измеримое требование к быстродействию базы?
Для условной системы заказов зададим 300 завершённых бизнес-операций в секунду, p95 до 250 мс и p99 до 600 мс. Одна бизнес-операция может содержать несколько SQL-запросов, поэтому эти 300 операций нельзя автоматически называть 300 queries per second. Допустимую долю ошибок также фиксируют до испытаний.
Если за тест выполнен миллион операций, медленный 1% — это 10 тысяч операций. Среднее время способно скрыть их влияние на пользователей. Сохраняйте распределение задержек, таймауты и ошибки, а не только средний TPS. Неудачные запросы нельзя исключать из отчёта так, будто они успешно завершились мгновенно.
Лучший основной тест — повторяемый сценарий собственного приложения на обезличенном или синтетическом репрезентативном наборе. Для PostgreSQL pgbench полезен как дополнительный инструмент и поддерживает пользовательские сценарии. Его типовой тест не является готовым эквивалентом вашей CRM, магазина или аналитической системы.
Тестовые данные размещают в отдельной базе. Инициализация и нагрузка способны изменять или удалять тестовые таблицы, поэтому их не запускают на рабочей СУБД без специального плана. Генератор нагрузки проверяют отдельно: слабый клиент или слишком узкий канал может ограничить результат раньше сервера.
Для обеих СУБД фиксируют версии, настройки памяти, планы, количество соединений, набор запросов, длительность, размеры данных, состояние кэша и режим сохранности. Сравнивают холодный и прогретый запуск, обычный режим и обслуживание. Нельзя повышать TPS отключением нужной гарантии записи, а потом сравнивать его с конфигурацией, сохраняющей транзакции при сбое.
Наращивайте нагрузку ступенями до устойчивого роста очереди. Затем повторите рабочую ступень с отчётами, резервным копированием и ожидаемым объёмом данных. Конфигурация подходит, пока выполняет заданные поток и задержку с принятыми настройками сохранности.
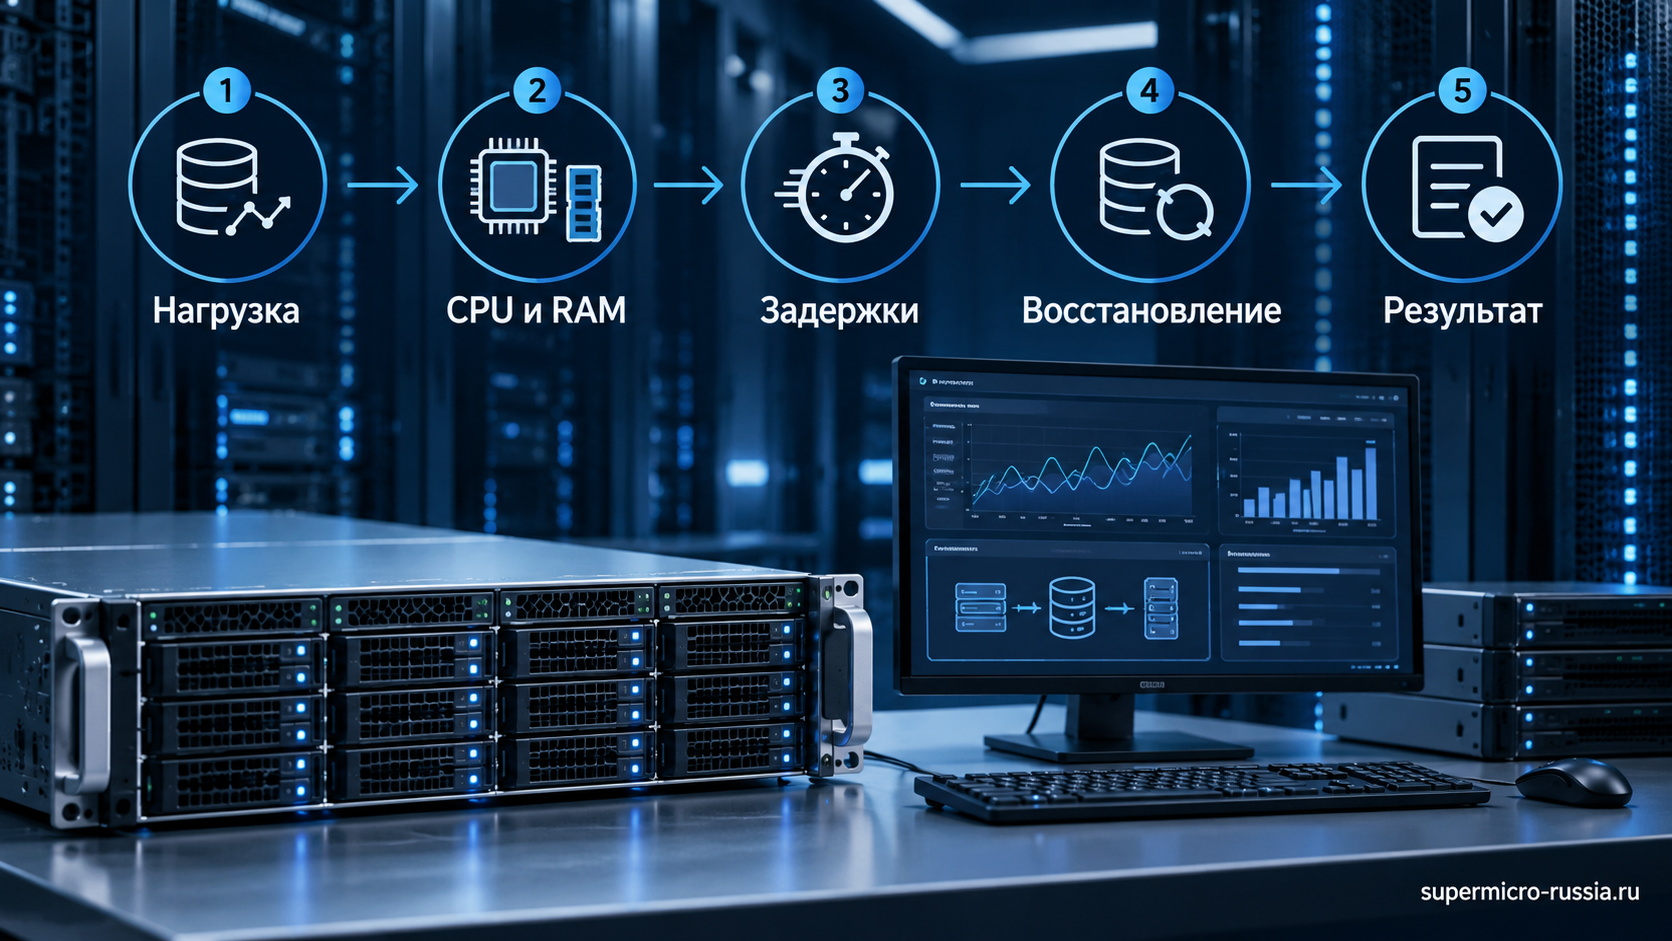
Программа приёмки сервера базы данных
| Этап | Измерения | Критерий |
|---|---|---|
| Контрольный запрос | План, CPU time, чтения, p95/p99 | Заданный отклик на правильном объёме данных |
| Рост одновременности | TPS, очередь, ошибки, блокировки | Ожидаемый пик без недопустимого роста задержек |
| Обслуживание | Контрольные точки, vacuum/индексы, backup | Рабочие операции сохраняют согласованные показатели |
| Накопители | Задержки чтения и подтверждённой записи, температура, ресурс | Нет сбросов, перегрева и необъяснимых провалов |
| Реплика | Отставание, переподключение, согласованный отказ | Выполнение принятой модели RPO/RTO |
| Восстановление | Возврат базы и журналов, целостность, запрос приложения | Данные пригодны, сервис возвращается в срок |
Для PostgreSQL сочетают статистику СУБД, ожидания и средства ОС: pg_stat_activity, доступные в версии представления ввода-вывода, iostat и журналы. Для SQL Server анализируют Query Store при его использовании, ожидания, память, файлы и планы. Отдельный высокий cache hit ratio не доказывает отсутствия дисковой проблемы, а средняя задержка не заменяет анализ медленных операций.
Частые вопросы перед покупкой сервера для баз данных
Можно ли разместить СУБД в виртуальной машине?
Можно при поддержке выбранного программного стека и достаточных гарантированных ресурсах. Проверяют NUMA, память, задержки хранения и конкурирующие ВМ. Виртуализация не отменяет требования приложения к записи и восстановлению.
Поможет ли 10GbE, если база находится на локальных NVMe?
Может помочь передаче результата, резервному копированию и репликации. Но не ускорит локальную вычислительную операцию, которая не упирается в сеть. Проверьте весь путь от приложения до СУБД и внешних получателей.
Можно ли разместить две СУБД на одном сервере?
Можно, если учтены совместные пики, память, журналы, фоновые работы и модель отказа. Два независимых расчёта, каждый использующий почти весь ресурс машины, складывать без пересчёта нельзя.
Когда отдельный сервер базы оправдан?
Когда изоляция ресурсов, требования к управлению, задержкам и восстановлению дают проверяемую пользу. Отдельный сервер добавляет сетевой путь и эксплуатационные зависимости; одного роста размера файла для решения недостаточно.