Кейс: рабочая станция Supermicro с тремя GPU для Blender и видеомонтажа
Три видеокарты способны заметно сократить рендер, но не превращают любой Blender-проект в задачу с тройной скоростью. Этот кейс посвящён рабочей станции Supermicro для 3D-студии и видеомонтажа: AMD EPYC 9374F, 384 ГБ DDR5 и три NVIDIA RTX A5000 по 24 ГБ. Разберём, где полезны серверные линии PCIe, почему 72 ГБ физической VRAM не равны одному общему пулу и как измерять выгоду на собственном рабочем проекте.
Практическая основа — сборка ServerFlow. Автор сообщил для сцены BMW27 в Blender 32 секунды на одной A5000 и 12,7 секунды на трёх. Это ускорение примерно в 2,52 раза для конкретного теста, а не универсальные «три раза» во всех программах. Полные параметры сцены и драйвера для независимого воспроизведения здесь не восстановлены; наших стендовых измерений нет.
Аппаратные возможности семейства H13SSL ниже разбираем на конкретной Supermicro H13SSL-N. У этой модели есть необходимые подключения для нескольких ускорителей; сетевое исполнение и совместимость конкретной поставки проверяют отдельно.
Какую проблему студии решает такая станция
Архитектору или визуализатору часто мешает не скорость моделирования, а очередь финального рендера. Пока машина считает кадры, интерактивная работа становится неудобной. У монтажёра похожая ситуация: тяжёлый исходный материал, шумоподавление и эффекты упираются в разные компоненты, и простое добавление RAM не всегда помогает.
Станция с несколькими GPU из каталога Supermicro объединяет мощную память и несколько ускорителей в одном обслуживаемом узле. Она может считать несколько независимых кадров, обслуживать разные приложения или ускорять один поддерживаемый рендер. Но итог зависит от проекта: трёхмерная сцена, декодирование камеры, цветокоррекция и экспорт — разные нагрузки.
Перед подбором нужно выбрать измеримый результат. Например, уложить ночной рендер 500 кадров в два часа, сохранить плавность определённой монтажной последовательности или одновременно обслуживать двух специалистов с отдельными задачами. Формулировка «самая мощная рабочая станция» не позволяет проверить, решена ли проблема.
Что входит в рассматриваемую конфигурацию
| Узел | Состав кейса | Зачем он нужен |
|---|---|---|
| Процессор | AMD EPYC 9374F, 32 ядра / 64 потока | Подготовка сцен, CPU-задачи и периферийные ресурсы платформы |
| Плата | Семейство Supermicro H13SSL; разбор на H13SSL-N | Несколько полноценных PCIe-подключений и серверная память |
| RAM | 12 × 32 ГБ DDR5-4800, всего 384 ГБ | Большие рабочие наборы и использование каналов памяти |
| GPU | 3 × NVIDIA RTX A5000, по 24 ГБ | Поддерживаемый многокарточный рендер и вычисления |
| Быстрые накопители | Два серверных SSD по 2 ТБ и отдельный M.2 | Разделение системной и проектной нагрузки; точные SKU SSD здесь не нормируются |
| Архивный слой | Два HDD по 16 ТБ | Отдельная роль хранения крупных материалов |
| Программы теста | Blender, Octane, V-Ray, DaVinci Resolve и другие | Разные профили использования нескольких GPU |
Нужно различать RTX A5000, RTX 5000 Ada и другие модели со сходными названиями. В этом проекте параметры 24 ГБ и 230 Вт относятся к A5000 поколения Ampere. Замена на другую «5000» меняет память, питание, драйверы и охлаждение, поэтому сокращённого названия в заказе недостаточно.
Почему серверная платформа полезна для трёх GPU
Десктопная плата может иметь три длинных разъёма, но электрически выдавать не три x16. Часть слотов подключается через чипсет и делит общий тракт. Для независимых ускорителей важно знать не форму разъёма, а число линий и источник подключения.
H13SSL-N предоставляет три PCIe 5.0 x16 и два PCIe 5.0 x8, а также отдельные соединения MCIO и M.2. Конкретная карта работает на общем поддерживаемом поколении: A5000 с PCIe 4.0 не становится устройством PCIe 5.0 от установки в новый слот. Но полноценные подключения помогают избежать ненужного ограничения обмена.
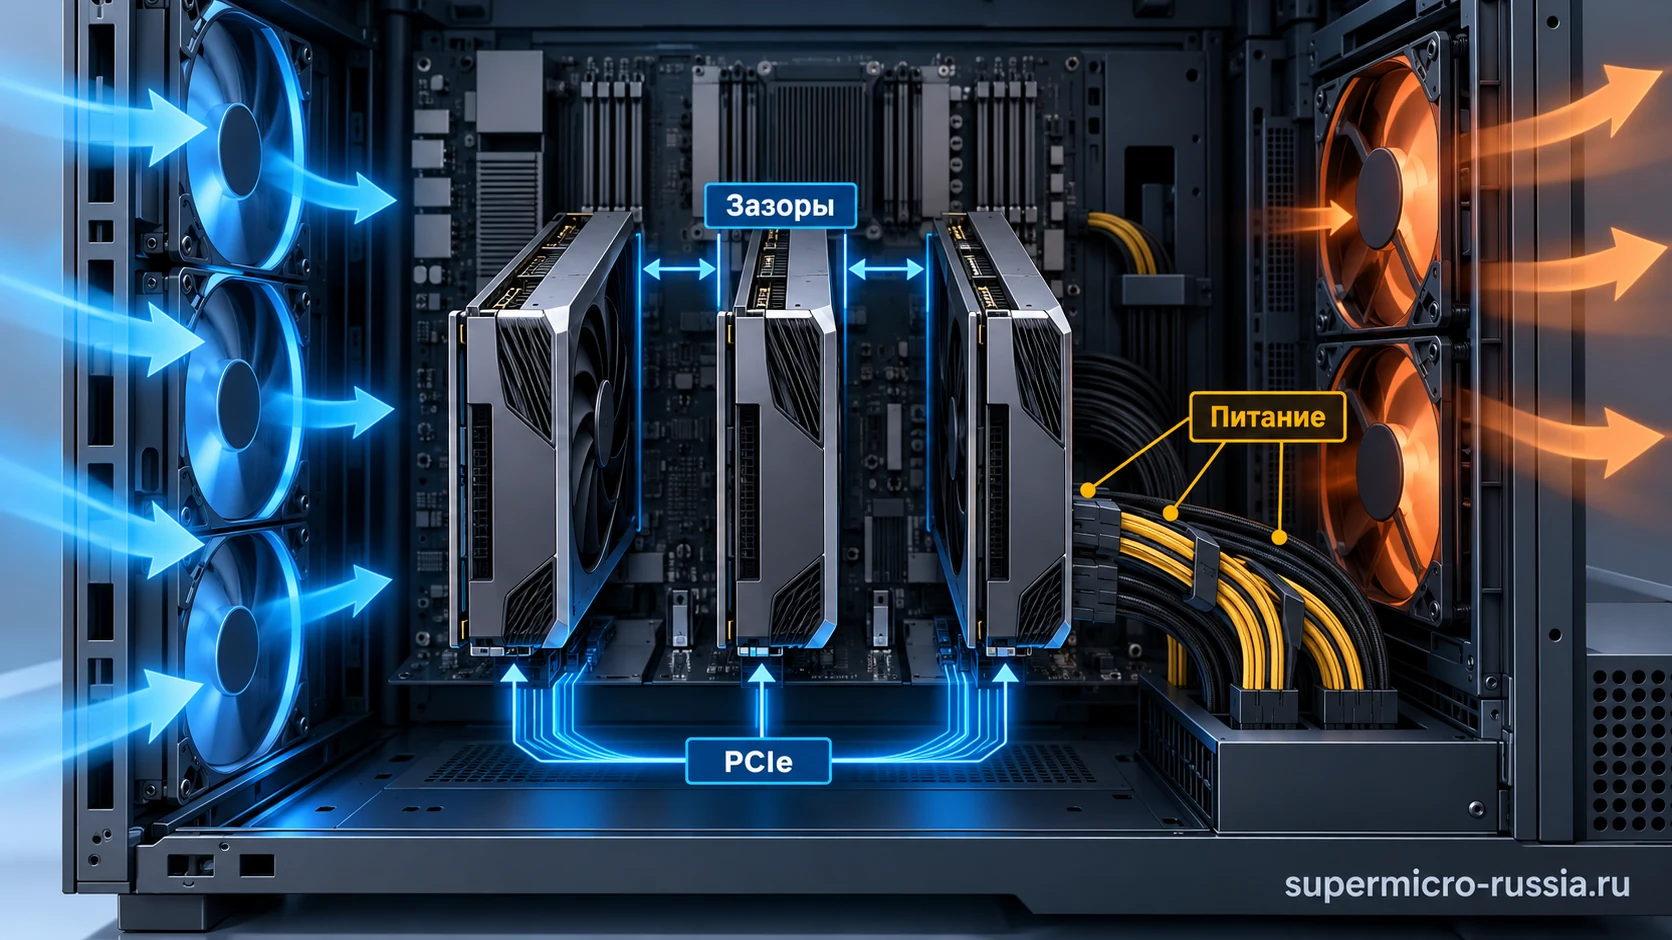
Физическая установка остаётся отдельной проверкой. Три двухслотовые карты занимают значительную часть корпуса. Нужно сопоставить расстояния между слотами, толщину кожухов, кабели питания, нижний зазор и доступ к внутренним разъёмам. Наличие трёх x16 в спецификации не подтверждает установку любых трёх карт толщиной 3,5 слота.
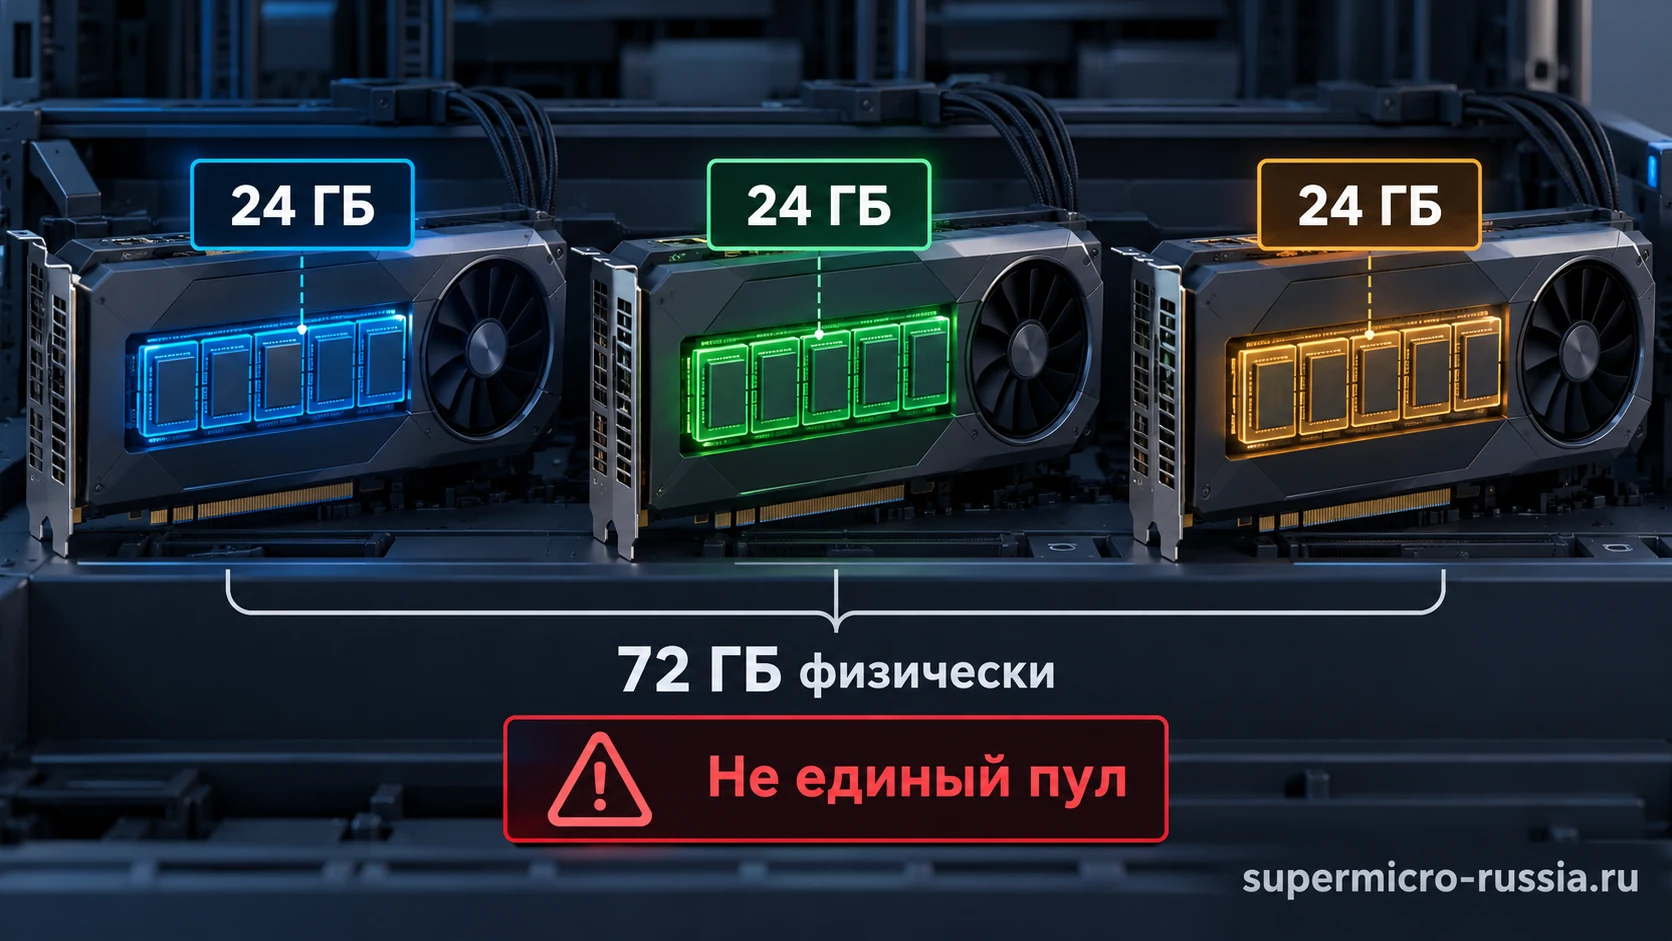
72 ГБ видеопамяти — это один большой объём?
Нет. Три A5000 имеют суммарно 72 ГБ физической памяти, но обычный multi-GPU-рендер часто загружает копию сцены на каждое устройство. Тогда максимальный размер сцены ограничивается памятью отдельной карты за вычетом служебных расходов, а не суммой трёх GPU.
Режимы распределения памяти зависят от приложения и межсоединения. A5000 допускает NVLink в подходящей паре с поддерживаемым ПО, но наличие разъёма не создаёт автоматический общий 72-гигабайтный пул из трёх карт. Для описанного кейса общий пул не подтверждён и не используется как обещание.
Представим сцену, которой нужно 30 ГБ GPU-памяти. Три независимые 24-гигабайтные карты не гарантируют её размещение в обычном режиме дублирования сцены. Возможны out-of-core, изменение проекта или выбор карты с большей памятью, но это уже другая производительность и другие условия. Для сцены в 12 ГБ все три устройства могут оказаться полезными, если движок умеет распараллелить вычисления.
Что показал Blender и как посчитать ускорение
В тесте ServerFlow сцена BMW27 считалась 32 секунды на одной A5000 и 12,7 секунды на трёх. Деление 32 / 12,7 даёт примерно 2,52. Время сократилось примерно на 60,3%. Эффективность относительно идеального трёхкратного ускорения — около 84%: 2,52 / 3.
| Показатель | Значение | Как интерпретировать |
|---|---|---|
| Одна A5000 | 32 с | Авторский результат отдельной сцены |
| Три A5000 | 12,7 с | Авторский результат при включении трёх устройств |
| Ускорение | ≈ 2,52 раза | Расчёт по двум временам |
| Снижение времени | ≈ 60,3% | Не тождественно «росту скорости на 60%» |
| Идеальная эффективность трёх GPU | ≈ 84% | Условное сравнение с линейным масштабированием |
Для производственного планирования возьмём условные 500 одинаковых по сложности кадров. По 32 секунды получится 4 часа 26 минут 40 секунд, по 12,7 — 1 час 45 минут 50 секунд. Разница 2 часа 40 минут 50 секунд. Это экстраполяция, а не выполненный автором рендер 500 кадров; в реальной анимации сложность и подготовка кадров различаются.
Есть и важный программный нюанс: автор не смог выбрать все три устройства в использованном стандартном Blender Benchmark, затем проверил многокарточный режим в самом Blender. Поэтому отчёт из одного бенчмарка и результат настоящей сцены нужно читать отдельно. Нельзя делать вывод о невозможности multi-GPU в приложении только по интерфейсу тестовой утилиты.
Почему три карты не всегда ускоряют в три раза
Часть работы остаётся последовательной: подготовка геометрии, компиляция, перенос данных, сбор результата и операции CPU. Если условно 10% времени не распараллеливается, идеальная граница для трёх одинаковых GPU по упрощённой модели будет 1 / (0,1 + 0,9 / 3) = 2,5 раза. Это поясняющая модель, не восстановленный профиль исходного теста.
Короткая сцена сильнее чувствительна к постоянным накладным расходам. У длинного рендера доля подготовки может уменьшаться, а у тяжёлого обмена данными — расти. Кроме того, три устройства могут иметь разные температуры и частоты. Одинаковый артикул не гарантирует идентичной скорости в тесном корпусе.
ServerFlow сформулировал главный вопрос прямо: «В каких задачах три ГПУ дают реальную пользу и насколько рост производительности будет близок к линейному?» Для закупки ответ ищут в своих сценах. Результат чужого короткого теста помогает сформировать гипотезу, а не заменяет испытание рабочего набора студии.
Как сравнивать Blender, Octane и V-Ray
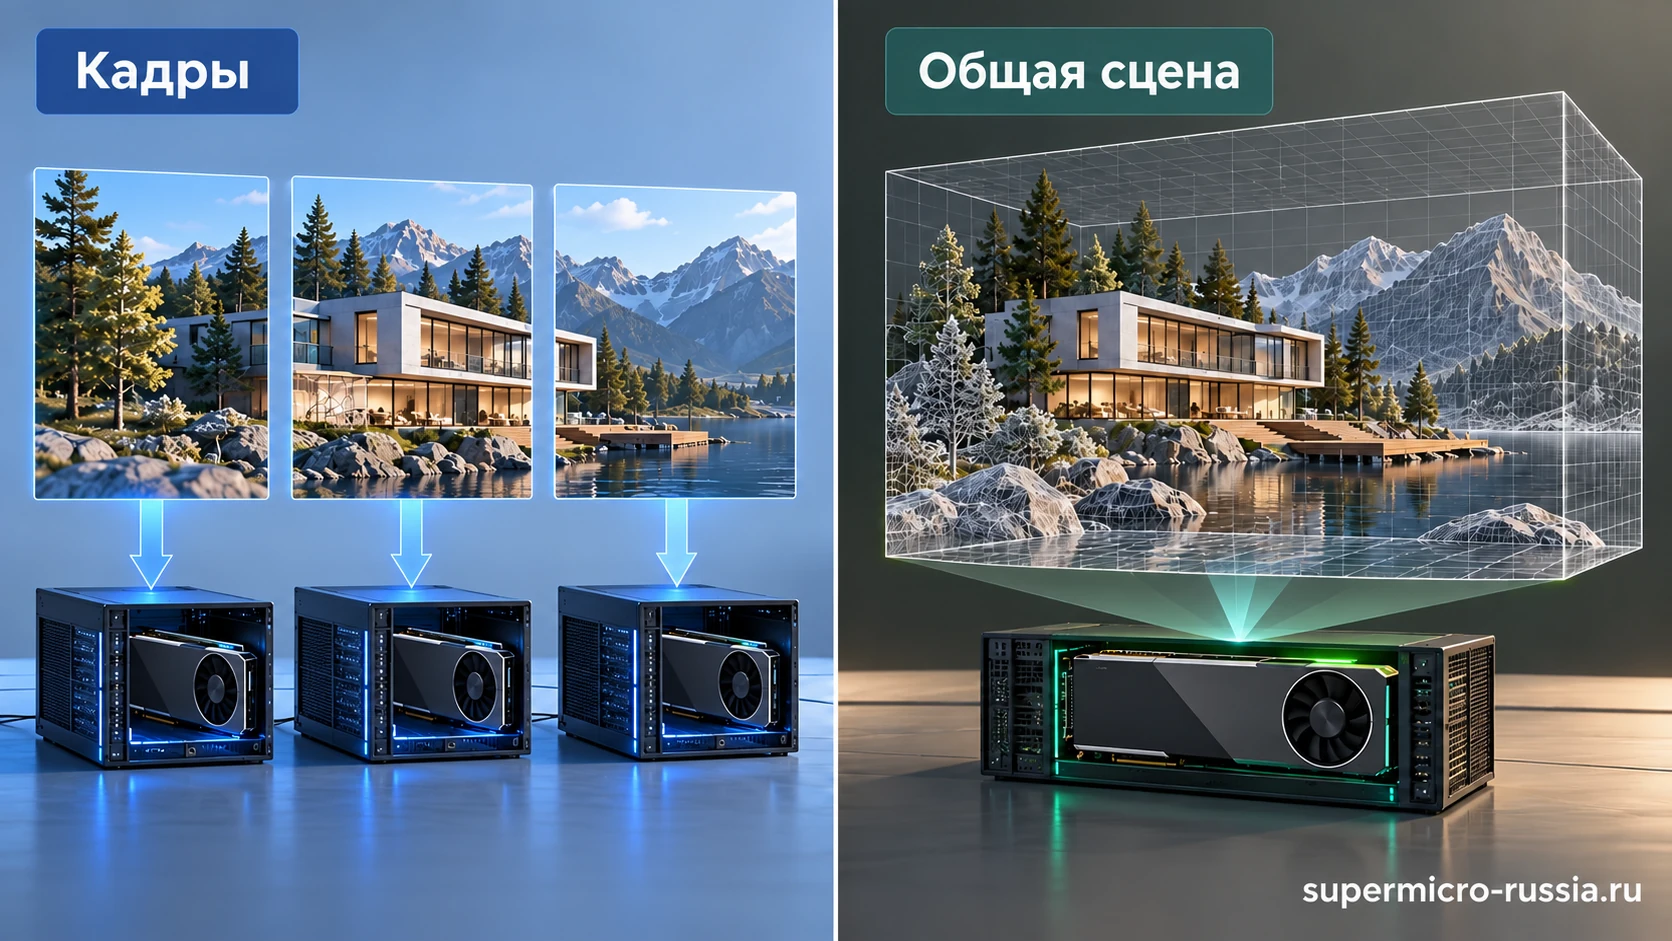
У каждого движка свои поддерживаемые устройства, настройки и ограничения памяти. Даже при одной станции нельзя складывать баллы Octane и V-Ray или считать их общей единицей производительности. Важнее время получения нужного результата с согласованным качеством.
Для студийного пилота выбирают три сцены: типичную, самую тяжёлую по памяти и самую длинную по вычислению. Каждую запускают на одной, двух и трёх картах при одинаковом backend, samples, denoising и разрешении. Первый прогон с компиляцией и прогретый повтор записывают отдельно.
Если несколько специалистов отправляют независимые задания, может быть выгоднее выделить каждому устройство или поставить очередь, чем всегда использовать все GPU одной задачей. Так уменьшается ожидание коротких интерактивных работ. Максимальный балл одного задания и максимальная пропускная способность студии — разные цели.
Что меняется в DaVinci Resolve и тяжёлом монтаже
В исходном проекте использовался материал Sony FX3 с битрейтом до 600 Мбит/с; автор описал заметное улучшение работы после включения нескольких GPU. Подтверждённого численного FPS в этом фрагменте нет, поэтому обещание воспроизведения любого такого материала без пропусков здесь не даётся.
600 Мбит/с равны 75 МБ/с на один исходный поток до дополнительных данных. Четыре таких потока дадут около 300 МБ/с. Для современного NVMe это может быть умеренная последовательная нагрузка, но сложное декодирование, эффекты и шумоподавление способны ограничивать процесс раньше диска. Именно поэтому скорость SSD сама по себе не объясняет плавность timeline.
Поддержка нескольких GPU зависит от редакции, версии и конкретного этапа Resolve. Декодирование, OpenFX, цвет, Fusion и экспорт нельзя оценивать одним средним процентом GPU. Пилот проводят на фактическом проекте с привычными эффектами, проверяя звук, пропуски кадров и время экспорта.
Зачем установлены 384 ГБ DDR5
Двенадцать модулей по 32 ГБ позволяют использовать двенадцать каналов памяти EPYC 9004 при корректном заполнении. Теоретическая ширина потока при DDR5-4800 и 12 каналах составляет 4800 млн передач/с × 8 байт × 12 = 460,8 ГБ/с без учёта практических ограничений. Это не измеренная скорость приложения.
Большая RAM помогает вместить сцену, кэш монтажа и несколько приложений. Но память CPU не превращается в GPU VRAM без отдельного механизма передачи. Когда рендер переходит к системной памяти, характер задержек меняется. Поэтому достаточность RAM и достаточность видеопамяти проверяют отдельно.
При меньшем бюджете можно уменьшать объём, но нельзя бездумно нарушать баланс каналов. Два модуля большой ёмкости и двенадцать меньших при одинаковой сумме памяти дают разные возможности пропускной способности. Для точного выбора нужны рабочий объём данных и схема заполнения, а не только число гигабайт.
Как разделить систему, рабочие файлы и архив
В конфигурации есть быстрые SSD и два HDD по 16 ТБ. Их полезно разделить по назначению: ОС и программы, активные проекты/кэши, завершённые материалы. Но наличие двух HDD не подтверждает ни зеркало, ни резервную копию. Схема защиты и расписание копирования должны быть оформлены отдельно.
MCIO — способ вывести PCIe-линии к подходящим устройствам, а не универсальный переходник на любой накопитель. Нужны согласованные кабель, питание, интерфейс SSD и поддержка выбранного подключения. U.2/U.3, SATA и SAS нельзя считать взаимозаменяемыми только из-за похожего 2,5-дюймового корпуса.
Кэш приложения можно восстановить заново, исходники и уникальные проекты — не всегда. Это различие помогает распределить бюджет SSD и бэкапа. Папка «backup» на втором диске внутри той же станции не защищает от всех общих отказов и вредоносных изменений.
Как три карты влияют на температуры
Автор сообщил температуры ядер примерно 82,5 °C у нижней, 85,6 °C у средней и 86,2 °C у верхней карты. Разница крайних значений — 3,7 °C. Но небольшая разница не доказывает достаточный абсолютный запас: нужны пределы конкретных GPU, частоты, причина ограничения, температура помещения и длительность нагрузки.
Турбинные двухслотовые профессиональные карты удобны для плотной установки, поскольку иначе работают с потоком, чем многие широкие игровые модели. При этом корпус должен подать достаточно холодного воздуха к каждой карте и вывести нагретый. Нижняя карта может зависеть от зазора до кожуха БП или дна.
Важна установившаяся совместная нагрузка CPU и всех GPU. Отдельный тест процессора с простаивающими картами не проверяет максимальный тепловой режим станции. После сборки сохраняют температуры, частоты и RPM, а также делают повтор с закрытым корпусом и штатными фильтрами.
Как правильно считать мощность блока питания
Три A5000 с паспортным максимумом 230 Вт каждая дают до 690 Вт мощности плат по сумме предельных значений. К ним добавляются CPU, память, диски, вентиляторы и периферия. Но сумма паспортных максимумов не является измеренным обычным потреблением и не описывает все переходные режимы.
В исходном тесте автор назвал 1150 Вт из розетки. Это входная мощность системы. Номинал БП относится к выходной мощности, а перевод между ними требует фактического КПД в данном режиме. Сертификация 80 PLUS Gold не задаёт одно неизменное значение КПД для любой нагрузки, поэтому выводить точную выходную мощность только из сертификата неправильно.
При заказе фиксируют мощность по линиям, штатные кабели для каждой GPU, допустимые коннекторы и запас под совместный пик. Модульные кабели другого БП не используют по совпадению формы разъёма. Для длительного рендера стабильность питания важнее минимальной экономии на комплекте.
H13SSL-N или H13SSL-NT для похожей станции
| Модель | Рабочая сеть | Когда различие полезно |
|---|---|---|
| H13SSL-N | Два 1GbE | Когда сеть уже решена отдельным адаптером либо проекты преимущественно локальные |
| H13SSL-NT | Два 10GBASE-T | Когда нужен быстрый медный сетевой тракт без дополнительной NIC |
Обе модели относятся к ATX-платформе SP5 с габаритами около 30,48 × 25,65 см. Для EPYC 9004 используется DDR5-4800 в поддерживаемом составе; возможности более новых CPU зависят от ревизии платы. Переход N → NT не ускоряет локальный Blender-рендер сам по себе: он меняет сетевое оснащение.
Что включить в приёмку станции для студии
- Сохранить точные SKU GPU, объём RAM, BIOS, драйверы, ОС и версии приложений.
- Проверить каждую карту отдельно, затем совместную работу и электрические режимы слотов.
- Измерить свои сцены на одной, двух и трёх GPU; разделить подготовку и собственно рендер.
- Проверить проект, который почти заполняет видеопамять, и поведение при её превышении.
- Протестировать реальный монтаж, эффекты и экспорт, а не только синтетический балл.
- Выполнить длительную совместную нагрузку с журналом температур, частот и мощности.
- Восстановить один рабочий проект из независимой копии и проверить все связанные файлы.
Как оценивать станцию по очереди всей студии
Время одного кадра не равно производительности рабочего дня. Пусть дизайнер каждые полчаса отправляет короткий preview, а ночью запускается длинная анимация. Если все три GPU всегда заняты долгой задачей, короткая проверка может ждать дольше, чем на менее мощной, но правильно организованной системе. Поэтому вместе с железом выбирают приоритеты очереди.
Один вариант — ночью использовать все устройства, а в рабочее время оставлять ресурс интерактивным задачам. Другой — разделять независимые задания по GPU, если приложение и лицензия позволяют. Лучший режим определяется стоимостью ожидания команды и фактическим временем задач, а не максимальным баллом одного бенчмарка.
Экономия 2 часа 40 минут 50 секунд на условном пакете из 500 кадров превращается примерно в 40,2 часа машинного времени при 15 таких пакетах в месяц. Но это не автоматически 40,2 оплачиваемых часа сотрудника. Если рендер идёт ночью, денежная выгода может выражаться в меньшем числе просроченных итераций и возможности утром увидеть результат, а не в сокращении рабочей смены.
Для оценки окупаемости нужны наблюдаемые данные: сколько проектов действительно ждёт рендера, сколько раз приходится повторять расчёт и сколько работы можно выполнять параллельно. Покупка трёх GPU оправдывается изменением процесса, а не одной эффектной цифрой ускорения.
Почему подготовка сцены может съесть выигрыш рендера
Передача 100 ГБ исходников по 1GbE имеет идеальную нижнюю границу около 13 минут 20 секунд. По 10GbE сырая граница для тех же байтов — около 80 секунд. Реальные значения выше из-за протоколов, дисков и множества файлов. На фоне рендера сцены за десятки секунд разница в подготовке становится определяющей.
Поэтому при сетевых проектах нужны локальный кэш или согласованный быстрый рабочий ресурс. Скопировать сцену и забыть текстуры — не ускорение: рендер может завершиться быстро, но неверно. Пакет подготовки должен включать зависимости, цветовые профили, плагины и версию движка.
При сравнении одной и трёх GPU записывают два времени: полный путь от запуска задания до готового файла и отдельно вычислительную часть. Если в отчёте есть только чистый рендер, это нужно знать при планировании смены. Три карты способны ускорить вычисление, но не исправить медленный сетевой поиск тысяч текстур.
Как подготовить честное сравнение конфигураций
Сохраняют сцену, версию программы и настройки в отдельном пакете. Фиксируют backend CUDA/OptiX или другой выбранный режим, разрешение, samples, denoiser и использование CPU. Смена backend между сравнениями может дать разницу, которую ошибочно припишут числу карт.
Первый прогон с компиляцией не смешивают с повторным. Делают несколько повторов и отмечают разброс, а не выбирают только самый красивый результат. Если короткая сцена считает 12–13 секунд, ручная неточность и фоновые процессы уже заметны относительно длительности. Для устойчивой оценки полезен и более длинный проект.
Вместе со временем сохраняют пиковую память, частоты и причины ограничений GPU. Если третья карта перегревается и снижает частоту, это свойство конкретной сборки, а не обязательно слабое масштабирование приложения. И наоборот: прохладная карта с низкой загрузкой может ждать CPU или данные.
Результат проверяют визуально и по принятому критерию качества. Более быстрый рендер с другим denoising или меньшим числом samples не является эквивалентным результатом. Для монтажа дополнительно сравнивают экспортированный файл, а не только плавность интерфейса.
Как вводить рабочую станцию в действующую студию
Новая ОС или драйвер могут поддерживать GPU, но иначе работать с привычными плагинами. В исходной сборке использовалась Windows Server 2025; это не означает, что такой выбор обязателен или поддерживается каждым рабочим приложением студии. Поддержку конкретной ОС и редакции программы проверяют до переноса проектов.
Сначала переносят тестовую копию одного завершённого проекта и сравнивают результат со старой системой. Затем пробуют типичный действующий проект, сохраняя возможность вернуться к прежней рабочей станции. Одновременное изменение GPU, ОС, версии рендера и плагинов затрудняет поиск причин расхождений.
Также проверяют лицензирование сетевого рендера и нескольких GPU, доступ пользователей к очереди и ограничения одновременного запуска. Аппаратная возможность включить три устройства не гарантирует, что установленная редакция программы разрешает все нужные режимы. Это часть подготовки рабочего места, а не дополнительная характеристика платы.
Как оставить возможность развития без лишней закупки
Полезно заранее определить следующий предел: память GPU, RAM, проектный SSD или очередь задач. Если сцены растут по геометрии и текстурам, четвёртая карта меньшей ёмкости может не решить проблему размещения. Если растёт число независимых кадров, дополнительный исполнитель или отдельный render-node может оказаться логичнее.
Запас мощности и места должен иметь понятную цель. Свободные линии PCIe полезны, но установка сетевого адаптера всё равно зависит от физического места между GPU. Зазор под кабель MCIO, доступ к M.2 и возможность вынуть одну карту без разборки всей станции стоит проверить при первоначальной сборке.
Такой подход сохраняет главный смысл кейса: серверная плата позволяет построить необычно ёмкую и расширяемую станцию, а реальная выгода возникает только при совпадении архитектуры с приложениями студии. Конфигурацию выбирают по рабочему циклу целиком, включая подготовку, рендер, хранение и возврат проектов.
Частые вопросы о трёх GPU для Blender
Лучше три карты по 24 ГБ или одна с большей памятью?
Если сцена не помещается в 24 ГБ обычного режима, большая память одной карты может быть решающей. Если сцены помещаются и хорошо распараллеливаются, несколько GPU способны увеличить пропускную способность. Сравнивают время своих задач и бюджет памяти, а не только сумму VRAM.
Можно ли обещать ускорение 2,52 раза каждому заказчику?
Нет. Это расчёт по конкретным авторским временам BMW27. Другие сцены, версии и настройки дадут иной результат. Для коммерческого предложения подтверждают целевую задачу пилотом.
Три GPU ускорят весь монтаж?
Только поддерживаемые стадии и режимы. Узким местом может оказаться CPU-декодирование, накопитель, эффект или экспортный кодек. Проверка ведётся по конкретной последовательности и настройкам редактора.
Что передать для подбора похожей станции?
Сцену или тестовый проект, целевое время рендера, версии программ, используемые плагины, максимальную память и ограничения помещения. С этими данными подбирают плату и GPU под рабочие приложения. Кейс показывает возможности архитектуры, а спецификация должна соответствовать вашей нагрузке.