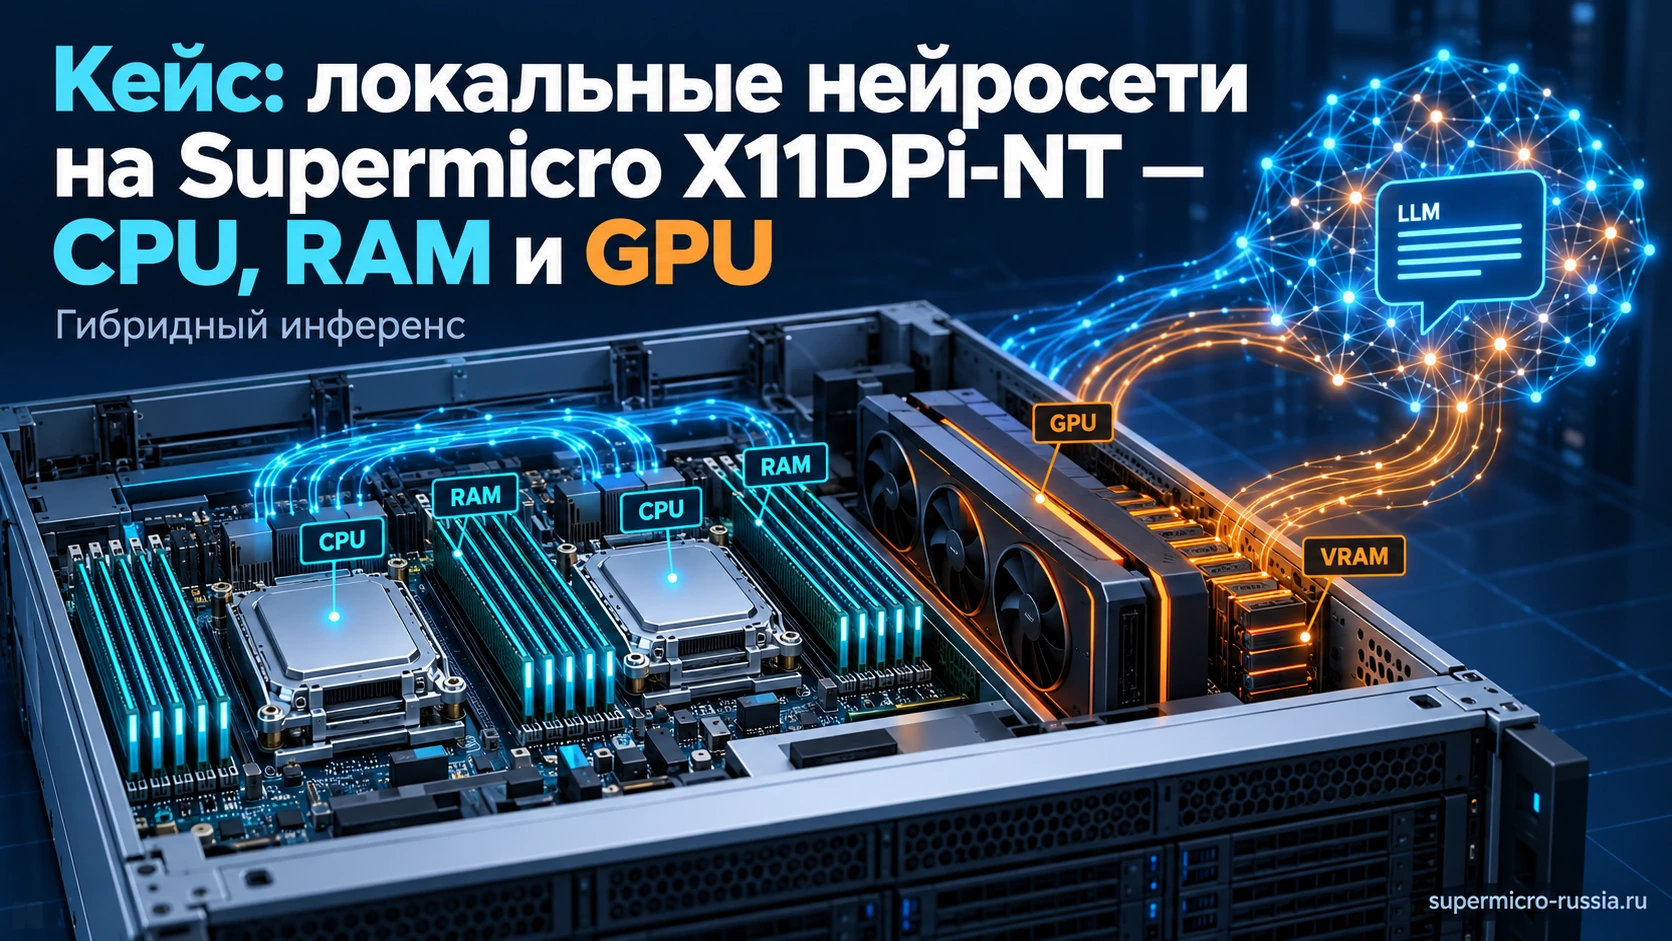
Кейс: локальные нейросети на Supermicro X11DPi-NT — CPU, RAM и GPU
Большая модель не помещается в видеопамять, а покупать несколько дорогих ускорителей для эксперимента рано. Именно эту задачу решает гибридный сервер: основная часть весов остаётся в оперативной памяти, часть вычислений выполняет GPU. На Supermicro X11DPi-NT такой подход позволяет исследовать большие локальные LLM, но за доступную ёмкость DDR4 приходится платить временем ответа и вниманием к настройкам.
Разберём реальную архитектуру сборки Jun Yamog: X11DPi-NT, Xeon Gold 6154, DDR4 ECC, Proxmox, проброс видеокарты и ik_llama.cpp. Автор испытывал GLM 4.7, MiniMax 2.5 и Qwen 3.5, сначала с RTX 3060, затем с RTX 3090. Его опубликованные результаты ниже отделены от наших расчётных примеров. Это инженерный разбор конфигурации, а не отчёт о внедрении у нашего заказчика.
Задача кейса: запустить большую LLM без полного размещения на GPU
Для отдела разработки, интегратора или небольшой исследовательской группы первая цель часто очень практичная: проверить модель на собственных документах, сравнить качество ответов, отладить API и понять, нужен ли проекту отдельный GPU-сервер. На этом этапе один инженер может согласиться ждать ответ несколько минут. Для интерактивного помощника на десятки сотрудников такие задержки уже неприемлемы.
Поэтому вопрос «какой сервер для нейросетей купить» здесь сужается до другого: можно ли на двухсокетной DDR4-платформе получить полезную лабораторию для больших моделей? Да, если задача допускает гибридный инференс. Но способность загрузить веса, скорость генерации и число одновременных пользователей — три разных критерия. Успех по первому ещё ничего не доказывает по двум остальным.
«Я познакомился с гибридным CPU/GPU-инференсом больших локальных моделей на довольно скромной конфигурации», — так Jun Yamog описывает свой эксперимент. Перевод с английского.
Эта фраза хорошо передаёт масштаб проекта. Перед нами лабораторная архитектура для знакомства с большими LLM. Её разумно оценивать по стоимости эксперимента, доступному объёму памяти и полезности результата, а не подменять сравнением с современным сервисом на нескольких профессиональных ускорителях.
Что входит в конфигурацию и что делает каждый компонент
| Узел | Подтверждённая основа | Практическая роль |
|---|---|---|
| Материнская плата | Supermicro X11DPi-NT, Intel C622, два LGA3647 | Многоканальная DDR4, PCIe для GPU и накопителей, удалённое управление |
| Процессор | Xeon Gold 6154: 18 ядер, 36 потоков, 3,0 ГГц базовой частоты, TDP 200 Вт | Выполняет оставленные на CPU операции и обслуживает память модели |
| Оперативная память | Серверная DDR4 ECC; точный объём исходной сборки здесь не установлен | Хранит веса, не размещённые в VRAM, и данные CPU-части вычислений |
| Видеокарта | RTX 3060 на первом этапе, RTX 3090 при дальнейшем развитии | Ускоряет выбранные операции и принимает часть тензоров модели |
| Программная схема | Proxmox → ВМ с проброшенным GPU → ik_llama.cpp | Отделяет экспериментальное окружение от гипервизора и других сервисов |
Supermicro X11DPi-NT нельзя смешивать с X11DPi-N. У версии NT два встроенных порта 10GBase-T и чипсет C622. У N другой сетевой набор и C621. Для локального инференса эта разница не превращается в дополнительные токены в секунду, зато влияет на передачу наборов данных, подключение к хранилищу и бюджет сетевых плат.
У платы 16 DIMM-разъёмов, но у Xeon Gold 6154 шесть каналов памяти на процессор. Количество разъёмов и число независимых каналов не совпадают. Также нельзя переносить максимальную память всей линейки плат на любую пару CPU: у 6154 предел памяти составляет 768 ГБ на процессор, а совместимость конкретных RDIMM/LRDIMM проверяется отдельно. Память DDR4-2933 не заставит этот CPU работать выше поддерживаемых им 2666 MT/s.
Для повторения самой архитектуры важны корпус E-ATX под плату 304,8 × 330,2 мм, совместимые кулеры LGA3647, питание CPU и размещение видеокарты. Точный комплект исходной сборки не восстановлен полностью, поэтому ниже предложен самостоятельный расчётный вариант, а не вымышленный список установленных автором деталей.
Как работает гибридный инференс CPU + GPU
В полностью GPU-режиме основная вычислительная работа и необходимые веса находятся на ускорителе. В гибридном режиме движок распределяет тензоры и операции между системной памятью, CPU и GPU. Конкретная схема зависит от архитектуры модели и возможностей выбранной версии программы. Нельзя просто сложить RAM и VRAM и получить один одинаково быстрый пул.
Особенно интересны модели MoE — Mixture of Experts. Для одного токена выбирается лишь часть экспертов, поэтому число активных параметров меньше общего. Это уменьшает объём выполняемых вычислений относительно плотной модели такого же полного размера. Однако в обычной схеме с резидентными весами хранить приходится весь необходимый набор экспертов, а не только активную долю.
Отсюда возникает соблазн: оставить экспертов в большой DDR4, а часть остальных тензоров и вычислений перенести на GPU. Такой режим действительно поддерживается в ik_llama.cpp. Но увеличение выгруженной на видеокарту доли не всегда монотонно ускоряет работу: ограничителями становятся память GPU, обмен через PCIe, размер пакета и CPU-часть. Настройка начинается с измерений, а не с максимального числа GPU-слоёв.
У X11DPi-NT слоты расширения PCIe 3.0. Для x16 расчётная пропускная способность после кодирования составляет примерно 15,75 ГБ/с в одном направлении, до протокольных и программных накладных расходов. Если гипотетически передавать через этот линк 10 ГБ, один только идеальный перенос займёт около 0,64 секунды. Это не описание обмена на каждом токене, а объяснение, почему бесконтрольное перемещение больших массивов может съесть пользу GPU.
Сколько оперативной и видеопамяти нужно локальной нейросети
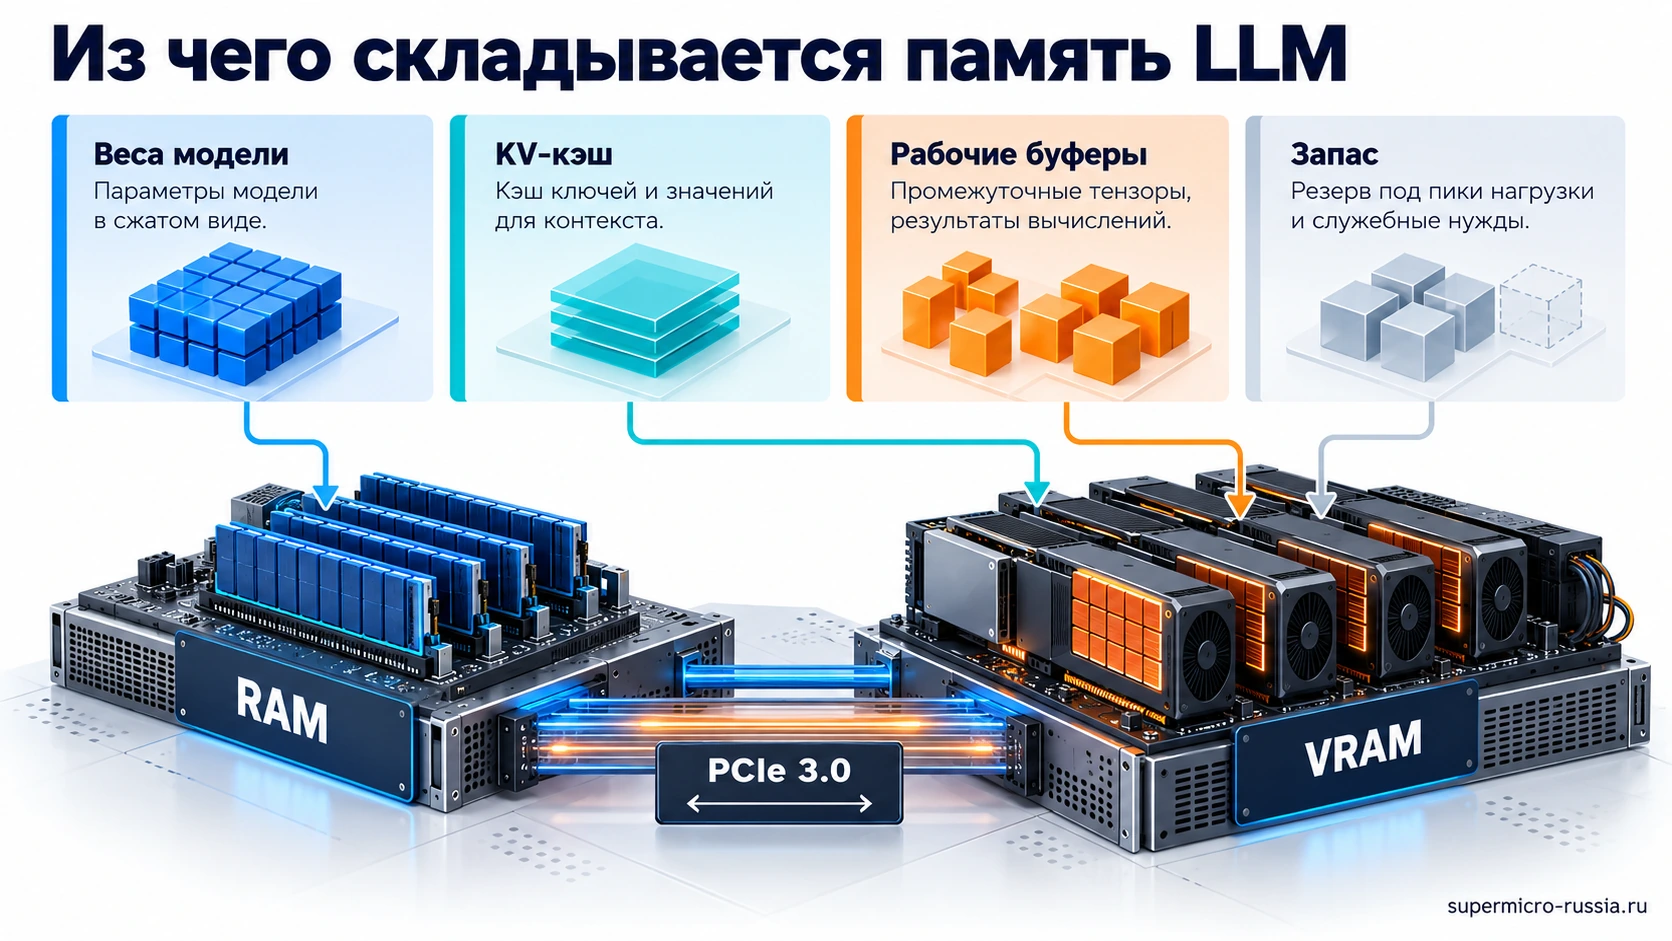
Начальная оценка весов: число параметров × число бит на параметр / 8. Для условного равномерного 4-битного представления это 0,5 байта на параметр. У реального GGUF есть метаданные, масштабы квантования и тензоры с другой точностью, поэтому расчёт служит нижним ориентиром, а не точным размером файла.
| Общее число параметров | Идеализированные веса при 4 битах | В двоичных единицах | Что ещё требуется |
|---|---|---|---|
| 7 млрд | 3,5 ГБ | Около 3,26 ГиБ | KV-кэш, буферы, служебная память |
| 32 млрд | 16 ГБ | Около 14,90 ГиБ | Запас, особенно при длинном контексте |
| 70 млрд | 35 ГБ | Около 32,60 ГиБ | Размещение между CPU/GPU или более ёмкий GPU |
| 235 млрд | 117,5 ГБ | Около 109,43 ГиБ | Существенная RAM и проверка конкретного формата модели |
Эта таблица не присваивает перечисленным в кейсе моделям неподтверждённые размеры и не обещает их запуск в определённом объёме памяти. Названия семейств GLM, MiniMax и Qwen без точного варианта и файла квантования недостаточно для такой рекомендации. Перед сборкой нужны полный идентификатор модели, контрольная сумма весов, размер файлов и пробная загрузка с нужным контекстом.
Почему размер контекста меняет требования
В обычном Transformer с KV-кэшем его грубая оценка для одной последовательности выглядит так: 2 × слои × KV-головы × размер головы × токены × байты элемента. Двойка учитывает ключи и значения. Для условных 32 слоёв, 8 KV-голов, размерности 128, контекста 32 768 и двухбайтовых элементов получается 4 ГиБ. При 65 536 токенах — уже 8 ГиБ.
Это учебный пример обычной KV-архитектуры, а не паспорт GLM 4.7, MiniMax 2.5 или Qwen 3.5. GQA, MLA, sliding window, гибридные слои и квантование кэша меняют расчёт. При нескольких параллельных последовательностях расход тоже зависит от реализации. Нельзя обещать «128k на любой модели», опираясь лишь на количество DIMM.
Для выбора DDR4 ECC Registered важны не только гигабайты, но и размещение по каналам. Если одна и та же ёмкость набрана двумя большими модулями или двенадцатью сбалансированными, CPU получает принципиально разные условия доступа. RDIMM и LRDIMM в одном комплекте не смешивают; артикулы и порядок заполнения проверяют до заказа.
Реальные результаты: что означает 3–11 токенов в секунду
Jun Yamog опубликовал следующие значения. Для этапа RTX 3060 указан заполненный контекст 32k. После перехода на RTX 3090 использованы более длинные контексты; для Qwen и MiniMax часть MoE-экспертов была размещена на GPU. Полные варианты квантования и версии ПО в доступной сводке не зафиксированы, поэтому таблица показывает результаты конкретного эксперимента, а не воспроизводимый рейтинг видеокарт.
| Этап | Модель и контекст | Prefill, токенов/с | Генерация, токенов/с |
|---|---|---|---|
| RTX 3060 | GLM 4.7, 32k | 34,07 | 3,47 |
| RTX 3060 | MiniMax 2.5, 32k | 119,55 | 6,53 |
| RTX 3060 | Qwen 3.5, 32k | 97,81 | 9,26 |
| RTX 3090 | GLM 4.7, 64k | 15,26 | 5,41 |
| RTX 3090 | MiniMax 2.5, около 127k | 87,11 | 11,62 |
| RTX 3090 | Qwen 3.5, 128k | 71,43 | 10,62 |
Главный вывод здесь очень земной: большие модели действительно могут выдавать ответы на подобной гибридной архитектуре. Но три токена в секунду и одиннадцать — разные ощущения при работе. Если механически пересчитать выдачу ответа на 1000 токенов, при постоянных 3,47 токена/с получится примерно 288 секунд, а при 9,26 — 108 секунд. Это только генерация, без ожидания очереди и обработки запроса; скорость в реальном диалоге меняется.
Нельзя разделить показатели двух этапов и объявить, что RTX 3090 «в столько-то раз быстрее RTX 3060»: одновременно изменились контекст и распределение тензоров. Для честного сравнения карты нужно зафиксировать одну модель, один квант, одинаковые входные данные, настройки кэша и движок. В исходной таблице такого контролируемого сравнения нет.
Почему нейросеть долго начинает отвечать, хотя генерация приемлемая
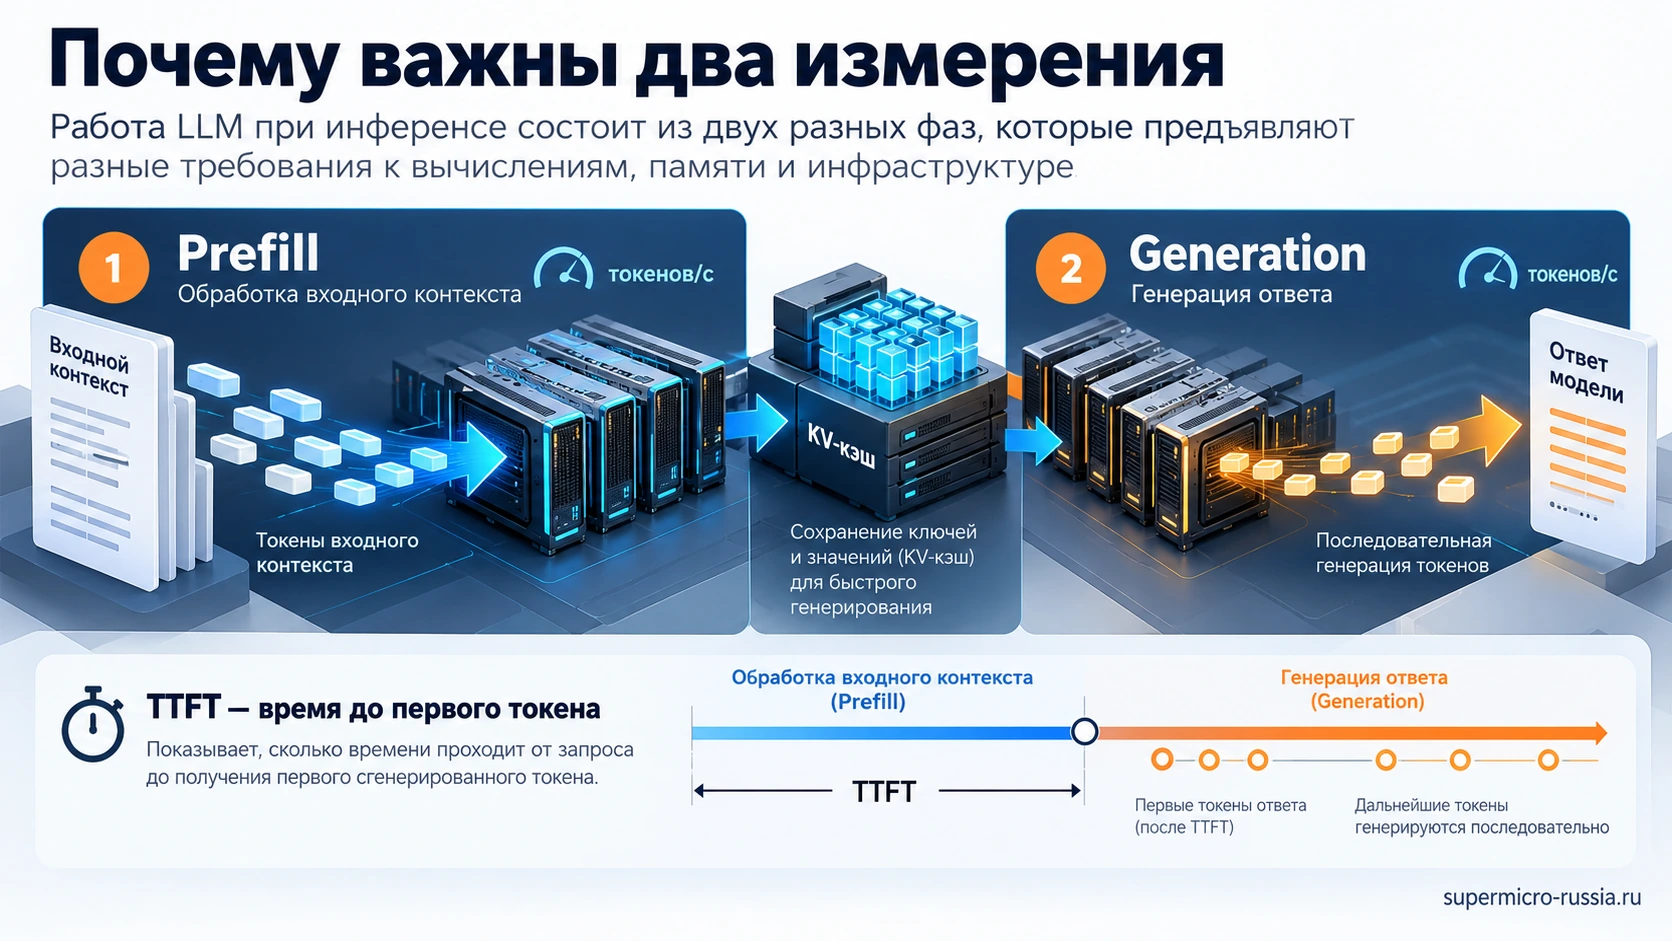
Prefill — обработка входного контекста, generation — последовательная выдача новых токенов. Высокая скорость одной фазы не гарантирует высокую скорость другой. Для пользователя дополнительно важен TTFT, время до первого токена: в него могут входить очередь, подготовка запроса, prefill и первый шаг генерации.
Возьмём отдельный расчётный пример: новый вход на 8192 токена обрабатывается со скоростью 100 токенов/с. Без повторного использования кэша это около 82 секунд только на prefill. После этого ответ на 500 токенов при 8 токенах/с потребует ещё 62,5 секунды. Получается примерно 145 секунд без учёта прочих задержек. Фраза «работает на восьми токенах в секунду» скрыла бы большую часть ожидания.
Поэтому сценарий с короткими вопросами и сценарий загрузки большого договора нужно испытывать отдельно. Повторный запрос с уже закэшированным префиксом тоже не равен первому запросу после запуска сервиса. В протоколе проверки полезны два режима: холодный запрос без готового префикса и повторное обращение с разрешённым кэшированием.
Почему после замены GPU одна фаза ускорилась, а другая замедлилась
Особенно показателен MiniMax 2.5. В первом этапе Jun Yamog получил 119,55 токена/с на обработке входа и 6,53 токена/с на генерации. В дальнейшем — 87,11 и 11,62 соответственно. При этом контекст вырос с 32k примерно до 127k, появилась RTX 3090 и изменилось размещение MoE-экспертов. Снижение первого показателя не доказывает ухудшение видеокарты: сравниваются разные режимы всей системы.
У такого эксперимента есть два разных результата. Первый — выбранная архитектура в принципе запускает нужную модель и позволяет работать с длинным контекстом. Второй — пользователь получает определённую задержку в конкретном режиме. Для покупки оборудования важны оба, но вывести второй из первого нельзя. Запуск модели на 127k не означает, что каждый запрос на этом контексте будет интерактивным.
При повторении сборки полезно сначала оставить контекст 32k на обеих GPU, зафиксировать квантование весов и KV-кэша, число потоков CPU и распределение экспертов. Затем менять только одну величину: карту, размер контекста либо объём offload. Если на прежней конфигурации длинный контекст не помещается, это отдельный результат проверки ёмкости, а не нулевая скорость в сравнительном графике. Такой порядок позволяет понять, за что именно имеет смысл доплатить.
Почему два Xeon и большой объём RAM могут работать медленнее ожидаемого
У каждого Xeon свои контроллеры памяти и подключённые устройства. При обращении к памяти другого сокета данные проходят через межпроцессорную связь. Если потоки работают на одном CPU, а значительная часть весов оказалась в памяти второго, растут удалённые обращения. Это одна из причин, почему добавление второго процессора само по себе не гарантирует двукратного ускорения.
Теоретический поток данных DDR4-2666 при шести полностью задействованных каналах составляет около 2666 × 8 × 6 = 127 968 МБ/с, то есть примерно 128 ГБ/с на CPU. Для двух сокетов арифметически получается около 256 ГБ/с. Это потолок интерфейсов памяти, а не измеренная скорость чтения весов и не обещание конкретного числа токенов.
Проверку начинают с lscpu, numactl --hardware и топологии PCIe. Затем сравнивают запуск на одном сокете с локальной памятью и запуск на двух сокетах при контролируемом распределении. Если веса не помещаются в память одного сокета, тест с жёсткой локализацией нельзя применять механически: он может привести к нехватке памяти. Для большой модели полезнее осмысленно проверить interleave и другие поддерживаемые режимы.
Число CPU-потоков движка тоже подбирают. Hyper-Threading не удваивает число физических ядер и пропускную способность DDR4. Для условных двух 6154 получаются 36 ядер и 72 логических потока; начинать сравнение разумно с нескольких фиксированных значений числа рабочих потоков, например 18 и 36, затем проверять SMT. Настройки prefill и генерации могут потребовать разных значений.
Расчётная конфигурация для повторения архитектуры
Ниже — проектный пример, не восстановленный комплект автора и не утверждение о наличии деталей на складе. Он нужен, чтобы было видно, как согласуются CPU, каналы RAM и память ВМ.
| Компонент | Пример выбора | Что проверить |
|---|---|---|
| CPU | 2 × Xeon Gold 6154 | Совместимая пара, охлаждение двух CPU с TDP 200 Вт каждый |
| RAM | 12 × 32 ГБ ECC RDIMM = 384 ГБ номинально | По 6 модулей на CPU, правильные первичные слоты каждого канала |
| GPU | Одна RTX 3090 с 24 ГБ либо подходящая под выбранный эксперимент альтернатива | Габариты, питание, драйвер, объём доступной VRAM после загрузки |
| Диски | SSD для системы и быстрый SSD для весов и данных | Ёмкость всех квантов, временных файлов, резервных копий; ресурс записи |
| ВМ для LLM | Например, до 320 ГиБ RAM из доступного хосту объёма | Резерв гипервизора и остальных служб; отсутствие давления на память |
| Корпус и БП | E-ATX с местом для GPU и двух кулеров | Обдув DIMM/VRM, разъёмы питания, кабели и запас по совместной нагрузке |
Двенадцать модулей здесь выбраны ради заполнения всех шести каналов каждого CPU по одному DIMM на канал. Это не предложение поставить память в произвольные двенадцать разъёмов из шестнадцати. Подбор начинается с артикулов модулей и схемы заполнения; общий порядок объяснён в материале об установке памяти Supermicro.
Серверный предел по TDP CPU не является электрическим бюджетом всего компьютера. Два процессора, GPU, DIMM, вентиляторы и диски нагружают разные линии питания. БП выбирают по суммарному сценарию и кабельной схеме, а охлаждение проверяют при одновременной работе CPU и GPU. Перенос GPU в тесный корпус может ухудшить температуру соседних компонентов, даже если сам ускоритель не перегревается.
Как организовать программную среду без случайных результатов
В исходном кейсе использованы Proxmox и проброс GPU. Такая схема удобна для лаборатории: можно отделить рабочее окружение, зафиксировать пакеты и восстанавливать систему. Но GPU passthrough передаёт карту одной ВМ; параллельно использовать тот же физический GPU на хосте обычным способом нельзя. Для испытания непосредственно на Linux гипервизор не обязателен: выбирают ту схему, которую действительно предстоит эксплуатировать.
Для ВМ с большой моделью задают понятный объём памяти, проверяют NUMA и не рассчитывают на ballooning как на источник гарантированной ёмкости. Своп не заменяет RAM для рабочего набора: активные обращения к вытесненным страницам превращают вычислительную задачу в ожидание накопителя. Сам факт mmap-загрузки файла ещё не доказывает, что достаточная часть весов находится в быстрой памяти.
Перед сравнением сохраняют версию ik_llama.cpp или commit, версию CUDA и драйвера, точный GGUF, настройки контекста, KV-кэша, пакета и offload. Современный движок умеет подбирать размещение по доступной VRAM, но результат автоматического подбора всё равно проверяют по журналу. Не следует копировать старую команду с десятком флагов, не понимая, какие из них изменились в новой сборке.
Для первых испытаний полезен простой порядок: маленькая поддерживаемая модель для проверки GPU и API, затем целевая модель на коротком контексте, потом постепенное увеличение контекста и параллельных запросов. Если одновременно менять квант, потоковость и контекст, причину ускорения или регрессии будет невозможно определить.
Как проверить результат: программа приёмки локального ИИ-сервера
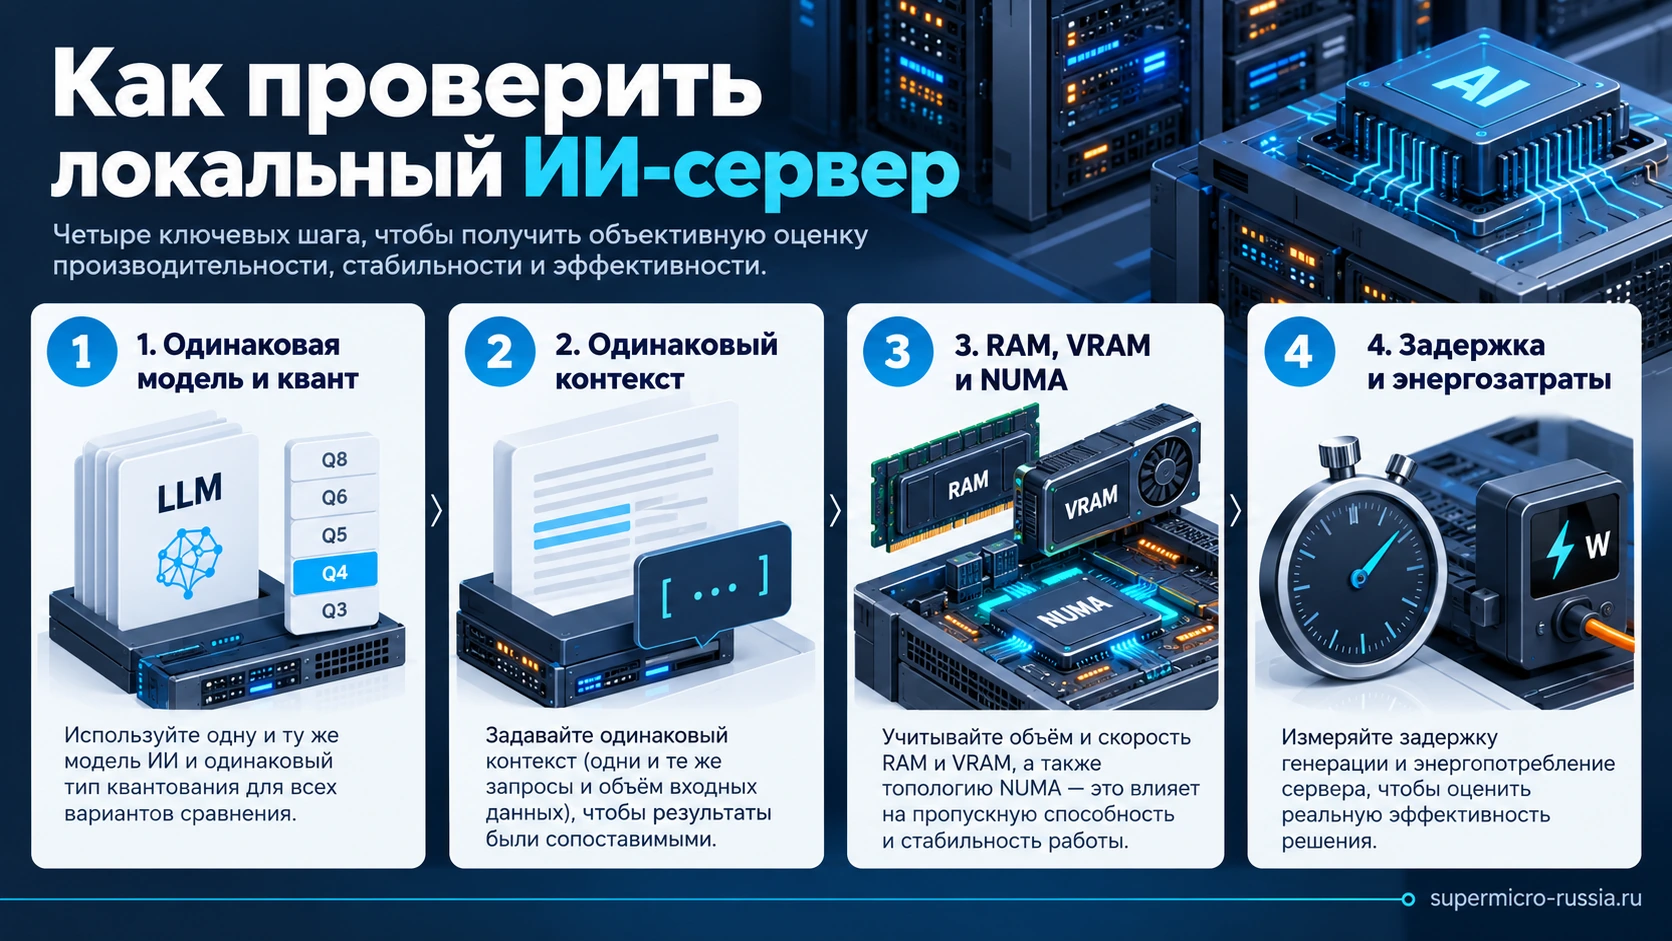
| Проверка | Что записывать | Какую ошибку помогает заметить |
|---|---|---|
| Короткий новый запрос | TTFT, generation, длина ответа | Слабая интерактивность при формально успешном запуске |
| Длинный новый контекст | Число входных токенов, prefill, пиковые RAM/VRAM | OOM и неприемлемое ожидание на больших документах |
| Повторный префикс | Кэш включён/выключен, доля повторного контекста | Сравнение прогретого режима с холодным |
| Параллельность 1, 2, 4 запроса | Задержки каждого запроса, суммарная выдача, ошибки | Подмена скорости одного пользователя общей пропускной способностью |
| Длительная нагрузка | Температуры, частоты, мощность от розетки, ошибки ECC | Троттлинг, нехватка охлаждения или питания |
| Проверка качества | Одинаковый набор задач и доля полезных ответов | Ускорение ценой неподходящего квантования или потери качества |
Не нужно делать универсальным нормативом случайные «30 токенов/с». Приёмку задают от процесса: например, редактор допускает ответ за две минуты, а оператор поддержки требует первый полезный фрагмент за несколько секунд. Это разные задания на оборудование. Для приложения с очередью полезно фиксировать не только среднее, но и 95-й процентиль задержки при заранее указанном числе запросов и времени испытания.
Выделяют и прикладной набор: ответы на вопросы по документам, извлечение полей, подготовка черновиков, работа с кодом. Модель, которая быстро пишет общий текст, может плохо справляться с нужной структурой ответа. Аппаратное сравнение без оценки качества рискует выбрать самый быстрый способ получать ненужный результат.
Что менять первым, если локальная нейросеть тормозит
Представим вполне конкретную ситуацию: модель загрузилась, ошибок памяти нет, но длинный запрос обрабатывается несколько минут. Покупка ещё одного комплекта RAM поможет только при нехватке ёмкости или неудачном заполнении каналов. Если память уже сбалансирована и рабочего объёма хватает, дополнительные гигабайты сами по себе не сократят время prefill.
Первый шаг — разделить задержку на ожидание очереди, prefill и генерацию. Второй — посмотреть загрузку CPU, GPU, объём обмена и распределение RAM. Третий — изменить один параметр: например, перенести другую часть тензоров на GPU, сократить контекст до действительно нужного объёма или сравнить число рабочих потоков. После каждого изменения повторяют один и тот же набор запросов.
Если ограничивает VRAM, переход на более ёмкую карту позволяет изменить размещение модели. Если ограничивает CPU-часть MoE, замена только GPU может дать скромный результат. Если время съедает загрузка весов при каждом старте, SSD и постоянный запущенный процесс решают другую проблему: они сокращают подготовку сервиса, но не превращают медленную генерацию в быструю.
Для разработки полезно сохранить два профиля: быстрый режим с моделью меньшего размера для отладки приложения и тяжёлый режим для проверки качества большой LLM. Так инженер не ждёт несколько минут при каждом изменении интерфейса. Сравнение качества затем проводят на одинаковом наборе заданий, чтобы более быстрый профиль не был незаметно принят за равноценную замену.
Наконец, полезна точка остановки эксперимента. Если после настройки сервер выполняет нужную задачу за допустимое время, дальнейшие расходы на ускорение лаборатории могут не окупаться. Если же приложение должно обслуживать поток активных пользователей, собранный профиль нагрузки становится техническим заданием на другую GPU-конфигурацию.
Когда старая двухсокетная платформа действительно экономит деньги
Выгода появляется, когда большая RAM нужна часто, а требования к задержке умеренные. Для эпизодической лаборатории важен стартовый бюджет. Для круглосуточного сервиса к нему добавляются энергия, охлаждение, сопровождение старой платформы и потери времени пользователей.
Простой расчёт: постоянная разница мощности 200 Вт за 365 дней даёт 0,2 × 24 × 365 = 1752 кВт·ч. При условной расчётной цене 10 рублей за кВт·ч это 17 520 рублей в год, без охлаждения и прочих расходов. Это не измеренное потребление рассматриваемой сборки и не действующий тариф — только способ сравнить две реальные сметы после замера мощности.
У Xeon Gold 6154 завершён жизненный цикл сервисных обновлений Intel. Для лабораторного применения это повод отдельно оценить доступные прошивки и режим изоляции. Для корпоративного сервиса с требованиями к сроку поддержки, обновлениям безопасности и гарантированному восстановлению новая платформа может оказаться разумнее даже при более высокой цене покупки.
Кому подходит этот кейс, а кому нужен другой сервер
Подходит: разработчикам локальных AI-сервисов, интеграторам для предварительного подбора модели, исследовательской группе, лаборатории с уже имеющейся DDR4-платформой. Полезные задачи — сравнить несколько больших квантов, отладить маршрутизацию запросов, изучить ограничения длинного контекста и получить данные для следующего этапа закупки.
Требует другой архитектуры: обслуживание многих активных пользователей с малым TTFT, обучение крупных моделей, нагрузка с жёсткой гарантией задержек, чувствительный к безопасности публичный многопользовательский сервис без ресурсов на сопровождение. Здесь рассматривают достаточный объём VRAM, современную память и платформу с понятным горизонтом поддержки. Общий подход разобран в статье о выборе инфраструктуры для ИИ под нагрузку.
Вопросы по гибридному LLM-кейсу
Может ли большая оперативная память заменить видеопамять?
Она может вместить веса, которые не вошли в VRAM, при поддержке такого режима движком. Но скорость доступа и место выполнения операций отличаются. Получается другой баланс ёмкости и задержки, а не равноценная замена GPU-памяти.
RTX 3060 или RTX 3090 — какую карту закладывать в повторение?
Начинают с объёма конкретной карты и целевого размещения тензоров. У RTX 3060 существуют варианты с 8 и 12 ГБ, поэтому одного названия недостаточно; у RTX 3090 — 24 ГБ. Далее проверяют питание, охлаждение и режим драйвера. Результаты двух этапов этого кейса не являются прямым сравнением карт при одинаковых условиях.
Нужно ли сразу устанавливать два процессора?
Если целевой рабочий набор помещается в память одного CPU и тест не выигрывает от второго, дополнительные сокет и каналы могут не окупиться. Если важны общая ёмкость и доступные линии расширения, два CPU имеют смысл. Решение принимают по измерению конкретной модели и доступности нужных слотов в выбранной конфигурации платы.
Можно ли оценить число пользователей по токенам в секунду?
По одной скорости генерации — нельзя. Нужны длины входа и выхода, интенсивность запросов, допустимая очередь, параллелизм и режим кэша. Сначала измеряют один типовой запрос, затем повторяют тот же профиль с несколькими активными клиентами.
Что этот кейс даёт перед покупкой оборудования
Архитектура на X11DPi-NT показывает рабочий путь к большим локальным моделям через серверную RAM и частичный GPU-offload. Реальные опубликованные скорости подтверждают возможность эксперимента, одновременно показывая цену длинного ответа. Следующий шаг — выбрать целевую модель и требуемую задержку, рассчитать память, затем испытать короткий и длинный контекст на одинаковых настройках.
Для подготовки комплекта передайте полный идентификатор модели, квант, максимальный контекст, число одновременных запросов и требования к TTFT. По этим данным можно сопоставить материнские платы Supermicro, память и GPU-ускорители либо обсудить конфигурацию под конкретную нагрузку. Так закупка начинается с задачи, которую сервер должен выполнить.