Терминальный сервер: как рассчитать CPU, RAM и диски на 10–100 пользователей
Сто учётных записей могут означать 45 активно работающих сотрудников, 70 подключений или иной профиль смены. CPU рассчитывают по выполняемым операциям, память — также по сохранённым сессиям и их приложениям.
Пилот показывает, сколько ресурсов занимают рабочие сессии и что происходит при утреннем входе. CPU, память и профили считают раздельно; для фермы добавляют сценарий потери узла. Числа в примерах ниже относятся к заданным профилям пользователей.
Что такое терминальный сервер и чем он отличается от VDI?
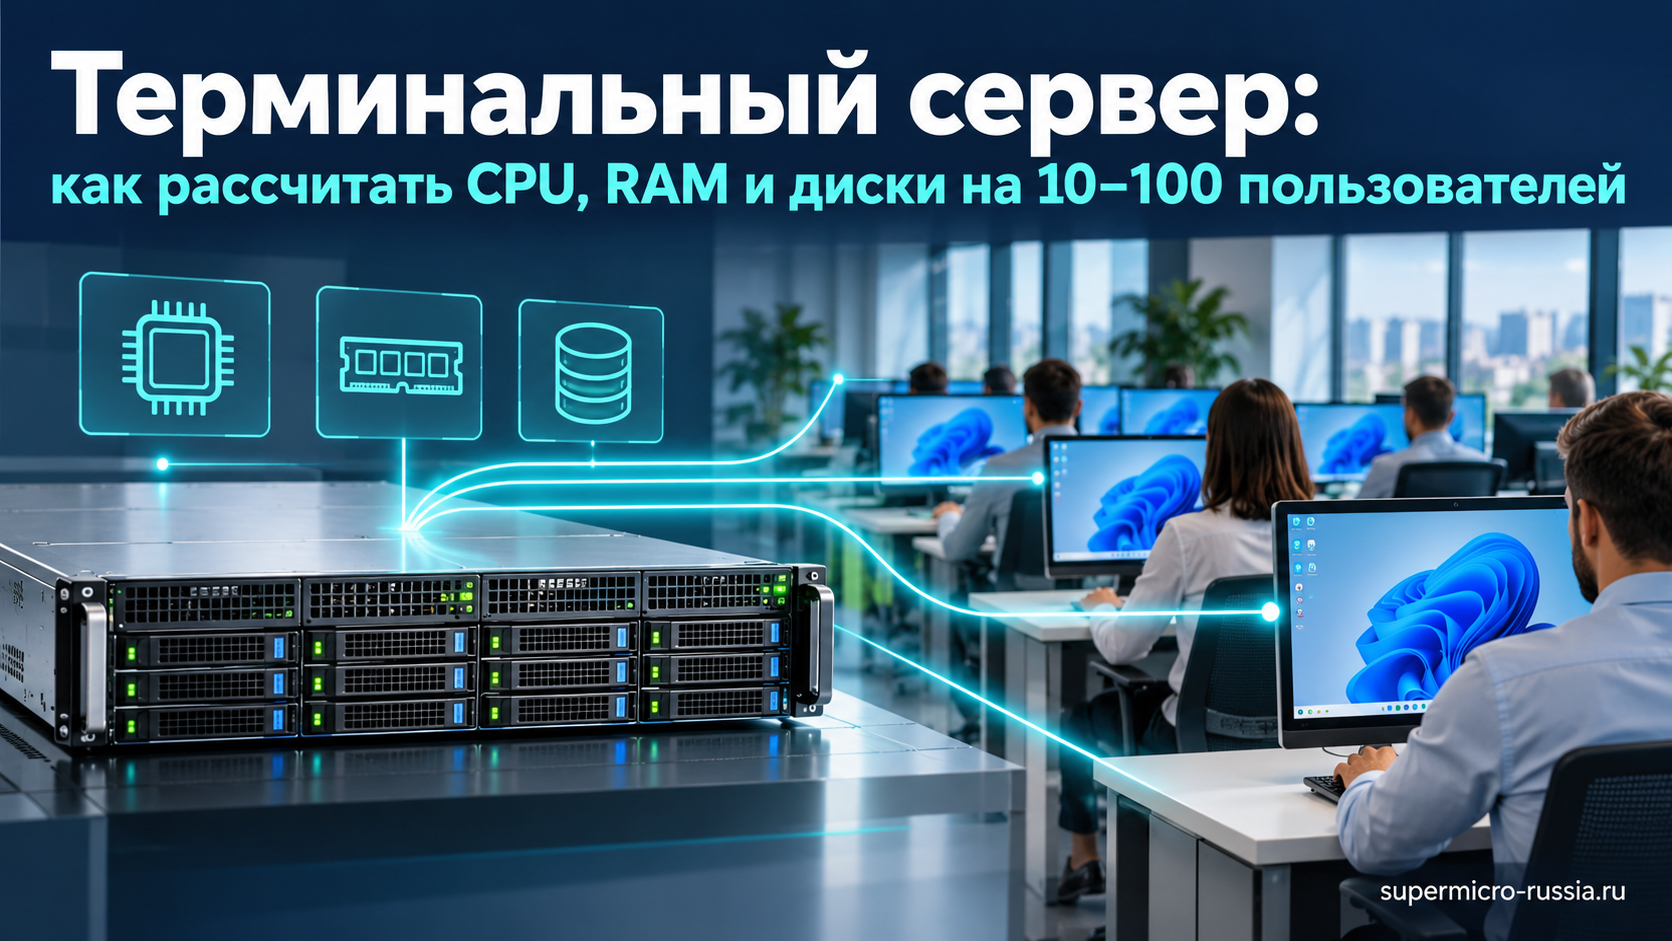
В сеансовом RDS несколько пользователей работают в одной серверной ОС, каждый со своим рабочим столом или опубликованными приложениями. Приложения исполняются на RD Session Host, а клиент передаёт ввод и получает изображение и другие разрешённые данные. Общая ОС позволяет совместно использовать часть ресурсов, но требует совместимости программ с многопользовательским режимом.
В VDI пользователь получает отдельную виртуальную машину с собственной ОС. Это даёт другую степень изоляции и управления, но добавляет накладные расходы отдельных систем. RemoteApp публикует окно приложения, а не обязательно весь рабочий стол; вычисления по-прежнему происходят на серверной стороне, если программа не использует специальную локальную разгрузку.
Расчёт общей вместимости гипервизора вынесен в материал сколько виртуальных машин выдержит сервер: двадцать ВМ и двадцать человек создают разные нагрузки.
Какие пользователи считаются активными?
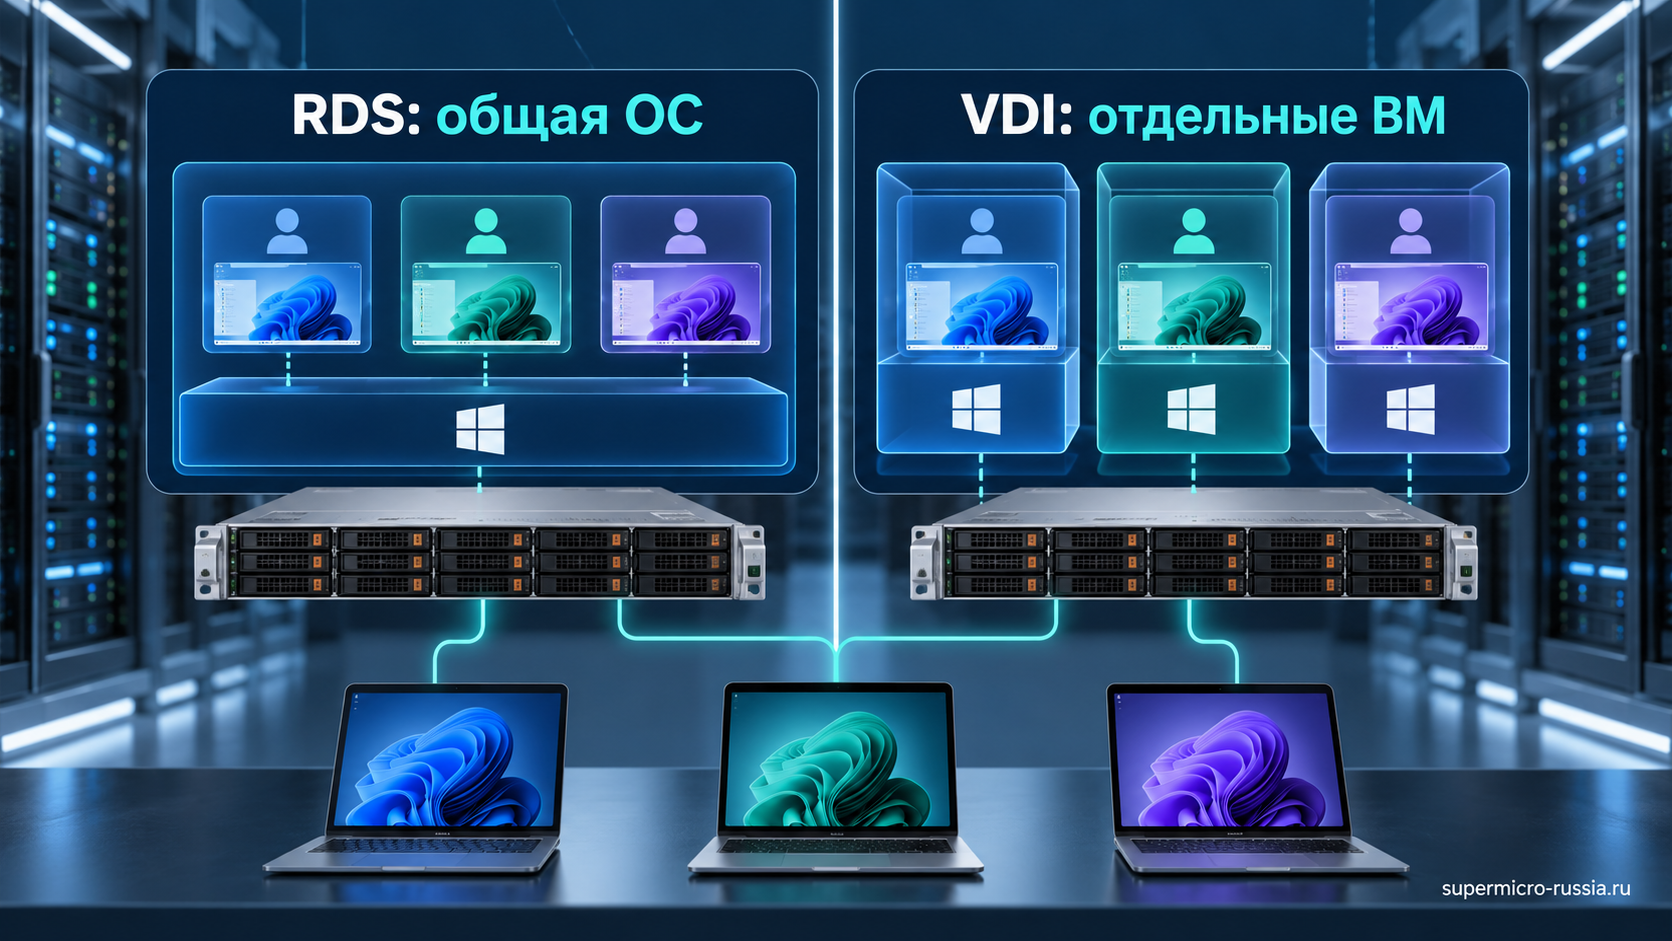
Для проектирования полезно различать три числа: всех сотрудников, одновременно подключённые сессии и людей, которые в этот момент выполняют рабочие действия. CPU в основном зависит от последнего показателя и фоновой нагрузки. RAM и профили зависят также от открытых приложений в подключённых и отключённых сессиях.
Предположим, в компании 100 сотрудников, в пиковую смену подключаются 70, а интенсивно работают 45. По CPU можно исследовать именно этот профиль одновременности. Но рассчитывать память только на 45 сессий нельзя, если остальные оставляют открытые браузеры, документы и почту. Также требуется запас на дни отчётности, замещение сотрудников и массовые задачи.
Тайм-аут отключённых сессий помогает управлять ресурсами, но его согласуют с рабочим процессом. Автоматическое завершение может закрыть несохранённый документ. Отключение экрана, разрыв RDP-соединения и выход из учётной записи — разные события. Политику фиксируют до проведения нагрузочного теста, иначе результат теста и рабочая эксплуатация будут различаться.
Какие сведения нужны для расчёта на 10, 25, 50 и 100 пользователей?
| Блок | Что собрать | Почему это важно |
|---|---|---|
| Приложения | Версии, надстройки, число одновременно открытых программ | Одинаковое название приложения не означает одинаковую нагрузку |
| Данные | Размер документов, отчётов, баз и почтовых кэшей | Память, диски, время запуска |
| Одновременность | Пиковые подключения, активные действия, график смен | CPU и ресурсы для массового входа |
| Клиенты | Разрешение, мониторы, принтеры, сканеры, аудио | Сеть, кодирование изображения, перенаправление устройств |
| Доступ | Локальная сеть, филиалы, домашние подключения | Задержки, шлюз, защита и доступность |
| Непрерывность | Допустимый перерыв, отказ одного хоста, восстановление профилей | Число узлов и резерв вычислительных ресурсов |
Как измерить CPU одной сессии без условной нормы «ядер на человека»?
На пилоте запускают повторяемый рабочий сценарий: вход, открытие приложений, документ, поиск, отчёт, печать, пауза и повтор. Измеряют нагрузку базовой системы отдельно от пользовательской. Затем постепенно добавляют сессии и фиксируют время операций, загрузку отдельных ядер и очередь процессора. Средняя загрузка за час может скрывать минутный период, когда все ждут завершения отчёта.
Для предварительной экстраполяции: C = (N × c + Cф) ÷ U. N — число моделируемых активных пользователей, c — измеренная потребность одного в эквиваленте ядра на тестовой платформе, Cф — фоновая нагрузка в тех же единицах, U — выбранный предел рабочей загрузки. Это расчётный инструмент внутри сопоставимой архитектуры; он не превращает ядра разных CPU в равные единицы.
Для учебного расчёта примем 50 активных сессий по 0,18 эквивалента физического ядра, фон в 2 ядра и предел загрузки 70%. Получится (50 × 0,18 + 2) ÷ 0,7 = 15,71. На платформе около 16 сопоставимых ядер затем проверяют реальный профиль; перед закупкой подставляют измеренные значения.
SMT/Hyper-Threading не удваивает физические вычислительные ресурсы. Нельзя считать 16 ядер и 32 потока эквивалентом 32 физических ядер. Для ВМ отдельно контролируют ожидание процессора на гипервизоре и конкурирующие машины. Дополнительные vCPU не помогают, если физический хост уже перегружен или размер ВМ плохо соответствует NUMA-топологии.
Сколько оперативной памяти нужно терминальному серверу?
Базовая модель: RAM = память ОС и служб + память пользовательских сессий + запас. На пилоте исследуют рабочие наборы, commit, доступную память и подкачку. Складывать RSS всех процессов без учёта общих страниц не всегда корректно, а смотреть только свободную RAM тоже недостаточно: файловый кэш может использовать доступное пространство с пользой.
Примем 12 ГБ на ОС и службы, 1,8 ГБ дополнительного расхода на сессию и предел заполнения RAM 80%. Для 50 пользователей: (12 + 50 × 1,8) ÷ 0,8 = 127,5 ГБ. Вариант 128 ГБ проверяют с допустимой раскладкой DIMM и реальной нагрузкой. Если расход сессии составит 2,5 ГБ, расчёт вырастет до 171,25 ГБ.
| Сессий | CPU по примеру: (N×0,18+2)/0,7 | RAM по примеру: (12+N×1,8)/0,8 | Как использовать |
|---|---|---|---|
| 10 | 5,43 эквивалента ядра | 37,5 ГБ | Кандидат около 6–8 сопоставимых ядер и 48–64 ГБ, затем пилот |
| 25 | 9,29 | 71,25 ГБ | Проверить платформу около 10–12 ядер и 96 ГБ либо следующий доступный объём |
| 50 | 15,71 | 127,5 ГБ | Испытать 16 ядер и 128 ГБ с отдельной проверкой пиков |
| 100 | 28,57 | 240 ГБ | Сравнить один крупный хост и ферму с резервом ресурсов |
Это одна математическая модель с заданными исходными условиями. Таблица не является универсальными требованиями RDS или рекомендацией конкретного артикула. Для тяжёлого браузера, CAD, отчётности и видеосвязи значения c и памяти будут другими. Допустимые объёмы модулей и заполнение каналов проверяют для выбранной платы; порядок установки разобран в статье о совместимости и установке DIMM.
Как учесть разные группы пользователей в одном расчёте?
Разделите сотрудников на группы по приложениям: оператору учётной формы, аналитику с крупными таблицами и участнику видеоконференций нужны разные профили. В пилоте измеряют долю одновременно работающих людей каждой группы.
Для смешанной группы примем 40 лёгких сессий по 1,2 GiB и 20 тяжёлых по 3 GiB. Пользовательская часть составит 108 GiB. ОС и общие расходы добавляют отдельно; в пилоте проверяют, не учтены ли совместно используемые страницы несколько раз.
С CPU нельзя так же бездумно сложить максимумы разных минут. Сохраните временные ряды, чтобы понять совпадение пиков. Если отчёты запускаются у всех ровно в 09:00, разнесение расписания может дать больше пользы, чем небольшой прирост ядер. Но аппаратный расчёт должен выдерживать согласованный рабочий процесс, а не искусственно удобное расписание, которого сотрудники не смогут придерживаться.
Почему профили пользователей нужно считать отдельно от RAM?
Дисковый размер профиля считают отдельно от памяти сессии. Настройки, файлы и кэши, включая контейнер FSLogix при его использовании, загружаются в RAM по мере обращения.
Хранилище профилей проверяют по задержкам SMB, правам, блокировкам контейнеров, повторному входу после разрыва и восстановлению данных. Его доступность рассматривают вместе с доступностью Session Host.
FSLogix: почему профиль пользователя меняет требования к серверу?
В практических разборах FSLogix профиль размещён в контейнере на файловом ресурсе и подключается при входе. Пользователь получает своё окружение на другом Session Host, но уже выполняющиеся процессы туда не переходят. Доступность самого ресурса профилей приходится обеспечивать отдельно.
В лаборатории на Windows Server 2025 отдельно показаны файловый сервер, SMB-ресурс, права и применение групповой политики. Для аппаратного расчёта важна вся эта цепочка: доступность доменных служб, файлового ресурса и сети. Быстрые локальные NVMe на Session Host не исправят недоступность хранилища профилей. Правила лицензирования FSLogix и приложений проверяют независимо от наличия RDS CAL.
Не считайте логический предельный размер контейнера уже занятой физической ёмкостью. Для динамического диска эти величины различаются, а со временем меняются из-за поведения файловой системы и обслуживания. В бюджете фиксируют текущий фактический расход, ожидаемый рост и допустимый предел. Функции уменьшения физического размера контейнера и условия их применения зависят от версии ПО и требуют отдельного теста.
Пример: 80 профилей фактически занимают в среднем 12 GB — это 960 GB. При ожидаемом приросте на пользователя 0,5 GB в месяц за полгода добавится 240 GB. Итоговый пользовательский объём — 1200 GB; при максимальном заполнении 75% требуется 1600 GB полезного пространства. Если к этому ресурсу относятся снимки и резервные копии, их место добавляют отдельно с учётом реальной технологии хранения.
Какие диски нужны и как рассчитать утренний login storm?
При массовом входе сервер одновременно читает компоненты приложений, применяет политики, открывает профили, проверяет данные защитными средствами и запускает фоновые процессы. В этот момент даже небольшое среднее потребление IOPS в течение дня не описывает требования к накопителям.
Примем 8000 операций I/O на вход пользователя. Для 50 входов за две минуты средний поток равен 50 × 8000 ÷ 120 = 3333 IOPS, при операции 16 КиБ — около 52,1 МиБ/с. В пилоте дополнительно измеряют кратковременные пики и задержку: среднее за две минуты их сглаживает.
Систему, приложения и профили размещают с учётом их конкуренции. Отдельные тома на одном массиве не означают независимые накопители. SSD выбирают по устойчивому смешанному вводу-выводу, задержкам и ресурсу записи, а не только по рекламному последовательному чтению. Файл подкачки не заменяет достаточную RAM: постоянное обращение к нему может ухудшить интерактивный отклик.
Как избежать узкого места при одновременном подключении профилей?
Установившаяся работа подключённых профилей не показывает нагрузку массового входа. Кроме всплеска небольших I/O и открытий файлов, проверьте совместимость схемы контейнеров: другую систему пользовательских дисков для тех же профилей без проверки не добавляют.
Измерьте время входа по этапам: аутентификация, политика, подключение контейнера, подготовка рабочего стола, запуск приложения. Если 20 секунд занимают политики и 2 секунды — хранилище, замена SSD не сократит всё время в десять раз. При большом входном пике анализируют очереди, задержки SMB, антивирусную обработку и сетевые ошибки. Исключения для средств защиты согласуют по требованиям используемого ПО, а не отключают защиту целиком.
Нагрузочный тест должен включать новый профиль, уже большой профиль и восстановление доступа после краткого сетевого сбоя. Сценарий первого входа с пустым контейнером не представляет пользователя с большим почтовым кэшем и сотнями настроек. Проверьте также освобождение блокировок и повторный вход после аварийного завершения Session Host.
Нужен ли GPU терминальному серверу?
Для обычных форм и текста иногда достаточно CPU, но браузеры, несколько мониторов высокого разрешения, графические приложения и видеосвязь меняют картину. GPU может ускорять графику или кодирование изображения при поддержке ОС, драйвера и выбранной архитектуры. Его наличие ещё не гарантирует, что каждая сессия использует нужный аппаратный путь.
Для VDI дополнительно проверяют PCIe passthrough либо виртуализацию GPU, совместимость гипервизора, профили памяти и лицензирование соответствующего решения. Для сеансового RDS — поддержку многопользовательской работы приложением и драйвером. Объём VRAM делят исходя из проверенной конфигурации, а не из универсальной нормы «один гигабайт на пользователя».
Сеть, филиалы и домашние подключения
Трафик зависит от изображения, активности экрана, разрешения, числа мониторов, кодирования, аудио, видео и перенаправления устройств. Статичная учётная форма и прокрутка видеоматериалов не должны иметь одну расчётную норму. Для филиала дополнительно учитывают печать, загрузку файлов и другие сервисы в том же канале.
При условных 2 Мбит/с на активную сессию 50 пользователей требуют 100 Мбит/с, с запасом 30% — 130 Мбит/с. Вместе с полосой проверяют RTT, потери и колебания задержки: канал 200 Мбит/с с нестабильным откликом может работать хуже более узкого устойчивого соединения.
Обмен Session Host с сервером приложений, базой данных и хранилищем профилей считают отдельно от пользовательского RDP. Длинный путь до СУБД может увеличивать время каждой операции, хотя сам удалённый рабочий стол реагирует быстро. Для нагрузки 1С подробности серверной части вынесены в руководство по подбору сервера для 1С.
Видеоконференции требуют отдельного решения. Возможность перенести обработку мультимедиа на клиент зависит от приложения, версии клиента, платформы удалённого доступа и настроек. Нельзя предполагать, что видеозвонок всегда обрабатывается локально, или автоматически закладывать GPU на сервер без проверки поддерживаемого пути. Пилот включает реальное подключение камеры, микрофона, гарнитуры и нескольких экранов.
Проверьте вход в сеанс после краткого обрыва, переподключение к существующей сессии, поведение печати и сохранение открытого документа. Для каждой группы задают приемлемое время входа и отклик конкретной операции. Подключённая, но неработоспособная сессия не считается успешной.
Один большой сервер или несколько RD Session Host?
Один хост проще в начальном развёртывании, но его обслуживание прерывает все сессии. Ферма позволяет распределять подключения, обновлять узлы по очереди и отделять группы приложений. Взамен появляются Broker, общие профили, дополнительные зависимости и требования к резервированию.
В практическом развёртывании Labs Hands On на Windows Server 2025 показаны два Session Host, отдельный Connection Broker с Web Access и доменная инфраструктура. Два тестовых пользователя попадают на разные хосты; затем проверяются параметры коллекции. Это наглядная проверка распределения подключений, но не нагрузочный тест на десятки сотрудников и не доказательство непрерывности сессий при аппаратном отказе.
«В этой части среда не будет открыта в интернет».
Викас Сингх, Labs Hands On, перевод пояснения о границах внутренней лаборатории RDS.
Для производственного внешнего доступа отдельно проектируют шлюз или другой управляемый защищённый способ доступа, сертификаты, многофакторную аутентификацию и ограничения. Открывать административный RDP напрямую в интернет по аналогии с внутренней лабораторией не следует. В коротком объяснении Cubit Technology полезно показана другая сторона RDS: приложения администрируются централизованно, а клиент получает удалённую рабочую среду. Но это удобство не отменяет расчёт серверных ресурсов и защиты.
Как посчитать резерв N+1 и что произойдёт с сессиями при отказе?
Для k одинаковых узлов с допустимой нагрузкой L на каждый общая вместимость после потери одного — не более (k−1) × L. Если один хост испытан на 40 рабочих сессиях, три хоста дают 120 мест в нормальном режиме, но только 80 при отказе одного. Для 100 одновременно работающих сотрудников этого недостаточно.
Если два узла обычно делят 100 пользователей поровну, после отказа одного оставшийся должен принять все 100 — при таком аварийном требовании. Если его вместимости недостаточно, добавляют узел или заранее согласуют сокращённый режим.
Распределение новых подключений не переносит память работающей сессии с физически отказавшего хоста на другой. Пользователь может переподключиться и снова открыть приложения, но несохранённые данные способны потеряться. Также резервируют Broker, зависимые службы и хранение, если они входят в заданную цель доступности. Отказоустойчивость пользовательского сервиса проверяют целиком.
Как считать терминальную ферму с обслуживанием и отказом?
Резерв N+1 обычно описывает одну потерянную единицу. Если один сервер уже выведен на обслуживание, а затем отказал второй, это другое условие. Необходимо заранее определить допустимый режим: вся работа без деградации, сокращённое число пользователей или приостановка некритичных задач.
Пусть один проверенный хост обслуживает 35 пользователей выбранного профиля. Четыре хоста дают 140 мест штатно и 105 после потери одного. Но при одном хосте на обслуживании и отказе второго остаётся 70 мест. Для требования «100 пользователей и две одновременно недоступные машины» при том же профиле нужно не менее пяти хостов: три оставшихся дадут 105 мест. Эти числа действуют только при подтверждённой вместимости каждого узла и доступности общих служб.
Перед обслуживанием хост закрывают для новых подключений и согласуют завершение действующих сессий. Профили должны оставаться доступны на других узлах; их вместимость проверяют с учётом этой дополнительной нагрузки.
Матрица совместимости терминального решения
| Компонент | Обязательная проверка | Типичная проблема |
|---|---|---|
| Приложение | Поддержка Windows Server и нескольких пользователей | Программа рассчитана на единственную локальную сессию |
| Офисные и отраслевые лицензии | Разрешённый способ использования в RDS | Обычная установка не соответствует условиям многопользовательского доступа |
| Клиент и периферия | Принтер, сканер, USB-ключ, аудио, несколько мониторов | Подключение работает, нужное устройство — нет |
| Профили | Поддержка выбранного решения, права и восстановление | Медленный вход, временный профиль, блокировка контейнера |
| GPU | ОС, драйвер, приложение, режим совместного доступа | Устройство установлено, ускорение не используется |
| Сервер | CPU, память, сетевые и дисковые драйверы, поддержка ОС | Расчёт ресурсов верен, но нет поддерживаемого программного пути |
Для RDS проверяют Windows Server, базовые права доступа и RDS CAL подходящей версии и модели Per User/Per Device. Количество одновременно активных сессий используют для расчёта железа, но оно не заменяет правила лицензирования пользователей или устройств. Права на приложения проверяют отдельно. Льготный период развёртывания не является постоянным рабочим решением.
Какой сервер Supermicro подойдёт под рассчитанную нагрузку?
После пилота выбирают платформу с требуемой производительностью ядра, общим CPU-бюджетом и подходящей памятью. Если достаточно одного сокета, он может упростить NUMA и эксплуатацию. Если нужны большая память, расширение и несколько ускорителей, изучают другие платформы. Количество сокетов не является самостоятельным показателем качества RDS.
В готовых серверах сравнивают полный состав, а в серверных платформах проверяют допустимые CPU, DIMM, контроллеры, отсеки и охлаждение. Для фермы удобнее несколько предсказуемо одинаковых хостов, чем набор машин с резко различающейся вместимостью без настройки распределения.
Если сервер стоит рядом с сотрудниками, дополнительно оценивают шум оборудования в офисе, питание и обслуживание. Эти условия могут сделать компактную тихую платформу предпочтительнее плотного стоечного сервера, даже если обе удовлетворяют вычислительному расчёту.
После пилота каталог Supermicro можно использовать для отбора платформ под измеренный профиль. В заказе нужны требования к отклику, памяти, расширению и аварийному режиму, а не только число сотрудников.
Как провести пилот терминального сервера до массового перехода?
Пилот заканчивается списком проверенных приложений и ограничений, а не только графиком загрузки процессора. В него входят версии ПО, драйверы перенаправления, режим профилей, политики сессий и способ восстановления. Затем масштабируют измеренные профили и повторно проверяют наиболее тяжёлое сочетание действий.
Какие счётчики собирать в пилоте RDS?
| Измерение | Какой вопрос решает | Частая ошибка |
|---|---|---|
| CPU и очередь выполнения | Хватает ли вычислительного ресурса при одновременной работе | Смотреть среднее за сутки вместо пика |
| Commit, доступная RAM, paging | Укладываются ли приложения и сохранённые сессии в память | Считать любой page fault обращением к файлу подкачки |
| Задержка дисков и SMB | Где ждут профили и приложения | Оценивать только MB/s |
| Время входа и старта приложения | Что фактически ощущает пользователь | Считать появление RDP-окна успешным входом |
| RTT, потери, транспорт и переподключения | Подходит ли реальный путь филиала | Проверять только локальную сеть |
Объедините метрики общей шкалой времени. Тогда всплеск входов, задержка профилей и CPU-пик можно сопоставить с пользовательскими жалобами. Сохраните версии приложений и драйверов: обновление браузера, антивируса или офисного пакета способно изменить профиль без добавления сотрудников.
Как принять терминальный сервер по результатам теста?
| Проверка | Что фиксировать | Пример проектного критерия |
|---|---|---|
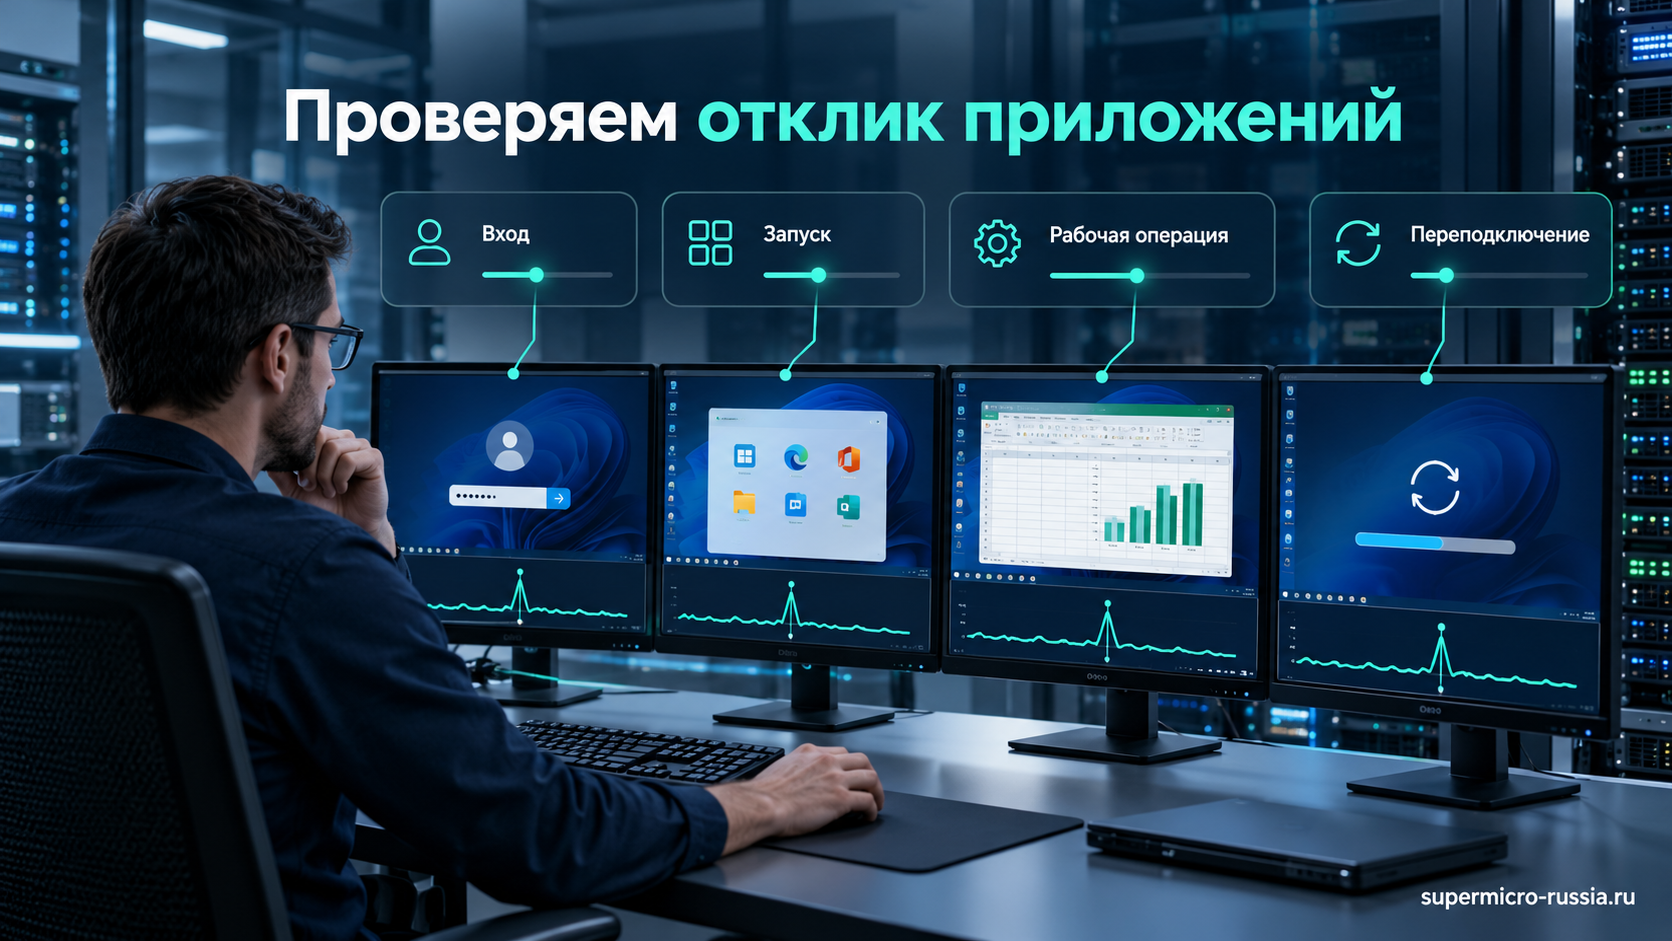
| Вход | Время от подключения до готовности рабочего стола | p95 не более 30 секунд при согласованном массовом входе |
| Запуск приложения | Первый и повторный запуск | p95 не более 10 секунд для выбранной программы |
| Рабочая операция | Открытие документа, поиск, сохранение | p95 не более 2 секунд для заранее описанной операции |
| Пиковая нагрузка | CPU, отдельные ядра, память, paging, диски, сеть | Нет длительных очередей и выхода за проектный резерв |
| Разрыв связи | Повторный вход, профиль, состояние приложений | Восстановление доступа по согласованной политике |
| Отказ хоста | Вместимость оставшихся узлов и время возврата доступа | Соответствие заранее принятому аварийному сценарию |
| Профили и данные | Тест восстановления на отдельном ресурсе | Открываются профиль и контрольные документы |
Последняя колонка содержит пример согласуемых критериев. Для CAD и длительного отчёта задают другие значения. При p95 = 2 с примерно 95% измеренных операций укладываются в две секунды; оставшиеся медленные сессии анализируют отдельно.
Нагрузку наращивают ступенями и проверяют повторяемость. Во время теста оставляют предусмотренные антивирус, политики, мониторинг и фоновые задания: отключение рабочих средств ради красивого результата делает приёмку непоказательной. После изменения приложений или крупного обновления повторяют затронутые сценарии.
Частые вопросы о требованиях терминального сервера
Можно ли держать СУБД и RDS на одном хосте?
Технически это зависит от ПО и архитектуры. Но ресурсы двух ролей считают вместе и тестируют одновременные пики. Виртуальные машины на одном физическом сервере изолируют ОС, но не создают независимый запас CPU, памяти и накопителей.
FSLogix заменяет резервное копирование профилей?
Нет. Контейнер организует хранение профиля, но его можно удалить или повредить. Нужны согласованная защита хранилища и проверенный возврат пользовательских данных.